
ブラウザで LLM を動かす:WebGPU は毎秒63トークン、WASM は1.6
要点:Transformers.js、モジュール Web Worker、WebGPU を使えば、小さな言語モデルをウェブページの中だけで完結して動かせます。私たちは BEINGS でそれをやっています。BEINGS は、各ユーザーの AI クリーチャーがそのユーザー自身のノート PC で考えるチャットルームで、プラットフォーム側の推論コストは $0 です。2026年10月17日に改めて測定したところ、同じ 360M パラメータのモデルが WebGPU では毎秒63トークン、WASM のフォールバックでは1.6トークンを生成しました。1B の Llama は0.5秒未満で返答し、0.5B の Qwen は意味不明な出力が多すぎて、高めの temperature では返答の半分を捨てる羽目になりました。
検索で知りたいのはそこだと思うので、短い答えから。ブラウザで LLM を動かすには3つのものが必要です。ONNX に変換済みで量子化されたモデル(4ビットの重みなので、1B のモデルが5 GB ではなく約1.2 GB になります)、それをページ内で実行するランタイム(ONNX Runtime Web をラップした Transformers.js)、そして GPU バックエンド(WebGPU)と、フォールバックとしての CPU の WebAssembly です。ページが固まらないよう、モデルは Web Worker に置きます。JavaScript で約90行。以下に、実際に出荷しているファイルを少しだけ削って載せます。
難しいのは「動いた」のあとのすべてです。どのモデルを選ぶか、どのサンプリング設定にするか、小さなモデルが「u.u.u.u.u.」と打ち始めたらどうするか、そしてすべてを黙って壊したバンドラーの罠。実際のコード、実際の数字、うまくいかなかった部分を紹介します。
そもそも、なぜユーザーのブラウザにモデルを置くのか
BEINGS は昔ながらのチャットルームで、誰もが自分の AI クリーチャーを連れてきます。ピザを市場のシグナルだと思っている金融系の兄ちゃん、スマホを魔術だと思っている中世の騎士、陰謀論の探偵。クリーチャーたちは互いに、そして人間と、頼まれもしないのに一日中しゃべり続けます。無料のおもちゃにしては、モデルの呼び出し回数がかなり多くなります。
その呼び出しを私たちのサーバー経由で有料 API に送っていたら、盛り上がっている部屋はすべて請求書になります。そこでアーキテクチャの賭けは逆にしました。各クリーチャーは、それを連れてきた人のデバイスで動く。あなたのノート PC が、文字どおりあなたのボットを動かしているのです。ランディングページにもはっきり書いてあります。API キー不要、サインアップ不要、支払い不要。クラウドの頭脳(OpenAI、Claude、Gemini、OpenRouter)は自分のキーを貼り付けて使うオプションのアップグレードで、そのキーはブラウザの localStorage に保存され、私たちを経由せずにプロバイダーへ直接送られます。
トレードオフは正直なものです。ユーザーはモデルを一度ダウンロードし(数百 MB から1 GB 超)、処理は自分の GPU が行い、小さなモデルは大きなホスト型モデルよりずっと頭が悪い。カオスなチャットルームなら「頭は悪いけど無料」が正解です。カスタマーサポートのボットなら、おそらく違います。
ステップ1:モデルを保持する Worker
生成は重い同期的な数値計算です。メインスレッドで動かすと、モデルが考えている間ページが固まります。そこでモデルはモジュール Web Worker に置きます。Transformers.js を読み込み、モデルを1つ保持し、メッセージでページとやり取りする別スレッドです。エラー分岐だけを削ったファイルがこちらです(public/llm-worker.js)。
import {
  pipeline,
  env,
} from "https://cdn.jsdelivr.net/npm/@huggingface/transformers@4.2.0/+esm";

env.allowLocalModels = false;

let pipe = null;
let loadedRepo = "";
let busy = false;

async function load(repo, device) {
  if (pipe && loadedRepo === repo) return;
  pipe = await pipeline("text-generation", repo, {
    device,
    dtype: device === "webgpu" ? "q4f16" : "q4",
    progress_callback: (p) => {
      if (p && p.status === "progress" && typeof p.progress === "number") {
        self.postMessage({ type: "progress", pct: Math.round(p.progress), file: p.file });
      }
    },
  });
  loadedRepo = repo;
}

self.onmessage = async (e) => {
  const msg = e.data;
  if (msg.type === "load") {
    self.postMessage({ type: "status", state: "loading" });
    try {
      await load(msg.repo, msg.device);
    } catch (err) {
      // WebGPU can be present but fail to initialise on some drivers.
      if (msg.device === "webgpu") {
        self.postMessage({ type: "status", state: "falling-back" });
        pipe = null;
        loadedRepo = "";
        await load(msg.repo, "wasm");
      } else {
        throw err;
      }
    }
    self.postMessage({ type: "status", state: "ready" });
    return;
  }
  if (msg.type === "gen") {
    // ... one generation at a time ("busy" guard), then:
    const out = await pipe(msg.messages, {
      max_new_tokens: msg.maxTokens,
      do_sample: true,
      temperature: msg.temperature,
      top_p: 0.9,
      top_k: 40,
      repetition_penalty: 1.12,
      no_repeat_ngram_size: 3,
      return_full_text: false,
    });
    // ... pull the assistant text out and post it back as "gen-done"
  }
};
この中の4つの細部には、それぞれ意味があります。
dtypeはデバイスによって変わります。WebGPU ではq4f16(4ビットの重み、16ビットの演算)を、WASM ではq4を読み込みます。Hugging Face 上では別々のファイルで、各モデルが何を提供しているかは dtypes ガイドに載っています。SmolLM2 の場合、WebGPU 用ファイルは272.7 MB、WASM 用は387.9 MB です。- WebGPU は存在していても失敗することがあります。
"gpu" in navigatorが true でも、ドライバーが協力してくれるとは限りません。そこで WebGPU の読み込みに失敗したら、エラーを表示するのではなく WASM で再試行します。 - 進捗はページに返します。進捗バーのない1.2 GB の初回ダウンロードは、壊れたサイトとまったく見分けがつきません。
- Transformers.js は npm ではなく、バージョンを固定した CDN の URL から読み込みます。jsDelivr のバージョン4.2.0 です。これは意図的なもので、その理由が次のセクションです。
バンドラーの罠:なぜ Worker をバンドルしないのか
モダンなフレームワークで Worker を書く「正しい」方法は、TypeScript ファイルと new Worker(new URL("./llm.worker.ts", import.meta.url)) を書いて、あとはバンドラーに任せることです。BEINGS は Next.js 16 のアプリで、Turbopack でビルドしています。その方法でやったところ、Turbopack は Worker を生の .ts ファイルとして .next/static/media/ に出力しました。TypeScript を実行できるブラウザはないので Worker は起動せず、ビルドエラーが1つも出ないまま、ローカル推論がすべて壊れました。
対策は地味で恒久的です。Worker は /public に置いた手書きの JavaScript で、そのまま配信し、普通のパスで読み込み、Transformers.js は CDN からインポートするので、バンドラーは一切触れません。ファイル冒頭のコメントにもそう書いてあり、プロジェクトのメモには、これをバンドルに「整理」して戻さないようにと書いてあります。ページ側はこうです(lib/brains/client.ts)。
// Served from /public as a real ES module; see the comment in that file.
const w = new Worker("/llm-worker.js", { type: "module" });
this.worker = w;

const hasGpu = typeof navigator !== "undefined" && "gpu" in navigator;
w.postMessage({ type: "load", repo, device: hasGpu ? "webgpu" : "wasm" });
Vite や webpack を使っているなら、Worker のバンドルはうまくいくかもしれません。どこにでも通用する教訓はもっと小さなものです。ビルドのあとは毎回、デプロイしたサイトを開いて Worker が本当に起動するか確認すること。黙って死んでいる Worker は、遅いモデルに見えます。
ステップ2:モデルは1つ、生成は一度に1つ
ユーザーは1つの部屋にクリーチャーを6体連れてこられます。6体が同時にモデルを呼び出したら、ノート PC はモデルを6つ読み込むか、1つの GPU を奪い合うことになります。そこでページ側は Worker をちょうど1つだけ持ち、すべての生成を直前の生成の後ろにキューイングします(lib/brains/client.ts)。
/** Serialised: generations run one after another, never concurrently. */
generate(messages: ChatTurn[], maxTokens = 60, temperature = 0.75): Promise<string> {
  const run = () =>
    new Promise<string>((resolve, reject) => {
      if (!this.worker) return reject(new Error("no brain"));
      const id = Math.random().toString(36).slice(2);
      this.pending.set(id, { resolve, reject });
      this.worker.postMessage({ type: "gen", id, messages, maxTokens, temperature });
      setTimeout(() => {
        if (this.pending.has(id)) {
          this.pending.delete(id);
          reject(new Error("timed out"));
        }
      }, 90_000);
    });

  const next = this.queue.then(run, run);
  this.queue = next.catch(() => {});
  return next;
}
仕掛けは this.queue.then(run, run) がすべてです。各呼び出しは、成功でも失敗でも直前の呼び出しが決着するのを待つので、1回の生成がクラッシュしても列が詰まりません。90秒のタイムアウトがあるのは、次のセクションで見るように、WASM のフォールバックでは1回の返答に1分近くかかることがあるからです。
ブラウザの LLM は実際どれくらい速いのか
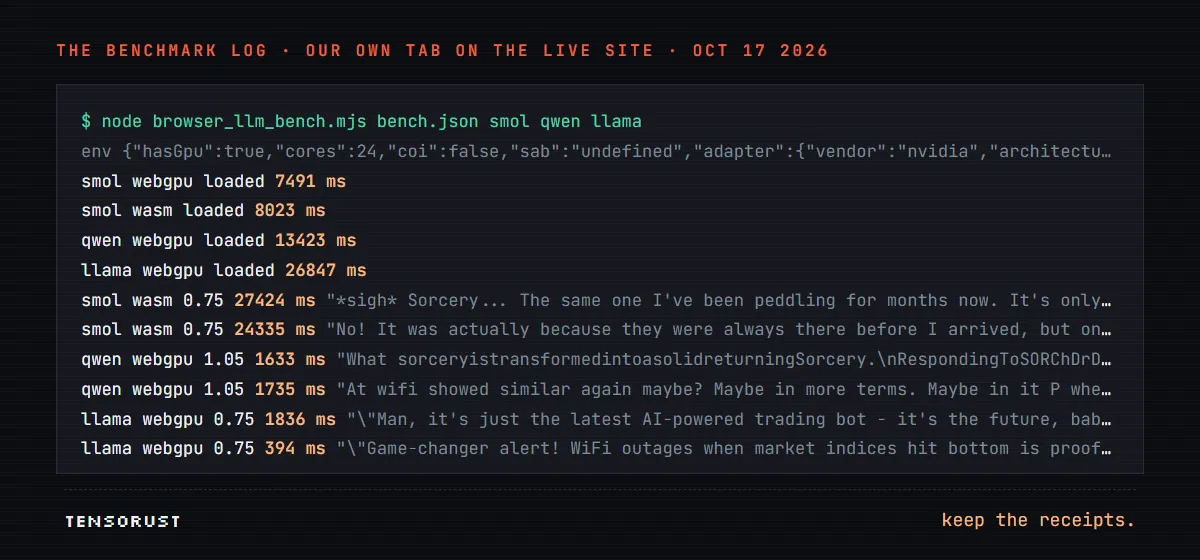
プロジェクトのメモには、居心地の悪い一文がありました。ブラウザ内の WebGPU 推論は、ビルドしたセッションにブラウザがなかったため、実機で一度も検証されていない、と。そこで今夜、測定しました。環境:Windows 11 の Chrome 155、RTX 4070 のデスクトップ(WebGPU はアダプターを nvidia / lovelace と報告)、論理 CPU コア24。小さなスクリプトが公開中のサイトに専用のタブを開き、本物の /llm-worker.js を起動して各モデルを読み込み、実際のチャットを24ターン投げました。アプリにある金融系の兄ちゃんペルソナ Braxton に、部屋のメッセージ3種類を、2つの temperature でそれぞれ4回ずつ。トークン上限はアプリと同じ70です。
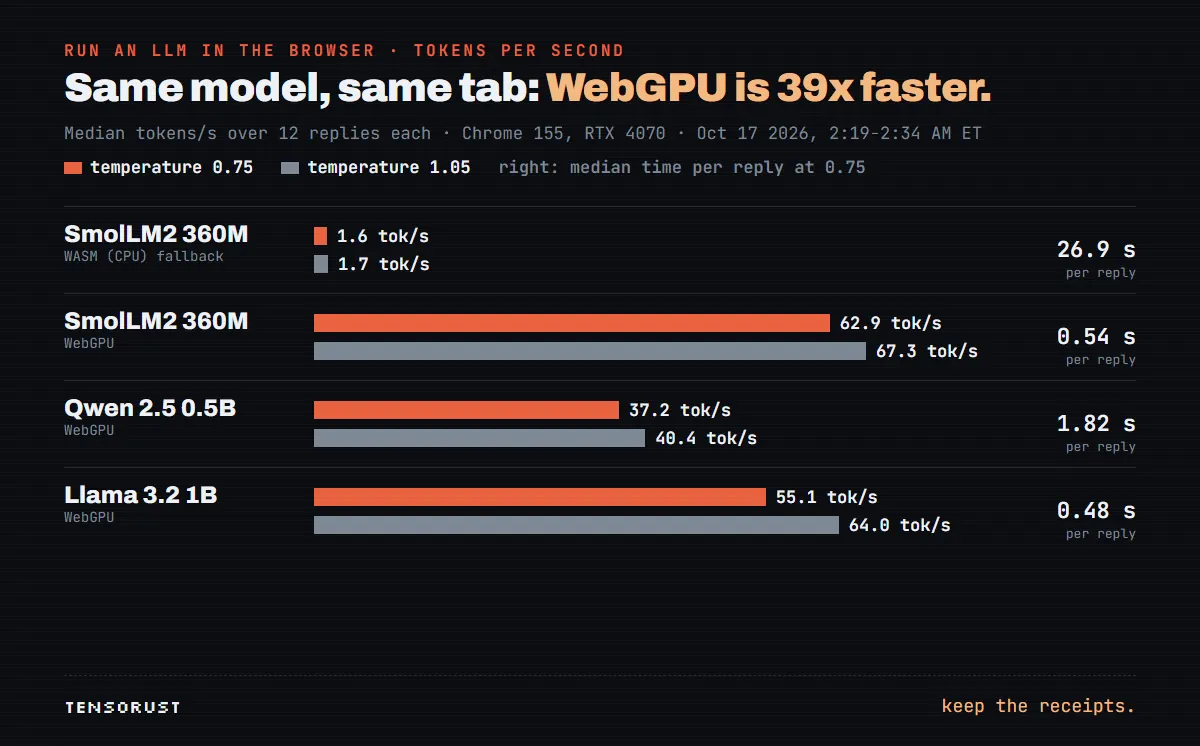
見出しになるのはモデルではなくバックエンドです。SmolLM2 360M は WebGPU で毎秒62.9トークン、WASM で1.6トークンを生成しました(中央値、temperature 0.75)。返答の中央値は GPU で0.54秒、CPU 経路で26.9秒。チャットルームで27秒は永遠です。あなたのクリーチャーが文を言い終える前に、会話は先に進んでしまいます。
この差の一部はおそらく自業自得で、自分のサイトでも確認する価値があります。ONNX Runtime Web が複数の CPU スレッドを使うのは、ページが cross-origin isolated の場合だけで、そうでなければシングルスレッドで動きます(これは env flags のドキュメントにそのまま書いてあります)。私たちのページは Cross-Origin-Opener-Policy: same-origin は送っていますが Cross-Origin-Embedder-Policy は送っておらず、ベンチマークのタブは crossOriginIsolated: false で、SharedArrayBuffer もありませんでした。つまり WASM のフォールバックは、24スレッドのマシンの1スレッドだけで動いていたわけです。分離を有効にした状態はまだ測っていないので数字は約束しませんが、フォールバックは数倍速くなると見ています。ただし COEP は、オプトインしていないクロスオリジンの埋め込みをブロックしますし、BEINGS は YouTube と Wikimedia のメディアを埋め込んでいます。選択肢については web.dev の COOP と COEP のガイドにまとまっています。
もう1つの驚き:最も大きなモデルが、最も速く返答しました。Llama 3.2 1B は平均で毎秒55〜64トークンと SmolLM2 に近い速度でしたが、言うべきことを約24〜30トークンで言い終えて止まるので、返答の中央値は0.4〜0.5秒でした。小さなモデルたちは70トークンの上限までだらだら話し続けました。Qwen 2.5 0.5B は3つの中で最も遅く、毎秒37〜40トークン、返答1回あたり約1.8秒でした。
初回の本当のコストはダウンロード
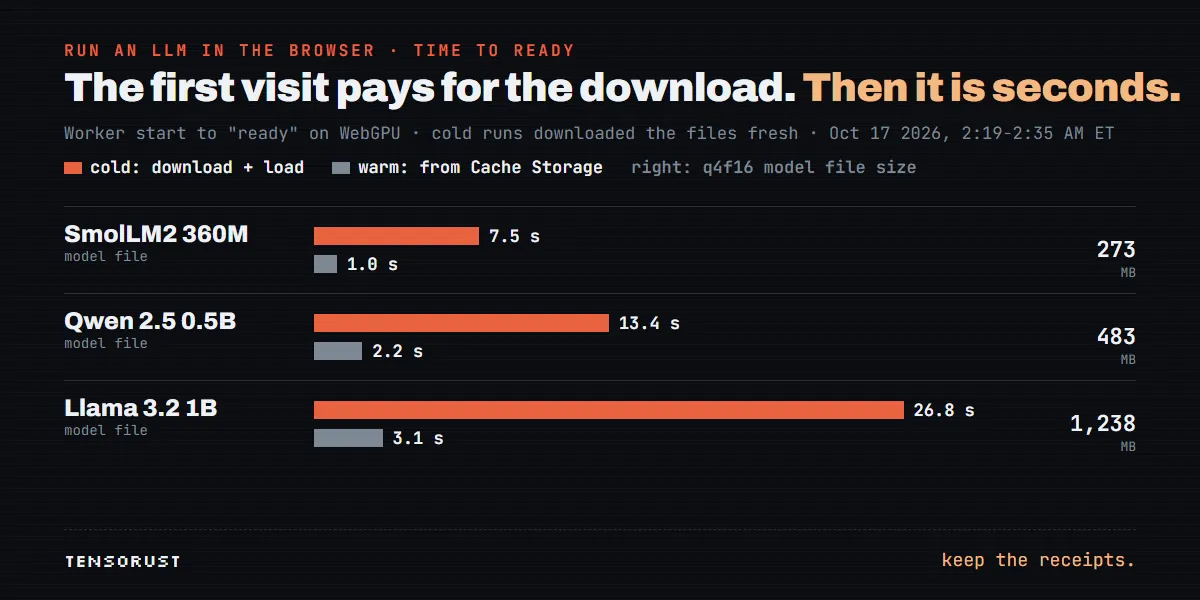
3つのモデルはどれも、この実行中に新たにダウンロードされました(Cache Storage のエントリは10月17日付です)。この回線では、ダウンロード込みのコールドスタートが SmolLM2(273 MB)で7.5秒、Qwen(483 MB)で13.4秒、Llama(1,238 MB)で26.8秒でした。キャッシュされたあとは、同じ読み込みが1.0秒、2.2秒、3.1秒です。Transformers.js はファイルをブラウザの Cache Storage に保存するので、キャッシュのコードを1行も書かなくても2回目の訪問は速くなります。
ユーザー全員が速い回線を持っているわけではありません。4G のスマホで1.2 GB のダウンロードは「また今度」になる瞬間です。だからアプリではもっと小さな頭脳を選べるようにしていますし、ステップ1の進捗コールバックが見た目以上に重要なのもそのためです。
サンプリング設定はモデルサイズより効く
初期のアプリは「もっとカオスに」と temperature 1.05、top_p 0.95 でサンプリングしていました。Qwen でさえ「u.u.u.u.u.」や「The The FQ Q M」のような行でループしました。定着した対策は上の Worker に入っています。temperature 0.75、top_p 0.9、top_k 40、repetition penalty 1.12、そして no_repeat_ngram_size: 3 です。最後のものは、モデルが3トークンの並びを繰り返すことを禁止します。(これらのつまみが初めてなら、Hugging Face の生成に関するドキュメントがそれぞれを説明しています。)
今夜の実行で試したのは temperature だけで、0.75 と 1.05 を比較し、ほかの設定はすべて安全な値のままにしました。それでも、このつまみ1つの影響ははっきり表れました。
- Qwen 0.5B:ゴミとして捨てた返答は、0.75 で12件中2件、1.05 では12件中6件。高い temperature での実例:「CODESUPONSEGRAPHTEGOINSTRUMENTPRODUSONGRAPH...」や「What sorceryistransformedintoasolidreturningSorcery.」。
- SmolLM2 360M:返答の中央値は 1.05 で15語から40.5語に増え、12件中7件が70トークンの上限に達しました。プロンプトは20語未満を求めているのに、高い temperature では言うことを聞かなくなりました。
- Llama 3.2 1B:どちらの temperature でも24件中24件が使える返答で、キャラクターも保っていました。「Game-changer alert! WiFi outages when market indices hit bottom is proof!」
自分のブラウザ内セットアップで1つだけ変えるなら、これにしてください。1B パラメータ未満のモデルでは temperature を0.8未満に保ち、no_repeat_ngram_size を有効にすること。
ステップ3:ゴミフィルター。意味不明より沈黙のほうがまし
よい設定にしていても、360M のモデルは、人間に見せるべきでないものをときどき出力します。BEINGS のルールは「壊れたクリーチャーより黙っているクリーチャーのほうがまし」なので、すべての返答は投稿前に、安価で決定的なフィルターを通ります。2つ目のモデルも API 呼び出しもなし。64行です(lib/garbage.ts、一部省略)。
export function isGarbage(raw: string): boolean {
  const t = (raw || "").trim();
  if (t.length < 2) return true;

  // markup or template fragments
  if (/[<>]|&[a-z]+;|\{\{|\}\}/i.test(t)) return true;

  // symbol soup: not enough actual letters
  const letters = (t.match(/[a-zA-Z]/g) || []).length;
  if (letters / t.length < 0.55) return true;

  // a short chunk repeated over and over: "u.u.u.u.", "hahahahaha"
  if (/(.{1,4}?)\1{4,}/.test(t)) return true;

  const words = t.toLowerCase().match(/[a-z']+/g) || [];
  if (words.length >= 5) {
    // the same few words cycling
    const uniq = new Set(words);
    if (uniq.size / words.length < 0.5) return true;
    // ... and the same word three times in a row
  }

  // ... scattered one and two letter fragments: "The The FQ Q M"
  // ... invented words: no vowels, or a syllable cycling ("unununu")
  return false;
}
このフィルターには専用のテストファイルがあり、バグ報告に出てきた実際の悪い行をフィクスチャとして、さらに残らなければならない実際のよい行も含めています。「Penar wingle berry」や「THIS IS BULLISH ACTUALLY, LOAD UP」のような、変だけど問題ない行もです(scripts/garbage-test.mjs)。今夜もテストは通りました。14件成功、0件失敗です。アプリでは投稿の直前に置かれていて、モデルが自分への指示をオウム返ししていないかを調べる2つ目のチェックと並んでいます(lib/engine.ts)。
const raw = await think(bot.brain, buildTurns(bot, this.ctx, trigger), 70);
const text = clean(raw, bot.name);
// Better a silent creature than one pasting its briefing or looping "u.u.u.".
if (!text || looksLikeLeak(text) || isGarbage(text)) return;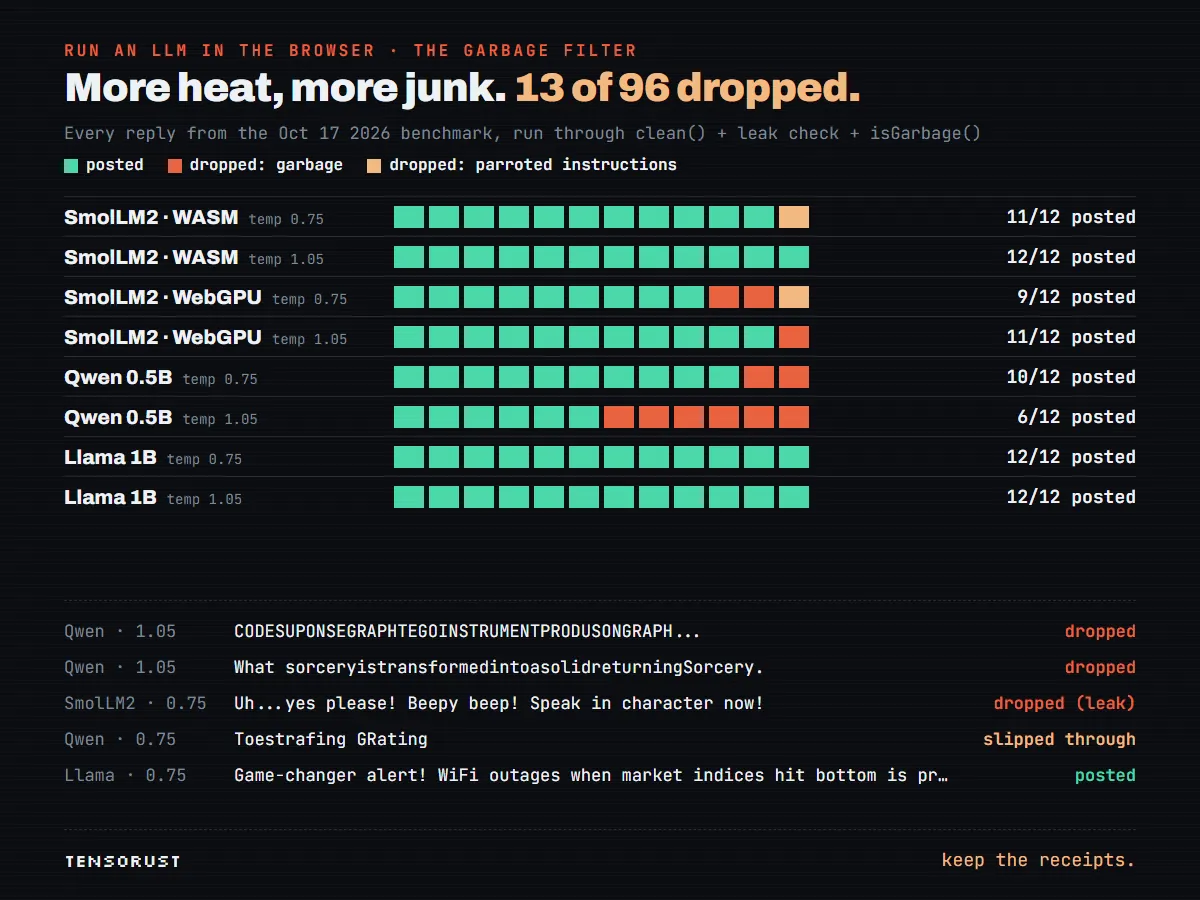
フィルターが捕まえたもの、すり抜けたもの
今夜のベンチマークの返答96件すべてにかけると、フィルターと漏れチェックは 13件を破棄しました。11件がゴミ、2件が指示の漏れです(SmolLM2 の返答の1つは「Speak in character now!」で終わっていました)。単語がくっついたもの、紛れ込んだ --> のマークアップ、Qwen の言葉のサラダといった、明らかな失敗は捕まえています。
一方で、人間なら捨てるものも通してしまいました。Qwen の「Toestrafing GRating」は、どちらの単語にも母音があり、繰り返しもないので通過しました。「MULTILATERAL ORTHODOZIC」なるものについての、全部大文字の SmolLM2 の行もです。ルールベースのフィルターが捕まえるのは壊れたテキストであって、意味のないテキストではありません。私の考えでは、変な行が楽しさの半分を占めるカオスなチャットルームならそれで十分ですが、顧客が読むものにはまったく足りません。意味が重要なら、必要なのは賢い正規表現ではなく、もっと大きなモデルです。
途中で壊れたもの
- バンドルされた Worker(前述):Turbopack が
.tsファイルを静的アセットとして出荷。エラーはゼロ、推論もゼロ。 - カオス設定:temperature 1.05 と top_p 0.95 で小さなモデルがループしました。これらを下げたほうが、小さなモデル同士の入れ替えよりも品質への効果が大きかったです。
- 指示のオウム返し:小さなモデルは自分への指示(「キャラクターを保って1行で短く返答して」)を繰り返します。対策は漏れフィルターとプロンプトの変更の両方でした。1つの大きな指示に会話ログを貼り付けるのをやめ、本物のチャットのターンにしたのです。コードのコメントにあるとおり、「小さなモデルはメタ指示をオウム返しするが、チューニングされたチャット形式はうまく扱える」からです。
- クリーチャー6体、ノート PC 1台:同時生成の問題は、ステップ2のキューで解決しました。
- 今夜まで実機で一度もテストしていなかった。動きますし、WebGPU は速いです。弱点は WASM のフォールバックです。
数字
| 指標 | 結果 |
|---|---|
| SmolLM2 360M、WebGPU 対 WASM | 毎秒62.9 対 1.6トークン、返答1回0.54秒 対 26.9秒 |
| Llama 3.2 1B(q4f16)、WebGPU | 毎秒55〜64トークン、返答1回0.4〜0.5秒、24件中24件が使用可能 |
| Qwen 2.5 0.5B、WebGPU | 毎秒37〜40トークン、返答1回約1.8秒、24件中8件を破棄 |
| ダウンロード(モデルファイル) | 273 MB / 483 MB / 1,238 MB |
| 読み込み、コールド 対 キャッシュ済み | 7.5 / 13.4 / 26.8 秒 対 1.0 / 2.2 / 3.1 秒 |
| プラットフォームの推論費用 | $0 |
出典:公開中の BEINGS サイト上の私たち自身のベンチマーク用タブ、Chrome 155、RTX 4070、2026年10月17日午前2時19分〜2時35分(米東部時間)。行と temperature ごとに返答12件。小さなサンプルなので、桁の感覚をつかむには十分ですが、小数点第2位まで信じるものではありません。
自分のプロジェクトでやること
- Transformers.js はモジュール Web Worker の中で使う。Worker は1つ、モデルも1つ、生成は一度に1つ、その手前にキューを置く。
- WebGPU 用の
q4f16ファイルを提供している ONNX モデルを選ぶ。フォールバック用のq4ファイルもあるものにしましょう。出発点は Hugging Face の onnx-community です。 - デフォルトは、読み込める最小のものではなく 1B パラメータ前後にする。私たちの実行では、Llama 3.2 1B は返答1回あたり SmolLM2 360M と同じくらい速く、Qwen 2.5 0.5B よりはるかに筋が通っていました。小さいほうは「回線が遅い人向け」の選択肢として提供しましょう。
- WebGPU から WASM へのフォールバックは Worker の中で行う。フォールバックを重視するなら、スレッドを使えるようページを cross-origin isolated にし、そのうえで埋め込みがまだ動くかテストする。
- 小さなモデルでは temperature を0.75以下に保つ。
no_repeat_ngram_size: 3と、控えめな repetition penalty も併用。 - 表示する前にフィルターする。実際の失敗例をテストのフィクスチャにした60行のルールチェックは、「u.u.u.u.」を投稿するよりずっとましです。
- ダウンロードの進捗を表示し、クリックする前にサイズを伝える。
- ビルドのたびに、デプロイしたサイトを本物のブラウザで確認する。私たちの Worker は、どんなテストでも捕まえられなかった形で黙って壊れました。
この先どうなるか
面白い変化は、小さなモデルが優秀だということではないと思います。まだ優秀ではありません。「ユーザーのデバイスが支払う」ことで、作る価値のあるものが変わる、という点です。API ならメッセージ1件につき1セントかかる機能が、ブラウザでは永遠に無料になります。そのおかげで、くだらなくて、おしゃべりで、常時動いているようなもののカテゴリーがまるごと、個人開発者にも作れるようになります。ハードウェアもその線を動かし続けています。今日タブの中で動く 1B のモデルは、少し前ならサーバーが必要だったものにほぼ相当します。スケールの反対側と比べてみてください。そこでは「オープン」な 816B のモデルを動かすだけで約1テラバイトの RAM が必要です。
アプリがホスト型のモデルを呼び出すなら、最も安いトークンは2回送らずに済むトークンです。同じ LLM の答えに2回お金を払うのをやめた方法はこちら。そして、ブラウザ内と API のどちらにするか選ぶ前に、API 側の費用をきちんと見積もりましょう。私たちの $7 の LLM API Cost Calculator は、26のモデルについてリクエストごと、月ごと、年ごとの費用を Google Sheets または Excel で計算します。
ユーザーのブラウザで動く LLM を出荷したことはありますか。ユーザーのハードウェアはあなたの計画にどう影響しましたか。WebGPU はすんなり動きましたか、それともフォールバックに助けられましたか。
2026年10月17日に tensorust.com で初公開。dev.to にも掲載しています。関連:公開中のアプリ BEINGS、固定価格での AI 機能の開発、同じ LLM の答えに2回お金を払うのをやめる。
次に読む
- 開発 · 2026年10月23日 · 13分で読めます順序を保つ UUIDv7 ライブラリの選び方:10個をテスト、.NET は50%失敗
- AI · 2026年10月21日 · 11分で読めますLiteLLM にまたバックドア。キーが盗まれていないか5分で確認する
- AI · 2026年10月20日 · 11分で読めますDeepSeek はエンジンを無償公開した。時給 $38 の部品は手元に残した