
DeepSeek はエンジンを公開した。1時間 $38 を稼ぐ部品は手元に残したまま
要点をすべて読む
要点:今日の午前5時30分(米東部時間)、DeepSeek は自社 API を支えるエンジン DeepInfer を「now fully open source」(完全にオープンソースになった)と発表しました。この投稿は5時間で150万人に見られています。ところが DeepSeek 自身の README には、実際のサービスに必要なのに「not included in this release」(このリリースには含まれていない)ものが3つ挙がっていて、同社の Q&A によれば、そのサービスの GPU は1台あたり1時間 $38 を稼いでいます。今朝リポジトリをクローンして測ってみました。DeepSeek 自身の図にある、トラフィックを振り分けたりキャッシュを保持したりする箱5つのうち4つが存在せず、vLLM と一致するコードは 6.82% だけで、Huawei 向けのカーネルは Nvidia 向けより 52% 大きいことがわかりました。
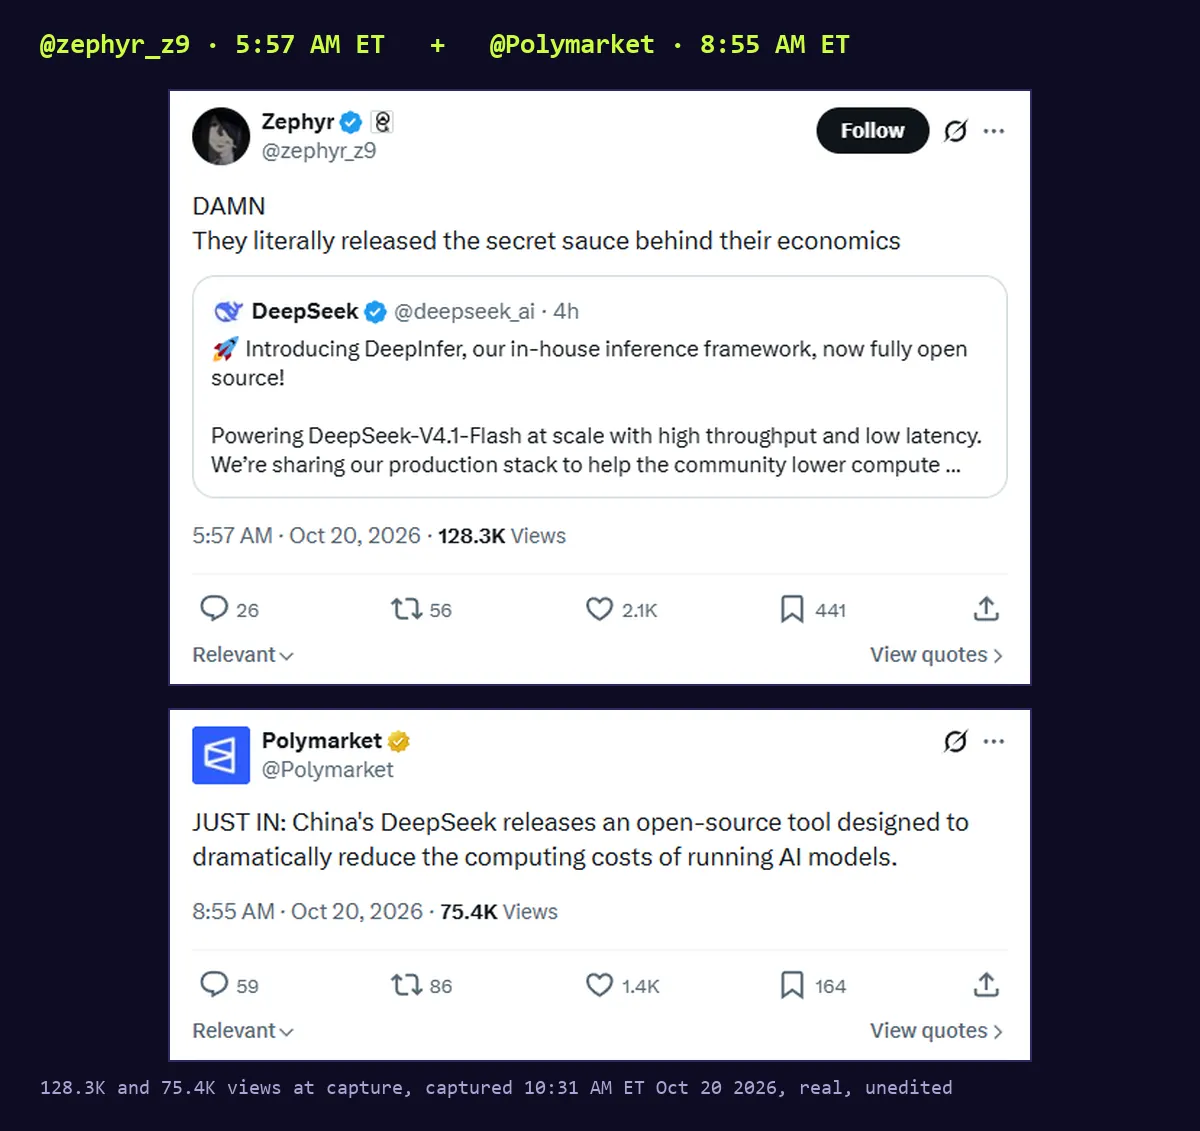
というわけで、@zephyr_z9 さん、彼らは「経済性を支える秘伝のタレを文字どおり公開した」わけではありません。公開したのはオーブンです。GPU を1時間 $38 に変えるレシピは、今も杭州にあります。それでも今年 AI ラボが開発者に贈ったものの中で最高のプレゼントであることは確かで、同時に、投稿が言っているものではないことも確かです。
「完全にオープンソース」。でも README の意見は違う
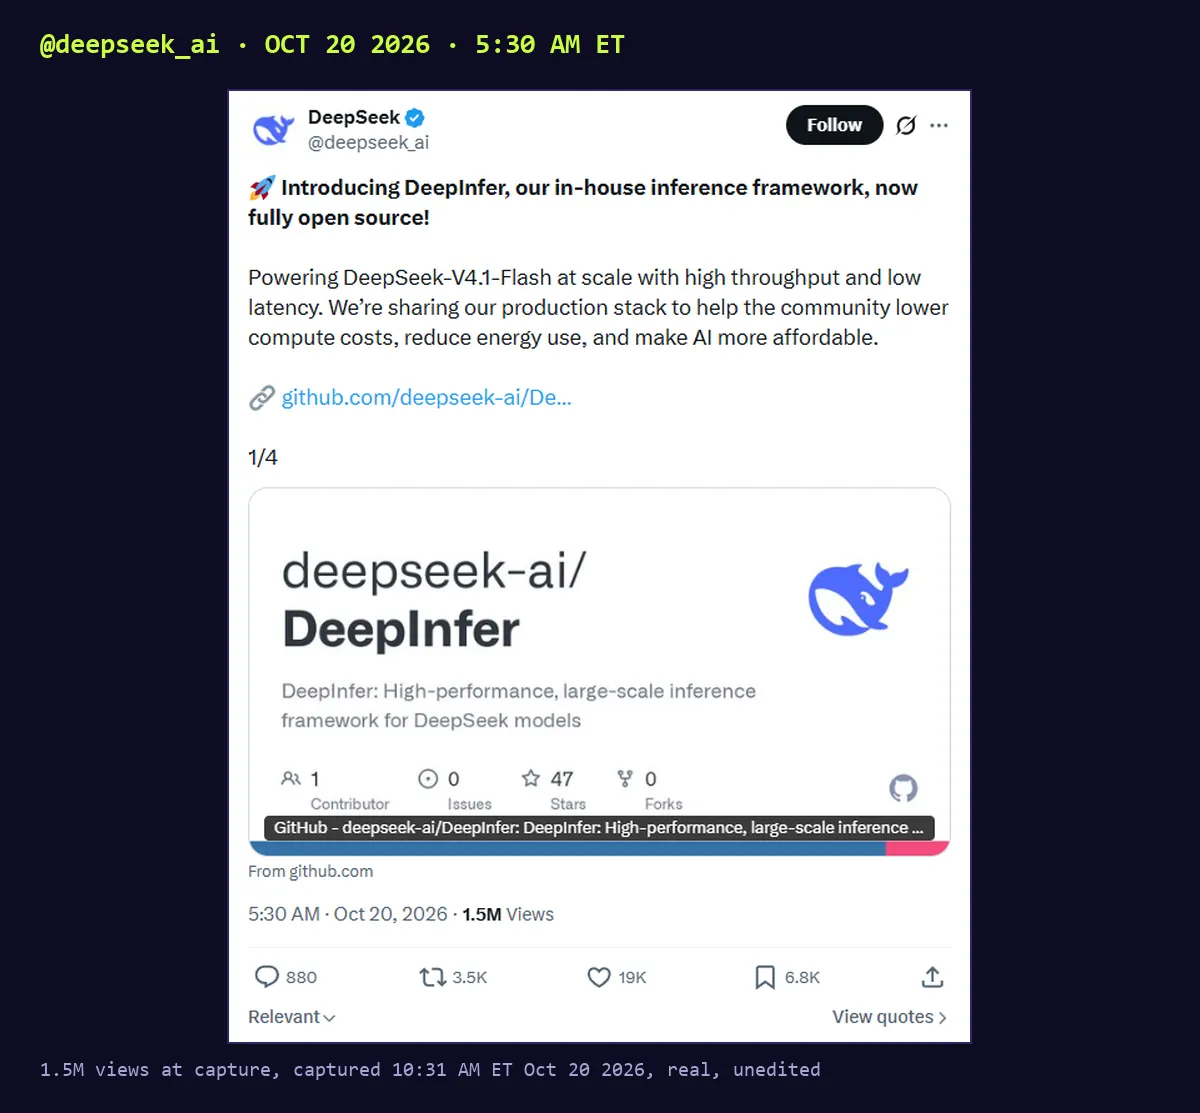
これが問題の投稿で、午前5時30分(米東部時間)の @deepseek_ai によるものです。午前10時31分には150万回表示、1.9万いいねに達しました。リポジトリは午前10時33分までに 8,663スターを集め、Hacker News のスレッドは 1,222ポイント、437コメントで1位でした。
では README を開いてみましょう。「Supported hardware」の下に、一字一句このとおりの見出しが付いたリストがあります:「Required for a complete inference service (not included in this release)」(完全な推論サービスに必要なもの(このリリースには含まれていない))。
- 「A KV cache system」(KV キャッシュのシステム)
- 「VE/Prefill/Decode disaggregation (most required engine functionality is already implemented)」(VE、プレフィル、デコードの分離。必要なエンジン機能の大部分は実装済み)
- 「Load balancing across data-parallel replicas for both prefill and decode」(プレフィルとデコードの両方での、データ並列レプリカ間のロードバランシング)
README の最初の一行も同じくらい正直です:「This open-source release provides offline inference.」(このオープンソースリリースが提供するのはオフライン推論です)。リポジトリには API サーバーがありません。grep してみたところ、HTTP に関するコードは環境変数でオンにするプロファイリング用のエンドポイントだけでした。自分のクラスターで DeepInfer にプロンプトを流すことはできます。でも、お客さんをそこにつなぐことはできません。
専門用語をやさしく言い換えておきます。プレフィル(prefill)は、モデルがあなたのプロンプトを読む段階です。デコード(decode)は、モデルが答えを1トークンずつ書く段階です。KV キャッシュは、すでに読んだプロンプトについてのモデルのメモで、同じものを読み直さずに済むようにします。分離(disaggregation)とは、プレフィルとデコードを別々のマシンで動かすことです。ロードバランサーは、あなたのリクエストをどのマシンに送るかを決めます。エンジンをビジネスに変えるのは、まさにこれらすべてです。
DeepSeek 自身の図をリポジトリと並べてみた
DeepSeek はリリースと一緒にデプロイに関する Q&A を公開しました。そこには V4.1 Flash の配信システム全体のアーキテクチャ図があります。README の「含まれていない」リストとコードを読んだ結果をもとに、図の各ボックスにラベルを付けました。
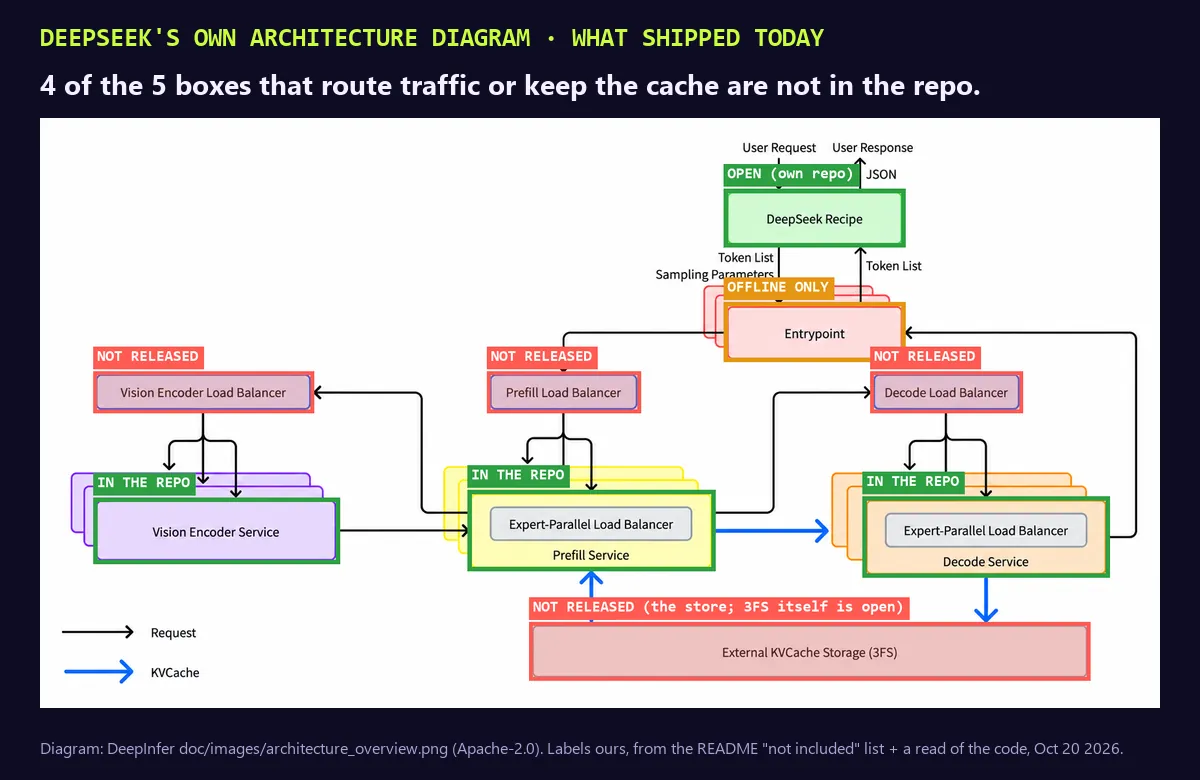
Q&A には、トラフィックを振り分けたりキャッシュを保持したりする部品が5つ挙がっています:Prefill Load Balancer、Decode Load Balancer、Vision Encoder Load Balancer、Expert-Parallel Load Balancer、KVCache Storageです。公開されているのはエキスパート並列のものだけです(deepinfer/model_executor/eplb/ にあります)。つまり5つのうち1つ。キャッシュの下にある 3FS ファイルシステムは2025年2月から公開されています。その上でキャッシュを動かすコンポーネント、Q&A で kvcache-store と呼ばれているものは、リポジトリにありません。
そして DeepSeek はその理由を、ほとんどの人が読み飛ばした Q&A の一段落で説明しています:
"The KV cache management and load balancing components of the inference system are tightly coupled to our internal infrastructure, so that code is not yet fully open-sourced."
(推論システムの KV キャッシュ管理とロードバランシングのコンポーネントは社内インフラと密に結びついているため、そのコードはまだ完全にはオープンソース化されていない。)「not yet fully open-sourced」(まだ完全にはオープンソース化されていない)と「now fully open source」(完全にオープンソースになった)は、どちらも同じ朝に公開された DeepSeek の文章です。ツイートに載っているのは片方だけです。
秘伝のタレはキャッシュで、本人たちもそう言っている
「経済性を丸ごと公開した」という見方が間違っている理由はここにあります。DeepSeek はこのシステムの設計目標を3つ挙げています。3つ目は「Retain KV cache for more than 72 hours」(KV キャッシュを72時間以上保持する)で、同じプロンプトが来たら高くつく読み込みの段階を省けるようにするものです。安い推論の源泉はここにあります。50ページ分のコードベースを2回読むためにお金を払わずに済むのです。
Q&A が、欠けている部品の価値をどう説明しているか見てみましょう:
- 1つのクラスターで1日155兆トークン。
- 「at valley pricing」(DeepSeek のオフピーク割引料金、つまりおそらく下限)でGPU 1時間あたり $38 の売上。
- ロードバランシングによって、完全に負荷が均等なベンチマークの約80%まで到達。GPU の箱と、忙しく働いている GPU の箱との差こそがビジネスです。
- キャッシュストレージは GPU 1台あたり14.4 TB。30.73 TB の SSD を20台積んだサーバーで、11ノードのうち任意の10ノードが応答できるようにイレイジャーコーディングされています。
では、返信欄で誰もしなかった比較をしましょう。Google Cloud では、DeepInfer の「SM100」ターゲットと同じ Blackwell クラスの B200 をスポットで1時間 $4.95、3年契約で $7.09、1年契約で $11.12 で借りられます(価格は今日更新)。DeepSeek の数字は、GPU のレンタル費用の 3.4倍から7.7倍です。売上は利益ではありませんし、DeepSeek はハードウェアを借りずに所有しています。それでも、この差こそが経済性です。そしてその差は、リポジトリにない4つの箱の中にあります。
あえて言い切ります。@Polymarket の「AI モデルを動かす計算コストを劇的に下げる」が当てはまるのは、地球上でせいぜい50社くらいです。理由はこうです。
DeepSeek と同じように動かすなら GPU 128台から
Q&A は最小構成について率直です:「the smallest efficient deployment unit is 64 GPUs of prefill plus 64 GPUs of decode」(効率的に運用できる最小単位は、プレフィル用 GPU 64台とデコード用 GPU 64台)。README のベンチマークは「measured on 4 SM100 GPUs for prefill and 64 for decode」(プレフィルに SM100 GPU 4台、デコードに64台で測定)です。デコードには EP64 以上(モデルのエキスパートを64から128台の GPU に分散)が必要です。そこで請求額を計算してみました。
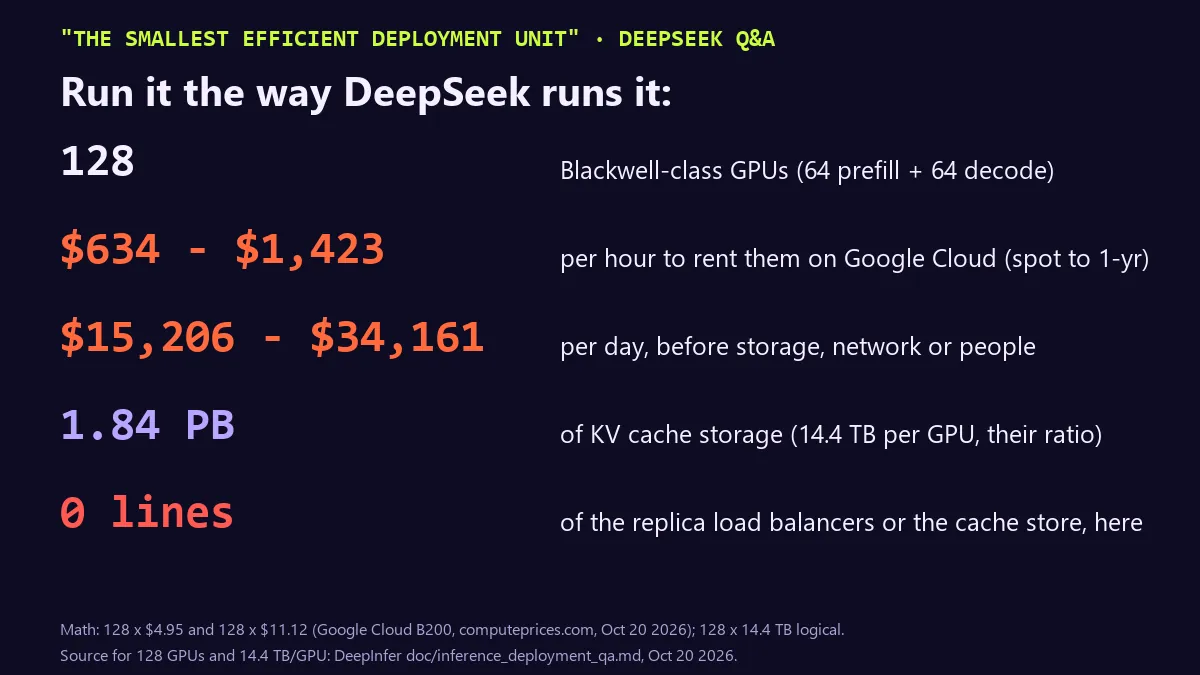
- GPU 128台 x $4.95 から $11.12 = 1時間 $634 から $1,423。
- ストレージ、ネットワーク、エンジニア1人分の人件費を入れる前で、1日 $15,206 から $34,161。
- GPU 1台あたり14.4 TB という比率で、キャッシュストレージは 1.84 PB。
- さらに、ロードバランサーとキャッシュストアは自分で書くことになります。
これを、今週タイムラインに流れてきたもうひとつの DeepSeek の話題と比べてみてください。Unsloth による1ビット版の V4.1 Flash は、508GB を250GB まで縮め、RAM 128GB 以上のマシンで動きます。ほとんどの人が実際に触るオープンモデルはこちらです。DeepInfer はクラウド事業者向けです。あなたがインディー開発者なら、DeepSeek からの本当の贈り物は、このリポジトリではなく今も安い API のほうです。
Q&A には、今回のリリース全体で一番の名言まであります。プレフィルとデコードを複数のデータセンターに分けられるか? できる、ただし「at some cost in reliability, e.g., the fiber running between data centers is easily severed by construction work」(信頼性は多少犠牲になる。たとえば、データセンター間を結ぶ光ファイバーは工事で簡単に切断される)。リスペクトです。ショベルカーに一週間を台無しにされた経験のあるチームの言葉です。
vLLM は「主に vLLM の上に構築」と言う。測ったら6.82%だった
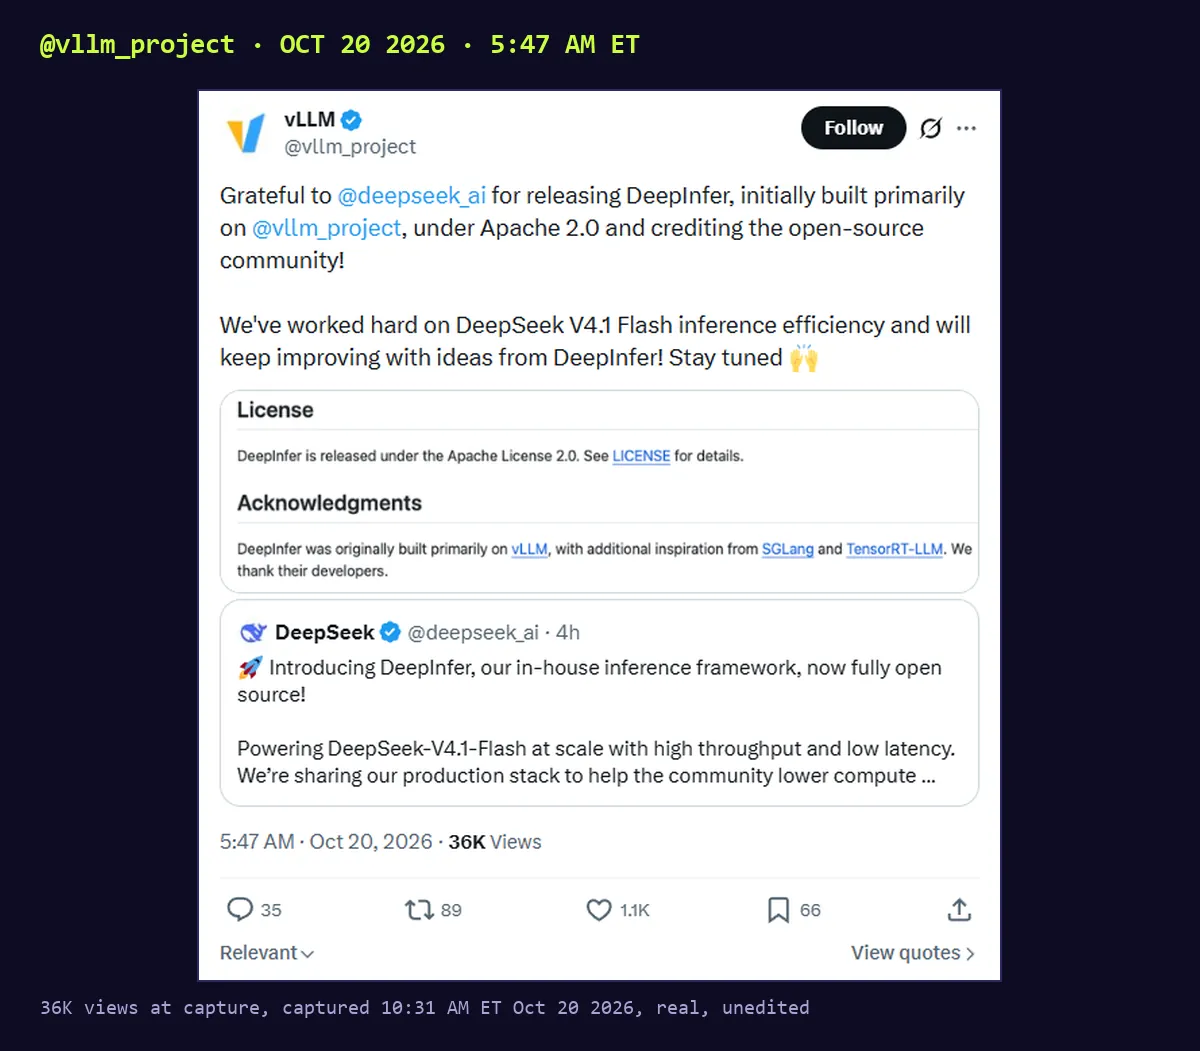
もうひとつの大きな反応は、業界の大部分が使っているオープンソースのエンジン、vLLM のチームからでした。彼らの投稿は好意的で、DeepSeek の README にも DeepInfer は「was originally built primarily on vLLM」(もともと主に vLLM の上に構築された)とあります。
そこで、vLLM がどれだけ残っているかを測りました。DeepInfer(コミット 774ce24)と、v0.2.0(2023年)から今日の main ブランチまで9つのリリースの vLLM をクローンしました。DeepInfer の deepinfer/ パッケージにある25文字以上の Python の行をすべて取り出し、コメントと空行を除き、空白をまとめたうえで、各行が vLLM の各リリースのどこかに完全一致で存在するかを調べました。スクリプトは60行の Python で、約1分で終わり、GPU は不要でした。
def norm(l):
    l = l.strip()
    if not l or l.startswith('#'): return None
    if len(l) < 25: return None   # skip trivial lines
    return re.sub(r'\s+', ' ', l)

# every .py file in each vLLM tag, read straight out of git
p = subprocess.run(['git', '-C', VL, 'cat-file', '--batch'],
                   input='\n'.join(f'{ref}:{f}' for f in files).encode(),
                   capture_output=True)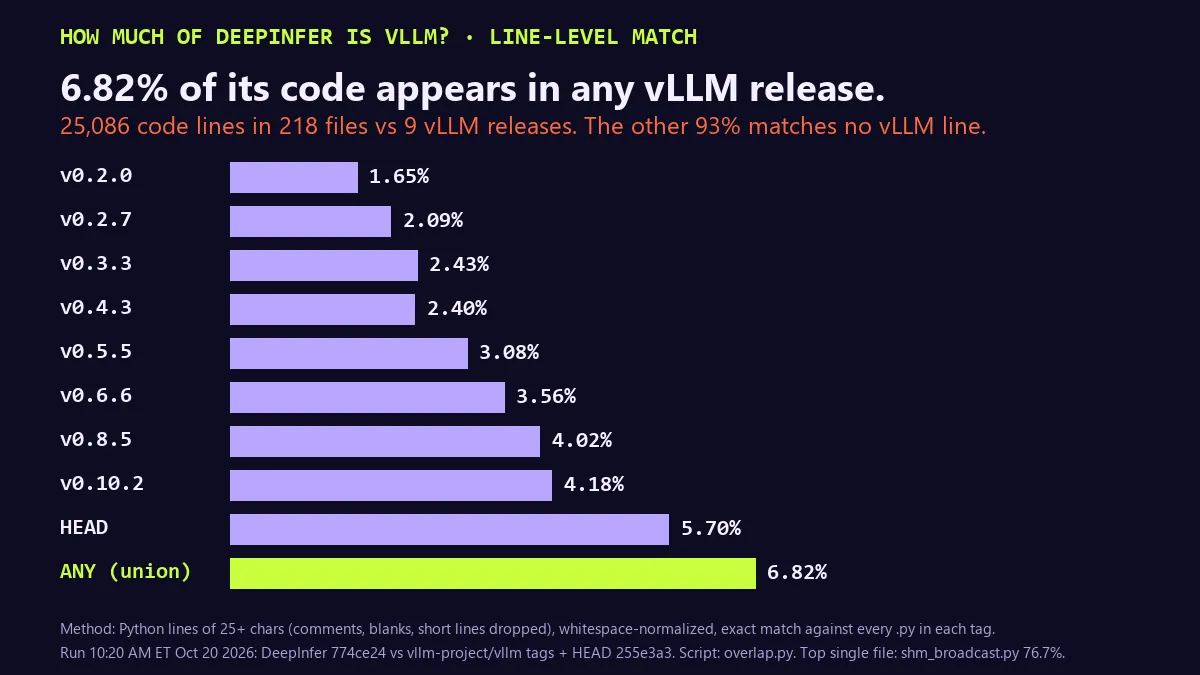
結果:25,086行中1,711行(6.82%)が、少なくとも1つの vLLM リリースに現れました。単一リリースで最も高いのは今日の vLLM main の5.70%で、これは主に両プロジェクトが同じ新しいアイデアを取り入れたことを意味します。最も vLLM らしさが残るファイルは、共有メモリのメッセージキューである shm_broadcast.py で76.7%。エンジンの中核 llm_engine.py は19.2%。V4 のモデルコードは5から12%程度です。
フォルダ構成には今も vLLM の面影があります:worker/cache_engine.py、sequence.py、model_runner.py。どれも2023年当時に vLLM が使っていた名前です。でも中のコードは書き直されています。この方法では変数名の変更やリファクタリングは拾えないので、6.82% は盗用のスコアではなく、血縁関係の下限として扱ってください。私たちの見方では、「vLLM の上に構築」というのは、高層ビルを「以前そこにあった駐車場の上に建てた」と言うようなものです。事実で、しかも寛大な言い方です。そして残りの93%を書いた DeepSeek は、正当に評価されるべきです。
Huawei 向けのコードは Nvidia 向けより52%多い
このリリースの本当の狙いは、ここにあると私たちは考えています。DeepInfer の独自カーネル(計算を担当する小さな GPU プログラム)は tilelang_ops/ にあり、チップごとにバックエンドが1つずつあります。同じ30個のカーネルに、それぞれ2つのバージョン。空でない行を数えました。
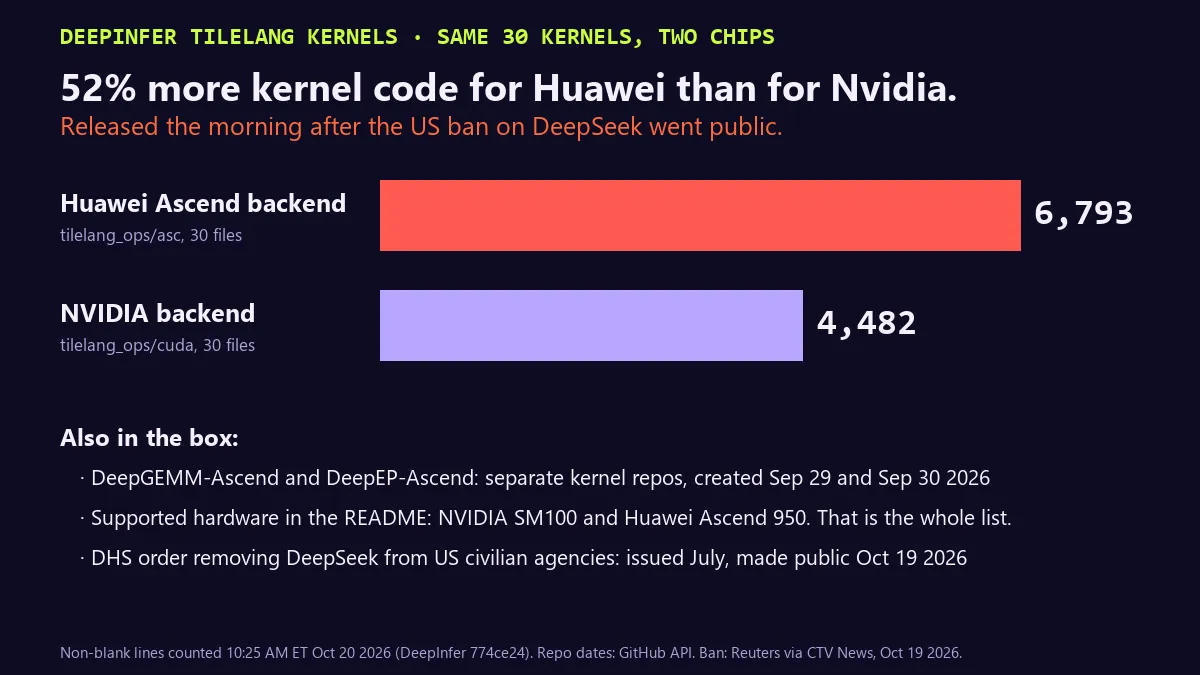
- Huawei Ascend バックエンド:6,793行。NVIDIA バックエンド:4,482行。差は+51.6%です。
- README の対応ハードウェア:「NVIDIA SM100 GPUs」と「Huawei Ascend 950 NPUs」。一覧はこれで全部です。H100 も AMD もありません。
- Ascend 向けのカーネルライブラリは、DeepGEMM-Ascend と DeepEP-Ascend という独立したリポジトリとして公開されていて、どちらも今日から3週間前の2026年9月29日と30日に作成されています。
- リリースの前日、Reuters は、米国土安全保障省(DHS)が非軍事系の連邦機関に DeepSeek の製品と、そのモデルを使ったサードパーティーのサービスを排除するよう命じていると報じました(7月に発令、10月19日に公表)。
- 同じ日、The Information は(@unusual_whales 経由、14.9万回表示)、DeepSeek と Huawei が Nvidia に対抗する新しい AI チップの設計で手を組むと報じました。
この +52% の一部は、単に若いチップを扱うコストです。Ascend のカーネルは CUDA のものより手間がかかります。でも、売り込むつもりのないチップのために6,793行を書く人はいません。決して口には出さないでしょうが、本当に起きていることはこうだと私たちは考えています。これは Apache ライセンスの付いた Huawei の営業資料です。DeepSeek と同じ価格で DeepSeek を配信したい中国のクラウド事業者はすべて、米国が供給を止められないチップで動く本番品質のエンジンを手に入れました。米国は月曜日に政府機関から DeepSeek を締め出しました。火曜日、DeepSeek は Huawei のシリコン上で、ほかのすべての人にとって自社モデルをより安く配信できるようにしました。正直なところ、今年いちばんタイミングの良いオープンソース公開かもしれません。
「デモではなく中国の本番システムだ」という証拠をもうひとつ。パッケージの空でない行 40,638行のうち1,147行に、中国語のコメントや docstring が含まれています。たとえば """compress 内核固定开启 fast math。"""(「compress カーネルは常に fast math を有効にする」)。これはローンチ用のブログのために書かれたものではありません。履歴全体はわずか3コミットです。午前0時9分(米東部時間)の345ファイル、63,326行の「initial commit」が1つと、ドキュメントの更新が2つ。今朝、どこか非公開の場所からエクスポートされたものです。
それでも OpenAI よりはオープン。本当に痛いのはそこだ
DeepSeek に公平に、そしてほかのみんなには不公平に言うと、OpenAI のオープンなリリースは 2025年8月の gpt-oss で、Apache 2.0 の重みとリファレンスコードでした。OpenAI、Anthropic、Google は、ChatGPT、Claude、Gemini を有料ユーザーに実際に配信しているシステムのコードを1行も公開していません。DeepSeek は今回、エンジン、カーネル、エキスパートのバランサー、主に Rust で書かれたトークナイザーのサービス(deepseek-recipe)、ストレージの構成、GPU 1時間あたりの売上、そしてトラフィックまで公開しました。
さあ、悪役を選んでください。本番エンジンの93%を出して100%と呼ぶラボか、0%しか出さずに自分たちを善玉と呼ぶラボたちか。
今日の反応ランキング
- 最も間違っている:@zephyr_z9「They literally released the secret sauce behind their economics」(経済性を支える秘伝のタレを文字どおり公開した)(12.8万回表示)。タレの正体は72時間のキャッシュと4つのロードバランサーです。どちらも公開されていません。
- ほとんどの読者にとって間違っている:@Polymarket「dramatically reduce the computing costs of running AI models」(AI モデルを動かす計算コストを劇的に下げる)(7.5万回表示)。Blackwell 128台と1ペタバイトの SSD を持っている人にとっては、そうでしょう。
- 最も寛大:@vllm_project「initially built primarily on vLLM」(当初は主に vLLM の上に構築)。今日の時点で6.82%。土台の功績は受け取ってください。建物は DeepSeek のものです。
- 最も正確:DeepSeek 自身の README。チームの誰かが「not included in this release」とはっきり書いていました。マーケティングの投稿はそれを読んでいませんでした。
ここまでの数字
- DeepSeek のルーティング・キャッシュ層で公開された箱:5つ中1つ(EPLB)、10月20日午前10時25分(米東部時間)に確認
- 9つの vLLM リリースのいずれかに見つかった DeepInfer の行:25,086行中1,711行(6.82%)
- カーネルの行数、Huawei Ascend 対 NVIDIA:6,793 対 4,482(+51.6%)
- DeepSeek の GPU 1時間あたりの売上:$38(同社の Q&A)、対して Google Cloud で B200 を借りると $4.95 から $11.12
- 効率的に運用できる最小構成:GPU 128台、1時間 $634 から $1,423
- スター数:午前10時33分(米東部時間)で8,663、最初のコミットから約10時間後
私たちの賭け、そしてあなたの番
予想:11月30日までに、vLLM と SGLang が DeepInfer の工夫の大部分(ドラフトトークンによるデコード、上限付きの SWA リプレイ)を取り込み、米国のクラウドは今日より速く V4.1 Flash を配信するようになるでしょう。そして12月31日になっても、中国の外で DeepSeek と同じやり方、つまり72時間のキャッシュと4つのバランサーで動かしている人はいないでしょう。DeepSeek がそれを手元に残したからです。もし私たちが間違っていたら、そのクラスターを見せてください。あなたの名前を見出しに入れて訂正記事を書きます。
あなたの番です:API リクエストを1件も配信できないリリースを「完全にオープンソース」と呼ぶのは公平でしょうか。イエスかノーか、理由を添えて返信で教えてください。@deepseek_ai の皆さんの回答も歓迎です。
V4.1 Flash を API 経由で使う場合と、GPU を自分で借りる場合のコストを比べてみたいですか? LLM API Cost Calculator($7、Google スプレッドシート + Excel、26モデル)なら、リクエストごとの計算を1枚のシートで済ませられます。無料版はサイトの tensorust.com/tools/llm-api-cost/ にあります。
tensorust.com の関連記事:Meta は816B のモデルをオープンソース化した。動かすには約1TB の RAM が必要、LLM プロキシのベンチマーク:重複した200回の呼び出しが1回になった、Theo の60%という数字は障害のグラフだ。
方法とデータ:DeepInfer は 774ce24(2026年10月20日)でクローン。vllm-project/vllm のタグ v0.2.0、v0.2.7、v0.3.3、v0.4.3、v0.5.5、v0.6.6、v0.8.5、v0.10.2 と、main は 255e3a3。すべての集計は2026年10月20日午前10時20分から10時35分(米東部時間)に実行。X のスクリーンショットは午前10時31分(米東部時間)に取得、実物で無編集。GPU の価格は computeprices.com の Google Cloud B200 ページより、2026年10月20日更新。
2026年10月20日に tensorust.com で初公開。X(@TensorustAI)、X(@MattBusel)、dev.to にも掲載しています。関連:無料の LLM API コスト計算ツール、Meta の816B には1TB の RAM が必要、LLM プロキシのベンチマーク。
もっと見る:著者、関連記事、シェア、無料ゲーム
次に読む
無料ツール:LLM API コスト計算ツール → 入力トークン、出力トークン、1日のリクエスト数から、GPT、Claude、Gemini の24モデルの月額コストを計算します。
- AI · 2026年10月21日 · 11分で読めますLiteLLM にまたバックドア。キーが盗まれていないか5分で確認する
- AI · 2026年10月19日 · 13分で読めますTheo の60%という数字は障害のグラフだ:Codex のインシデント43時間分
- AI · 2026年10月18日 · 13分で読めますジッター付き指数バックオフ:それでも LLM 呼び出し100回中64回が失敗した