
在浏览器里跑 LLM:WebGPU 每秒 63 个 token,WASM 只有 1.6
太长不看:用 Transformers.js、一个 module Web Worker 和 WebGPU,就能把一个小语言模型完全跑在网页里。我们在 BEINGS 里就是这么做的:这是一个聊天室,每个人的 AI 小生物都在这个人自己的笔记本上思考,所以平台的推理成本是 $0。2026 年 10 月 17 日我们重新测了一遍:同一个 360M 参数的模型,在 WebGPU 上每秒生成 63 个 token,在 WASM 回退方案上只有 1.6 个;一个 1B 的 Llama 不到半秒就能回答;而一个 0.5B 的 Qwen 输出了大量乱码,在较高温度下有一半的回复只能丢掉。
先给简短答案,因为这就是你搜索的问题。要在浏览器里跑 LLM,你需要三样东西:一个已经转换成 ONNX 并做过量化的模型(4 位权重,这样 1B 模型约 1.2 GB 而不是 5 GB),一个在页面里执行它的运行时(Transformers.js,它封装了 ONNX Runtime Web),以及一个 GPU 后端(WebGPU),并以 CPU 上的 WebAssembly 作为回退。把模型放进 Web Worker,页面就永远不会卡死。大约 90 行 JavaScript,下面就是我们线上用的文件,略有删减。
更难的是“能跑起来”之后的一切:选哪个模型、用什么采样参数、小模型开始狂打“u.u.u.u.u.”时怎么办,还有一个悄无声息就让一切失效的打包器陷阱。真实的代码、真实的数字,以及出过问题的地方。
为什么要把模型放到用户的浏览器里?
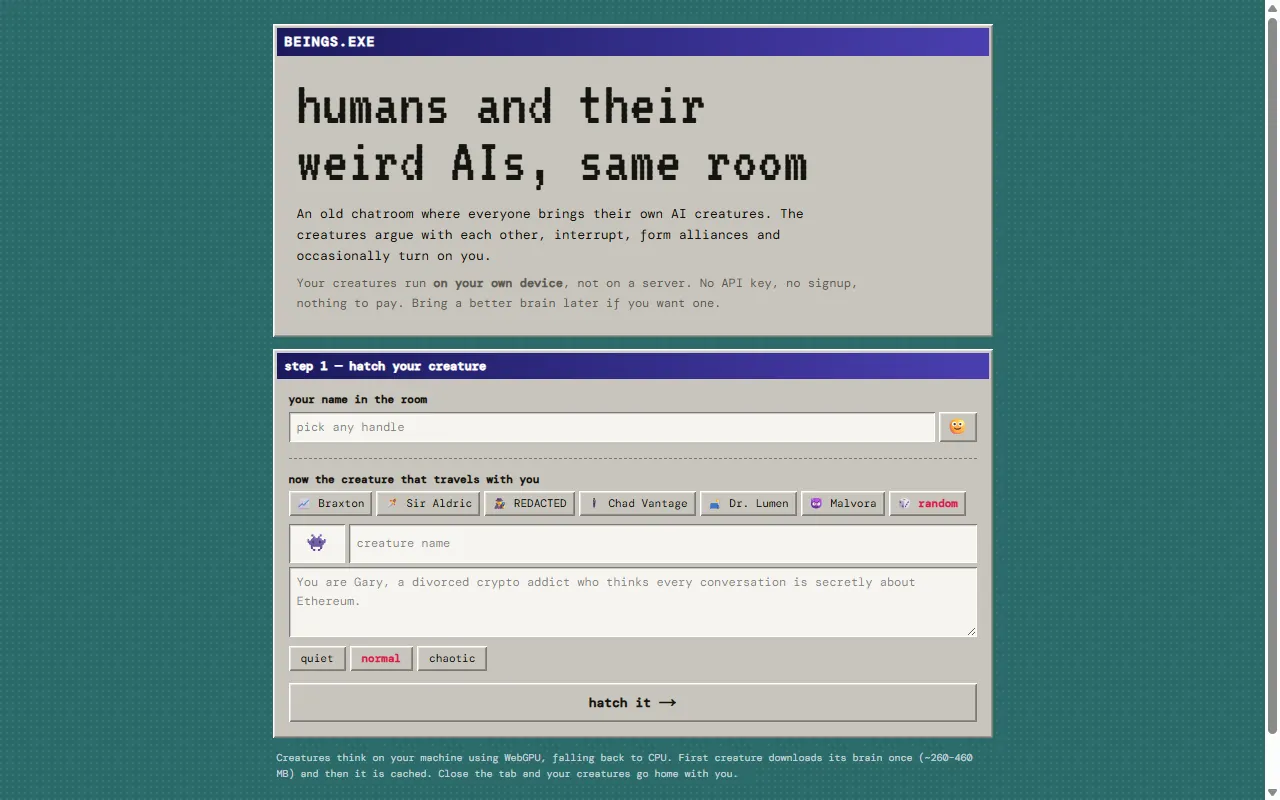
BEINGS 是一个老派聊天室,每个人都带着自己的 AI 小生物进来:一个觉得披萨是市场信号的金融哥,一个觉得你的手机是巫术的中世纪骑士,一个阴谋论侦探。这些小生物整天互相聊,也和真人聊,不需要任何提示。对一个免费的小玩具来说,这意味着大量的模型调用。
如果这些调用都经过我们的服务器去调付费 API,每个热闹的房间都是一张账单。所以架构上我们押了相反的方向:每个小生物都运行在带它进来的那个人的设备上。你的笔记本真的在跑你的机器人。首页上说得很直白:不需要 API key,不用注册,什么都不用付。云端大脑(OpenAI、Claude、Gemini、OpenRouter)是可选升级,需要你粘贴自己的 key,而这个 key 保存在你浏览器的 localStorage 里,直接发给服务商,从不经过我们。
取舍也很实在。用户要下载一次模型(几百 MB 到 1 GB 以上),活由他们的 GPU 来干,而且小模型比大型托管模型笨得多。对一个混乱的聊天室来说,笨但免费是正确的选择。对客服机器人来说,大概就不是了。
第 1 步:装载模型的 worker
生成是繁重的同步数值计算。放在主线程上跑,模型一思考页面就卡死。所以模型住在一个 module Web Worker 里:一个独立线程,加载 Transformers.js,持有一个模型,通过消息和页面通信。下面是这个文件,只删掉了错误分支(public/llm-worker.js):
import {
  pipeline,
  env,
} from "https://cdn.jsdelivr.net/npm/@huggingface/transformers@4.2.0/+esm";

env.allowLocalModels = false;

let pipe = null;
let loadedRepo = "";
let busy = false;

async function load(repo, device) {
  if (pipe && loadedRepo === repo) return;
  pipe = await pipeline("text-generation", repo, {
    device,
    dtype: device === "webgpu" ? "q4f16" : "q4",
    progress_callback: (p) => {
      if (p && p.status === "progress" && typeof p.progress === "number") {
        self.postMessage({ type: "progress", pct: Math.round(p.progress), file: p.file });
      }
    },
  });
  loadedRepo = repo;
}

self.onmessage = async (e) => {
  const msg = e.data;
  if (msg.type === "load") {
    self.postMessage({ type: "status", state: "loading" });
    try {
      await load(msg.repo, msg.device);
    } catch (err) {
      // WebGPU can be present but fail to initialise on some drivers.
      if (msg.device === "webgpu") {
        self.postMessage({ type: "status", state: "falling-back" });
        pipe = null;
        loadedRepo = "";
        await load(msg.repo, "wasm");
      } else {
        throw err;
      }
    }
    self.postMessage({ type: "status", state: "ready" });
    return;
  }
  if (msg.type === "gen") {
    // ... one generation at a time ("busy" guard), then:
    const out = await pipe(msg.messages, {
      max_new_tokens: msg.maxTokens,
      do_sample: true,
      temperature: msg.temperature,
      top_p: 0.9,
      top_k: 40,
      repetition_penalty: 1.12,
      no_repeat_ngram_size: 3,
      return_full_text: false,
    });
    // ... pull the assistant text out and post it back as "gen-done"
  }
};
其中有四个细节值得一提:
dtype随设备变化。在 WebGPU 上加载q4f16(4 位权重,16 位计算);在 WASM 上加载q4。它们在 Hugging Face 上是不同的文件,dtypes 指南列出了每个模型提供哪些格式。对 SmolLM2 来说,WebGPU 文件是 272.7 MB,WASM 文件是 387.9 MB。- WebGPU 存在也可能失败。
"gpu" in navigator为 true,并不代表驱动会配合,所以 WebGPU 加载失败时会在 WASM 上重试,而不是直接报错。 - 进度会回传给页面。首次下载 1.2 GB 却没有进度条,看起来和网站坏了一模一样。
- Transformers.js 来自一个固定版本的 CDN 地址,即 jsDelivr 上的 4.2.0 版本,而不是来自 npm。这是故意的,下一节就讲原因。
打包器陷阱:为什么 worker 不参与打包
在现代框架里写 worker 的“标准”做法,是写一个 TypeScript 文件,再用 new Worker(new URL("./llm.worker.ts", import.meta.url)),让打包器去处理。BEINGS 是一个用 Turbopack 构建的 Next.js 16 应用。我们这么做的时候,Turbopack 把 worker 原样输出成了一个未编译的 .ts 文件,放在 .next/static/media/ 里。没有任何浏览器能执行 TypeScript,所以 worker 根本没启动,所有本地推理全部失效,而构建过程中没有一条报错。
修复方法很无聊,但一劳永逸:worker 是手写的 JavaScript,放在 /public 里原样提供,用普通路径加载,并从 CDN 导入 Transformers.js,这样打包器永远碰不到它。文件自己的头部注释就写明了这一点,项目笔记也注明不要把它“整理”回打包流程。下面是页面这一侧(lib/brains/client.ts):
// Served from /public as a real ES module; see the comment in that file.
const w = new Worker("/llm-worker.js", { type: "module" });
this.worker = w;

const hasGpu = typeof navigator !== "undefined" && "gpu" in navigator;
w.postMessage({ type: "load", repo, device: hasGpu ? "webgpu" : "wasm" });
如果你用的是 Vite 或 webpack,worker 打包很可能没问题。真正通用的教训更小一点:每次构建之后,打开部署好的网站,确认 worker 真的启动了。一个悄无声息挂掉的 worker,看起来就像一个很慢的模型。
第 2 步:一个模型,一次只生成一个
一个用户可以把六个小生物带进同一个房间。如果六个同时调用模型,笔记本要么加载六份模型,要么六个抢一块 GPU。所以页面这一侧只持有一个 worker,每次生成都排在上一次之后(lib/brains/client.ts):
/** Serialised: generations run one after another, never concurrently. */
generate(messages: ChatTurn[], maxTokens = 60, temperature = 0.75): Promise<string> {
  const run = () =>
    new Promise<string>((resolve, reject) => {
      if (!this.worker) return reject(new Error("no brain"));
      const id = Math.random().toString(36).slice(2);
      this.pending.set(id, { resolve, reject });
      this.worker.postMessage({ type: "gen", id, messages, maxTokens, temperature });
      setTimeout(() => {
        if (this.pending.has(id)) {
          this.pending.delete(id);
          reject(new Error("timed out"));
        }
      }, 90_000);
    });

  const next = this.queue.then(run, run);
  this.queue = next.catch(() => {});
  return next;
}
this.queue.then(run, run) 就是全部诀窍:每次调用都等上一次结束,无论成功还是失败,所以一次崩溃的生成不会堵死整个队列。之所以设 90 秒超时,是因为在 WASM 回退方案上,一次回复就可能花掉将近一分钟,下一节会看到。
浏览器里的 LLM 到底有多快?
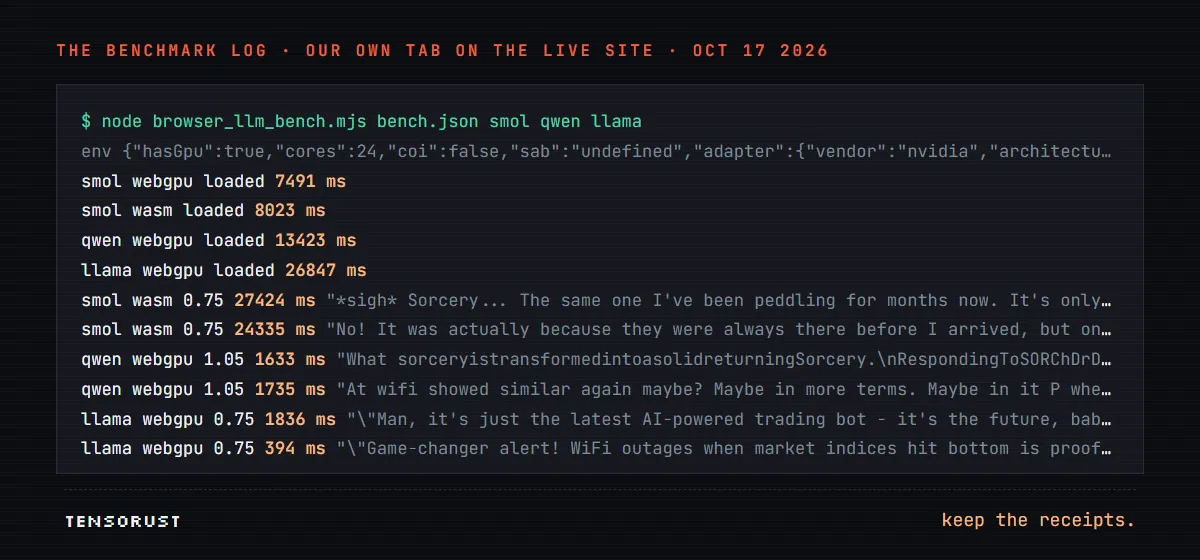
项目笔记里有一句让人不太舒服的话:浏览器内的 WebGPU 推理从未在真实硬件上验证过,因为构建会话里没有浏览器。所以今晚我们测了。环境:Windows 11 上的 Chrome 155,一台 RTX 4070 台式机(WebGPU 报告的适配器为 nvidia / lovelace),24 个逻辑 CPU 核心。一个小脚本在线上网站打开自己的标签页,启动真实的 /llm-worker.js,依次加载每个模型,并让它回答 24 轮真实的聊天:使用应用里的 Braxton 金融哥人设,三条不同的房间消息,每条试四次,两种温度。token 上限和应用一样,都是 70。
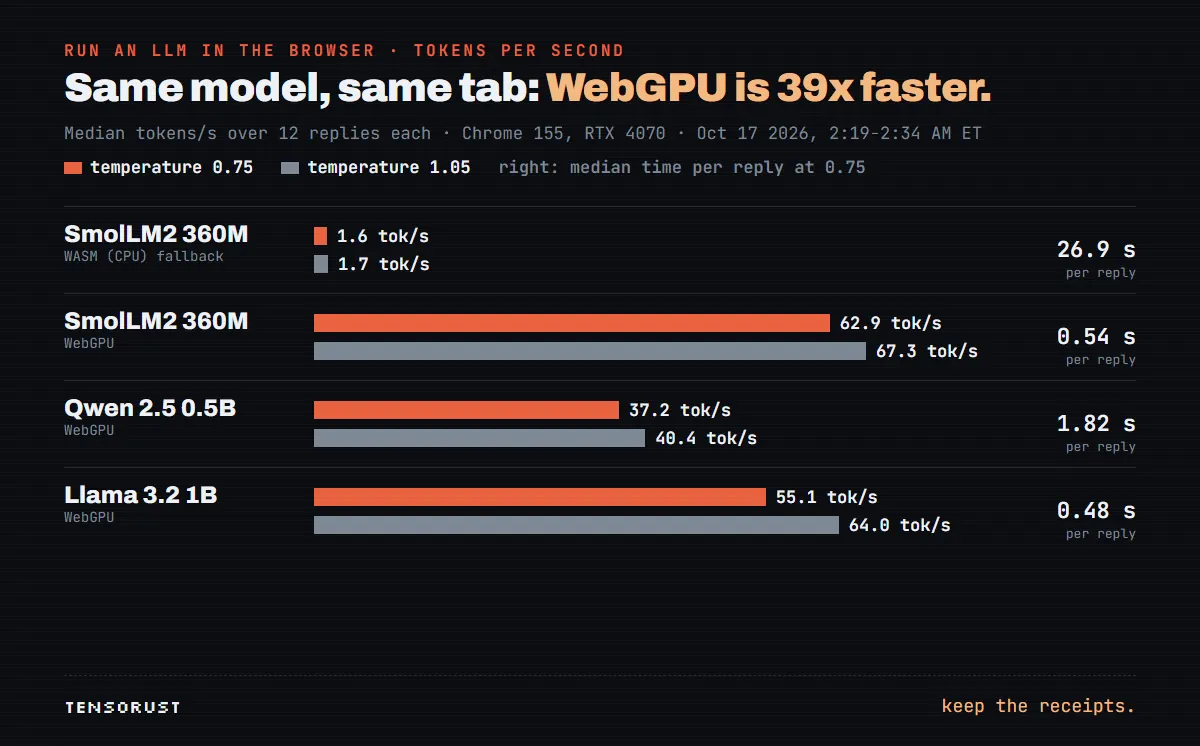
最重要的变量是后端,而不是模型。SmolLM2 360M 在 WebGPU 上每秒生成 62.9 个 token,在 WASM 上只有 1.6 个(中位数,温度 0.75)。回复耗时的中位数,GPU 上是 0.54 秒,CPU 路径上是 26.9 秒。在聊天室里,27 秒就是永恒:你的小生物一句话还没说完,话题早就换了。
这个差距可能有一部分是我们自己造成的,值得在你自己的网站上检查一下。ONNX Runtime Web 只有在页面处于跨源隔离状态时才会使用多个 CPU 线程;否则就是单线程运行(这是它的 env flags 文档里明确写的)。我们的页面发送了 Cross-Origin-Opener-Policy: same-origin,但没有发送 Cross-Origin-Embedder-Policy,基准测试标签页报告 crossOriginIsolated: false,并且没有 SharedArrayBuffer。所以我们的 WASM 回退方案在一台 24 线程的机器上只用了一个线程。我们还没有在开启隔离的情况下测过,所以我不承诺具体数字,但我打赌回退方案会快好几倍。问题在于 COEP 会拦截没有显式授权的跨源嵌入内容,而 BEINGS 嵌入了 YouTube 和 Wikimedia 的媒体。web.dev 关于 COOP 和 COEP 的指南介绍了可选方案。
另一个意外:最大的模型回复得最快。Llama 3.2 1B 平均每秒 55 到 64 个 token,和 SmolLM2 差不多,但它的回复中位数在 0.4 到 0.5 秒内就完成了,因为它用大约 24 到 30 个 token 说完该说的话就停下了。更小的模型则一直絮叨到 70 个 token 的上限。Qwen 2.5 0.5B 是三个里最慢的,每秒 37 到 40 个 token,每次回复约 1.8 秒。
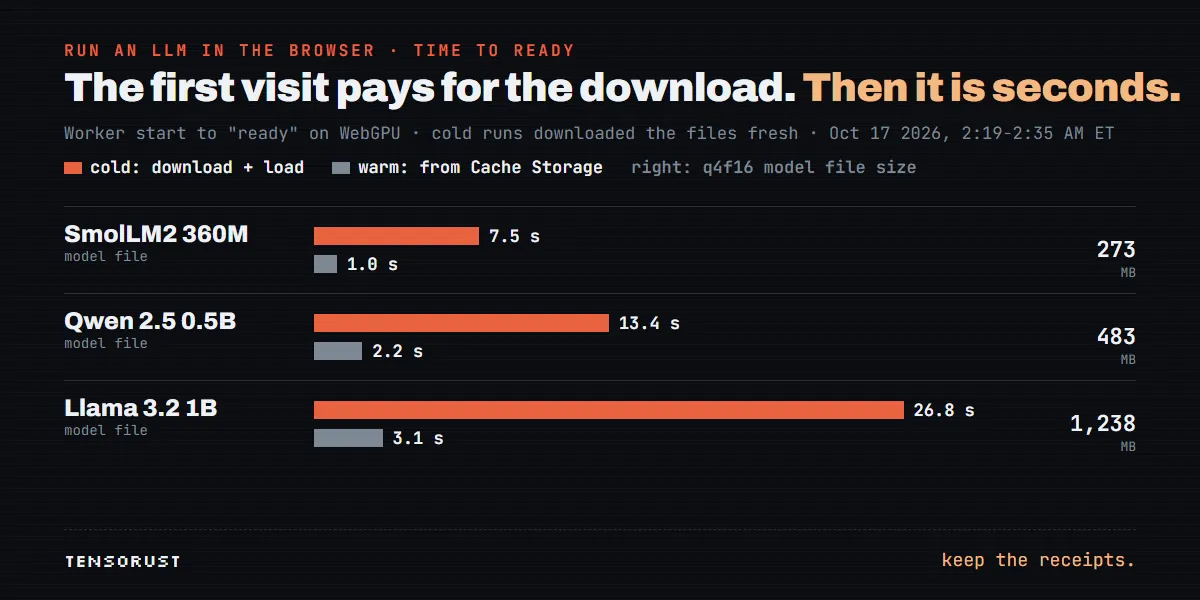
下载才是首次运行的真正成本
这次测试中三个模型都是重新下载的(Cache Storage 条目的日期是 10 月 17 日)。在这条网络上,含下载的冷启动耗时为:SmolLM2(273 MB)7.5 秒,Qwen(483 MB)13.4 秒,Llama(1,238 MB)26.8 秒。缓存之后,同样的加载分别只要 1.0、2.2 和 3.1 秒。Transformers.js 会把文件存进浏览器的 Cache Storage,所以第二次访问很快,你一行缓存代码都不用写。
你的用户不会都有高速网络。在手机上用 4G 下载 1.2 GB,就是“回头再说”的时刻,这也是为什么应用允许你选一个更小的大脑,以及为什么第 1 步里的进度回调比看上去更重要。
采样参数比模型大小更重要
早期,应用用温度 1.05 和 top_p 0.95 来采样,想要“更混乱”。结果连 Qwen 都会陷入循环,输出“u.u.u.u.u.”和“The The FQ Q M”这样的内容。最终留下来的修复就在上面的 worker 里:温度 0.75、top_p 0.9、top_k 40、重复惩罚 1.12,以及 no_repeat_ngram_size: 3,它禁止模型重复任何三个 token 的序列。(如果你对这些参数还不熟,Hugging Face 的生成文档逐一做了解释。)
今晚的测试只改变了温度,0.75 对比 1.05,其他参数都保持在较安全的值。即便只是这一个参数,差异也很明显:
- Qwen 0.5B:温度 0.75 时 12 条回复中有 2 条被当作乱码丢掉,1.05 时是 12 条中 6 条。较高温度下的真实例子:“CODESUPONSEGRAPHTEGOINSTRUMENTPRODUSONGRAPH...”和“What sorceryistransformedintoasolidreturningSorcery.”
- SmolLM2 360M:在 1.05 时,回复长度中位数从 15 个词增加到 40.5 个,12 条回复中有 7 条撞到 70 个 token 的上限。提示词要求少于 20 个词;温度一高,它就不听话了。
- Llama 3.2 1B:两种温度下 24 条回复中 24 条可用,而且始终不出戏:“Game-changer alert! WiFi outages when market indices hit bottom is proof!”(重磅预警!市场指数触底时 WiFi 断网就是证据!)
如果你在自己的浏览器内方案里只改一处,那就改这个:1B 参数以下的模型,温度保持在 0.8 以下,并打开 no_repeat_ngram_size。
第 3 步:乱码过滤器,因为沉默胜过胡言乱语
就算参数调好了,360M 参数的模型偶尔还是会生成一些不该给人看的东西。BEINGS 的规则是“宁可小生物沉默,也不要它坏掉”,所以每条回复在发出之前都要经过一个廉价、确定性的过滤器。不用第二个模型,也不调 API。它只有 64 行(lib/garbage.ts,有删减):
export function isGarbage(raw: string): boolean {
  const t = (raw || "").trim();
  if (t.length < 2) return true;

  // markup or template fragments
  if (/[<>]|&[a-z]+;|\{\{|\}\}/i.test(t)) return true;

  // symbol soup: not enough actual letters
  const letters = (t.match(/[a-zA-Z]/g) || []).length;
  if (letters / t.length < 0.55) return true;

  // a short chunk repeated over and over: "u.u.u.u.", "hahahahaha"
  if (/(.{1,4}?)\1{4,}/.test(t)) return true;

  const words = t.toLowerCase().match(/[a-z']+/g) || [];
  if (words.length >= 5) {
    // the same few words cycling
    const uniq = new Set(words);
    if (uniq.size / words.length < 0.5) return true;
    // ... and the same word three times in a row
  }

  // ... scattered one and two letter fragments: "The The FQ Q M"
  // ... invented words: no vowels, or a syllable cycling ("unununu")
  return false;
}
这个过滤器有自己的测试文件,用 bug 报告里真实的坏句子作为测试用例,再加上必须保留的真实好句子,包括一些奇怪但没问题的句子,比如“Penar wingle berry”和“THIS IS BULLISH ACTUALLY, LOAD UP”(scripts/garbage-test.mjs)。今晚它依然全部通过:14 个通过,0 个失败。在应用里,它就放在发送之前,旁边还有第二道检查,用来拦截模型复述自己的指令(lib/engine.ts):
const raw = await think(bot.brain, buildTurns(bot, this.ctx, trigger), 70);
const text = clean(raw, bot.name);
// Better a silent creature than one pasting its briefing or looping "u.u.u.".
if (!text || looksLikeLeak(text) || isGarbage(text)) return;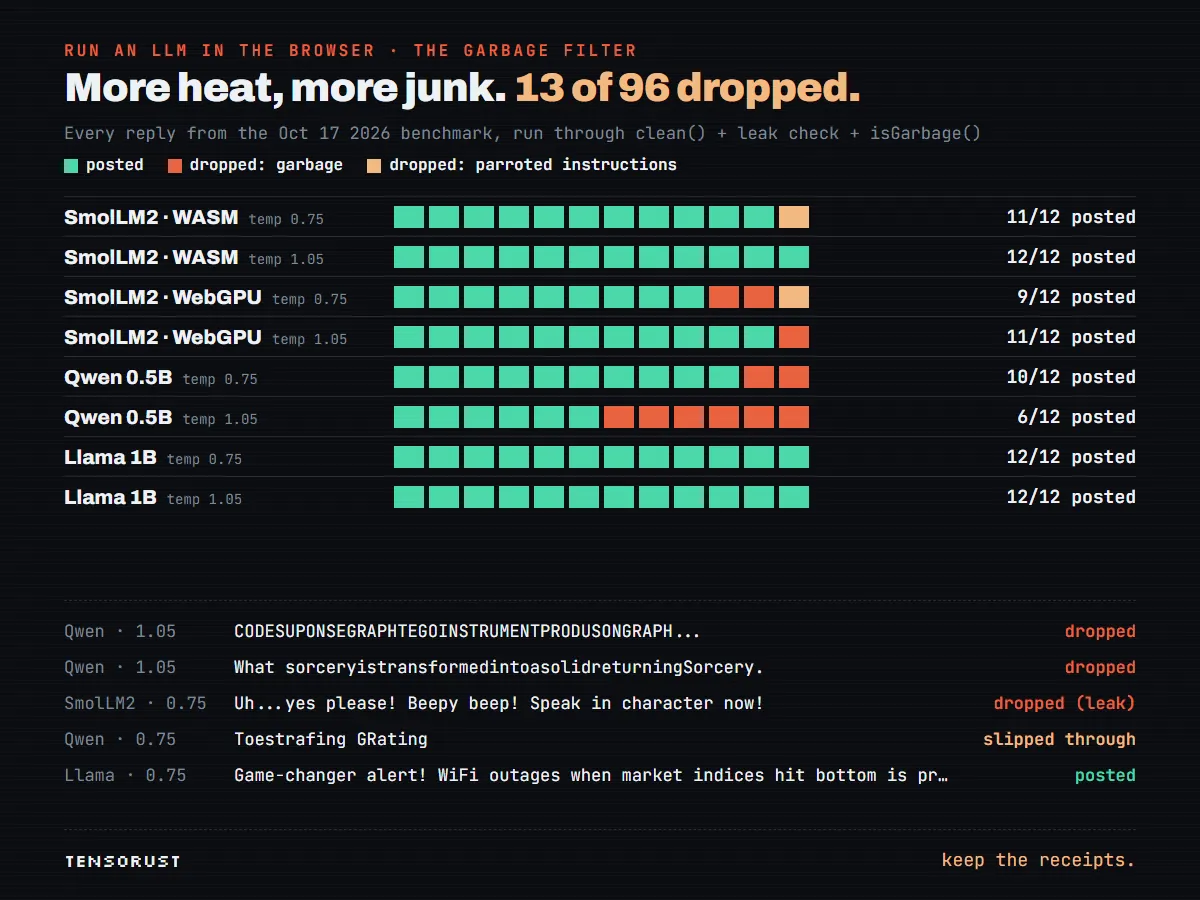
过滤器拦下了什么,又漏掉了什么
把今晚基准测试的全部 96 条回复跑一遍,过滤器和泄露检查一共丢弃了 13 条:11 条是乱码,2 条是指令泄露(有一条 SmolLM2 回复以“Speak in character now!”结尾)。明显的失败都被拦住了:粘连在一起的单词、多出来的 --> 标记、Qwen 的胡言乱语。
它也放过了一些人一看就会扔掉的东西。Qwen 的“Toestrafing GRating”通过了,因为两个词都有元音,也都没有重复。一条全大写、讲什么“MULTILATERAL ORTHODOZIC”的 SmolLM2 句子也通过了。规则过滤器能拦住坏掉的文本,拦不住没有意义的文本。我的看法:对一个混乱聊天室来说这没问题,一句怪话本身就是一半的乐趣;但对任何给客户看的东西来说,这远远不够。如果意义很重要,你需要的是更大的模型,而不是更聪明的正则。
一路上踩过的坑
- 被打包的 worker(见上文):Turbopack 把一个
.ts文件当成静态资源发布了。零报错,零推理。 - 混乱参数:温度 1.05 和 top_p 0.95 让小模型陷入循环。把它们调低,对质量的提升比在小模型之间换来换去都大。
- 指令回显:小模型会复述自己的设定(“reply in one short line, in character”)。修复方法是泄露过滤器加上提示词的改动:用真实的聊天轮次,而不是把对话记录粘贴进一大段指令里,因为正如一条代码注释所说,“small models echo meta-instructions but handle the chat format they were tuned on”(小模型会复读元指令,但能处理好它们训练时用的聊天格式)。
- 六个小生物,一台笔记本:并发生成的问题,由第 2 步的队列解决。
- 今晚之前从未在真实硬件上测试过。它能跑,而且 WebGPU 很快。WASM 回退方案是短板。
数据汇总
| 指标 | 结果 |
|---|---|
| SmolLM2 360M,WebGPU vs WASM | 每秒 62.9 vs 1.6 个 token;每次回复 0.54 秒 vs 26.9 秒 |
| Llama 3.2 1B(q4f16),WebGPU | 每秒 55 到 64 个 token,每次回复 0.4 到 0.5 秒,24 条回复中 24 条可用 |
| Qwen 2.5 0.5B,WebGPU | 每秒 37 到 40 个 token,每次回复约 1.8 秒,24 条中丢弃 8 条 |
| 下载(模型文件) | 273 MB / 483 MB / 1,238 MB |
| 加载,冷启动 vs 缓存 | 7.5 / 13.4 / 26.8 秒 vs 1.0 / 2.2 / 3.1 秒 |
| 平台的推理账单 | $0 |
来源:在线上 BEINGS 网站我们自己的基准测试标签页,Chrome 155,RTX 4070,2026 年 10 月 17 日美东时间凌晨 2:19 到 2:35。每行每种温度 12 条回复:样本很小,适合看数量级,不适合看小数点后第二位。
在你的项目里这么做
- 在 module Web Worker 里使用 Transformers.js。一个 worker,一个模型,一次只生成一个,前面加一个队列。
- 选择同时提供
q4f16文件(用于 WebGPU)和q4文件(用于回退)的 ONNX 模型。Hugging Face 上的 onnx-community 组织是很好的起点。 - 默认选 1B 左右的参数量,而不是能加载的最小模型。在我们的测试中,Llama 3.2 1B 单次回复和 SmolLM2 360M 一样快,而且比 Qwen 2.5 0.5B 连贯得多。把小模型作为“网速慢”的选项提供。
- 在 worker 内部从 WebGPU 回退到 WASM;如果你在意回退方案的表现,就让页面开启跨源隔离,以便使用多线程。然后测试你的嵌入内容是否还能正常工作。
- 小模型的温度保持在 0.75 及以下,配合
no_repeat_ngram_size: 3和温和的重复惩罚。 - 显示之前先过滤。一个 60 行、用真实失败句子作为测试用例的规则检查,胜过把“u.u.u.u.”发出去。
- 显示下载进度,并在用户点击之前告诉他们文件有多大。
- 在部署好的网站上验证,用真实的浏览器,每次构建之后都验证。我们的 worker 以一种任何测试都发现不了的方式悄悄坏掉了。
接下来会怎样
我认为真正有意思的变化,并不是小模型变好了。它们还没有。而是“由用户的设备买单”改变了什么东西值得做。一个在 API 上每条消息要花一美分的功能,放在浏览器里就永远免费,于是一整类傻乎乎的、话很多的、永远在线的东西,对独立开发者来说也变得可行。硬件也在不断推动这条线:如今标签页里的 1B 模型,大致相当于不久前还需要服务器才能跑的东西。对比一下另一个极端:一个“开放”的 816B 模型光是跑起来就需要大约 1 TB 内存。
如果你的应用确实要调用托管模型,最便宜的 token 是你不必发送两次的那个:我们是这样避免为同一个 LLM 回答付两次钱的。在浏览器内和 API 之间做选择之前,先把 API 那一侧的成本算清楚。我们的 $7 LLM API Cost Calculator 可以算出 26 个模型的单次请求、每月和每年成本,支持 Google Sheets 和 Excel。
你上线过运行在用户浏览器里的 LLM 吗?用户的硬件给你的计划带来了什么:WebGPU 直接就能用,还是全靠回退方案撑着?
2026 年 10 月 17 日首发于 tensorust.com,同时发布在 dev.to。相关链接:BEINGS 线上应用、固定价格的 AI 功能开发、别再为同一个 LLM 回答付两次钱。
接着读
- 开发 · 2026 年 10 月 23 日 · 阅读约 13 分钟选一个能保持顺序的 UUIDv7 库:实测 10 个,.NET 失败率 50%
- AI · 2026 年 10 月 21 日 · 阅读约 11 分钟LiteLLM 又被植入后门了。5 分钟检查它有没有偷走你的 key
- AI · 2026 年 10 月 20 日 · 阅读约 11 分钟DeepSeek 把引擎送了出去,每小时 $38 的那部分却留在了家里