
DeepSeek 把引擎送了出来,每小时 38 美元的那部分却留在了家里
展开完整摘要
太长不看:今天美东时间早上 5:30,DeepSeek 宣布 DeepInfer,也就是驱动它自家 API 的推理引擎,“现已完全开源”。五小时内有 150 万人看到了这条帖子。可 DeepSeek 自己的 README 列出了一个真正的服务所需、但“不包含在本次发布中”的三样东西,而它自己的问答文档说,这个服务里每块 GPU 每小时能赚 38 美元。我今天上午克隆了仓库并做了测量:DeepSeek 自己的架构图里,负责流量路由或保存缓存的 5 个模块中,有 4 个不在仓库里;代码只有 6.82% 与 vLLM 一致;华为的算子比 Nvidia 的多 52%。
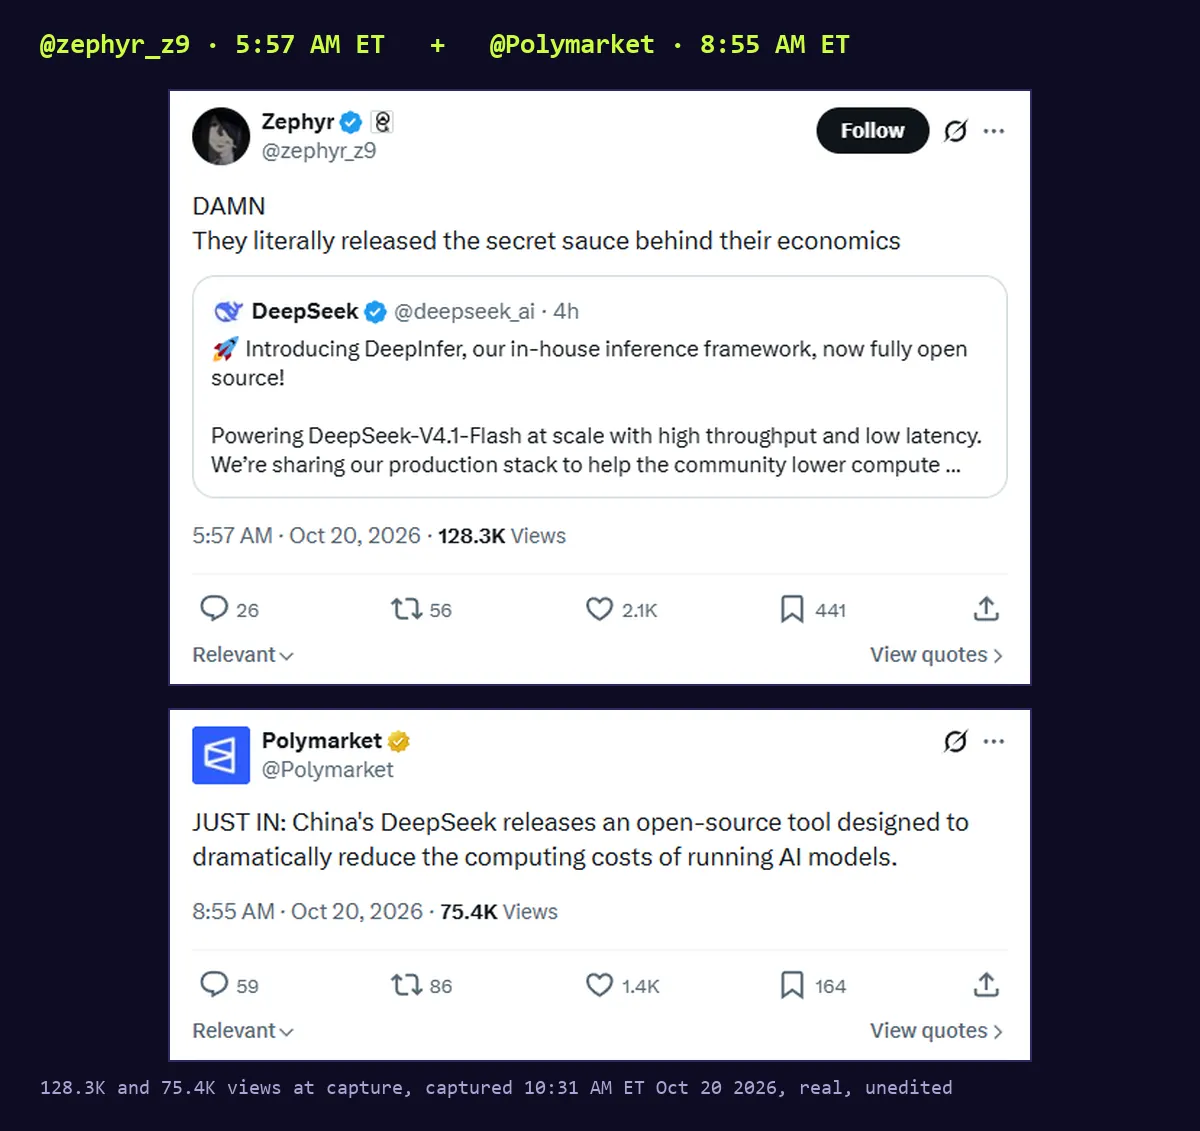
所以不,@zephyr_z9,他们并没有“literally release the secret sauce behind their economics”(真的把他们经济账背后的秘方公开了)。他们公开的是烤箱。把 GPU 变成每小时 38 美元的配方还在杭州。这依然是今年所有 AI 实验室送给开发者的最好礼物,但它依然不是帖子里说的那样东西。
“完全开源”?他们自己的 README 不同意
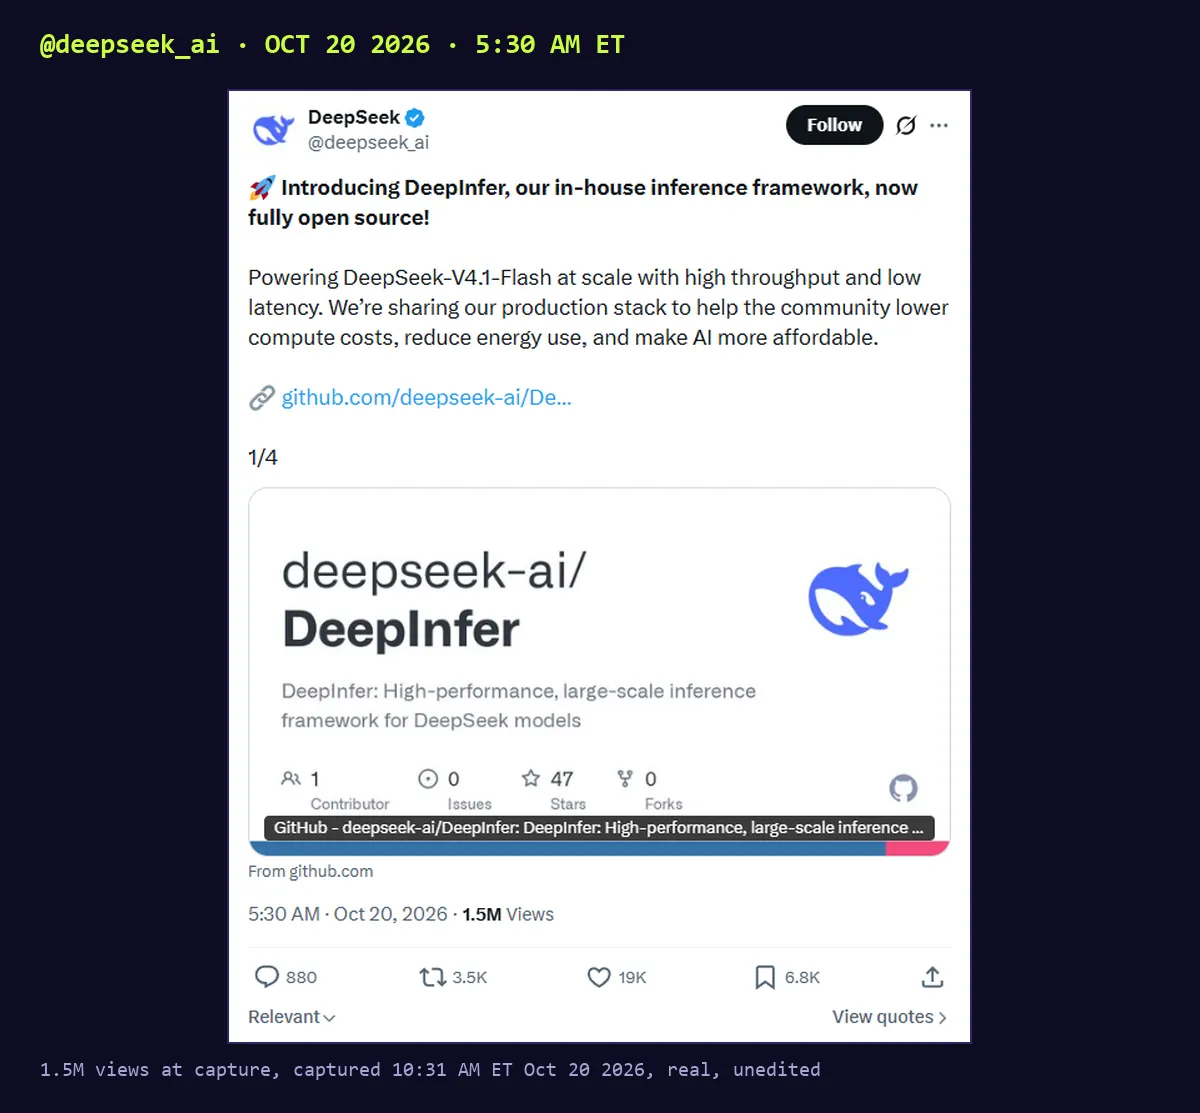
这是那条帖子,来自美东时间早上 5:30 的 @deepseek_ai。到上午 10:31,它已有 150 万浏览和 1.9 万点赞。到上午 10:33,仓库拿到了 8,663 颗星,Hacker News 上的讨论串排在第 1,有 1,222 分和 437 条评论。
现在打开 README。在“Supported hardware”(支持的硬件)下面有一个列表,标题原文是:"Required for a complete inference service (not included in this release)"(完整推理服务所需,不包含在本次发布中):
- "A KV cache system"(一套 KV cache 系统)
- "VE/Prefill/Decode disaggregation (most required engine functionality is already implemented)"(VE/Prefill/Decode 分离部署,所需的大部分引擎功能已实现)
- "Load balancing across data-parallel replicas for both prefill and decode"(prefill 和 decode 在数据并行副本之间的负载均衡)
README 的第一行也同样坦白:“This open-source release provides offline inference.”(本次开源发布提供的是离线推理。)仓库里没有 API 服务器。我 grep 过了:唯一的 HTTP 代码是一个用环境变量开启的性能分析端点。你可以在自己的集群上用 DeepInfer 跑提示词,但你没法让客户直接连上它。
把术语说成大白话。Prefill 是模型读你的提示词。Decode 是模型一个 token 一个 token 地写出回答。KV cache 是模型对已经读过的提示词做的笔记,这样就不用再读一遍。分离部署(disaggregation)是指 prefill 和 decode 跑在不同的机器上。负载均衡器决定你的请求交给哪台机器。正是这些东西,把一个引擎变成一门生意。
我把他们自己的架构图和仓库放在一起对照
DeepSeek 随发布一起公开了一份部署问答文档,里面有整个 V4.1 Flash 服务系统的架构图。我根据 README 的“不包含”列表和对代码的阅读,给每个模块做了标注。
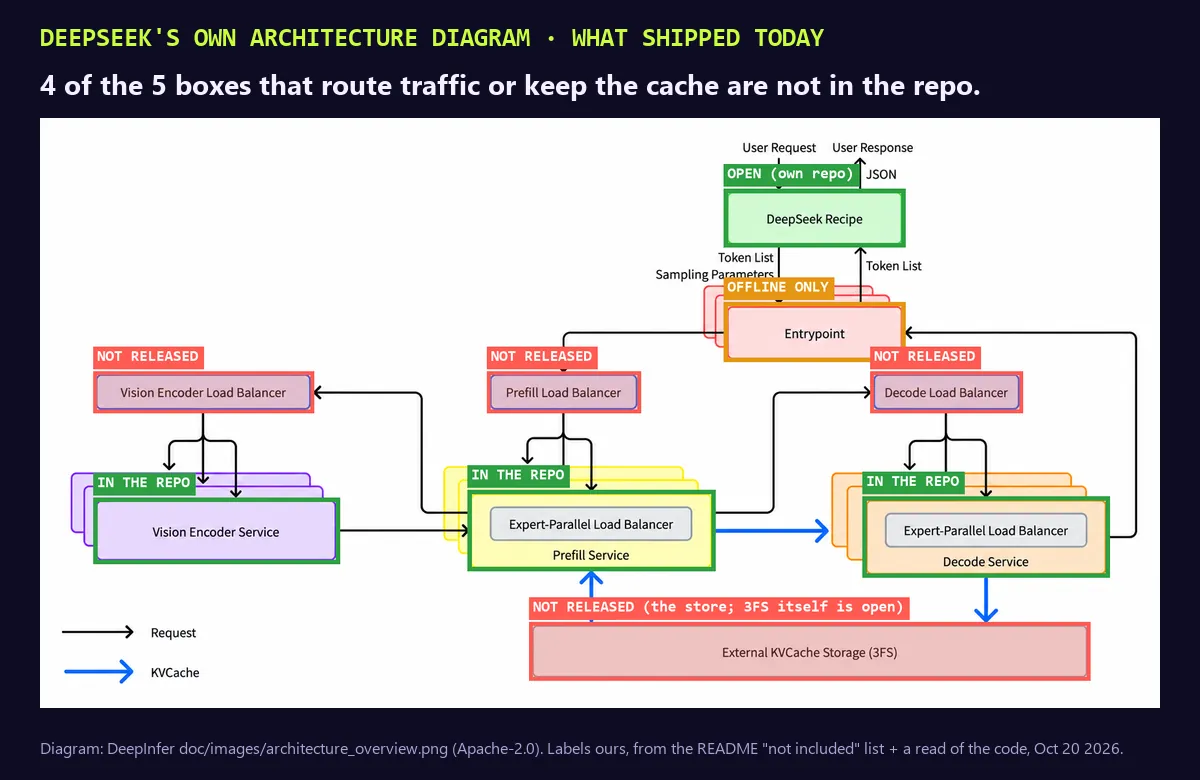
问答文档列出了负责流量路由或保存缓存的五个组件:Prefill 负载均衡器、Decode 负载均衡器、Vision Encoder 负载均衡器、专家并行负载均衡器,以及 KVCache 存储。只有专家并行那个被发布了(在 deepinfer/model_executor/eplb/ 里)。也就是 5 个里有 1 个。缓存底下的 3FS 文件系统从 2025 年 2 月起就开源了。但在它之上运行缓存的组件,也就是问答里叫 kvcache-store 的那个,不在仓库里。
DeepSeek 在问答里自己说明了原因,就在大多数人直接划过去的一段里:
"The KV cache management and load balancing components of the inference system are tightly coupled to our internal infrastructure, so that code is not yet fully open-sourced."(推理系统中的 KV cache 管理和负载均衡组件与我们的内部基础设施紧密耦合,因此这部分代码尚未完全开源。)
“尚未完全开源”和“现已完全开源”都是 DeepSeek 的原话,在同一个早上发布。只有其中一句出现在推文里。
秘方就是缓存,他们自己也这么说
正是这一点让那些“他们把经济账送出来了”的说法站不住脚。DeepSeek 为这个系统列了三个设计目标。第三个:"Retain KV cache for more than 72 hours"(KV cache 保留超过 72 小时),这样重复的提示词就能跳过昂贵的读取步骤。便宜的推理就是这么来的:同一个 50 页的代码库,你不用为读它付两次钱。
看看问答文档里说这些缺失部分值多少:
- 单个集群每天处理 155 万亿个 token。
- 每 GPU 小时 38 美元收入,“按低谷时段价格”(DeepSeek 的非高峰折扣价,所以大概是下限)。
- 负载均衡让他们达到完美均衡基准的约 80%。一堆 GPU 和一堆忙碌的 GPU 之间的差距,就是这门生意。
- 缓存存储按每块 GPU 14.4 TB 配置,服务器上装 20 块 30.73 TB 的 SSD,采用纠删码,11 个节点中任意 10 个都能响应。
再做一个评论区里没人做的对比。Google Cloud 出租的 B200 和 DeepInfer 的“SM100”目标同属 Blackwell 级别,价格是竞价实例每小时 $4.95,3 年合约 $7.09,1 年合约 $11.12(价格今天刚更新)。DeepSeek 的数字是 GPU 租金的 3.4 到 7.7 倍。收入不等于利润,而且 DeepSeek 是自有硬件而不是租的,但这个差价就是经济账本身。而这个差价,就藏在仓库里没有的那 4 个模块里。
一个我敢站住的暴论:@Polymarket 说的“dramatically reduce the computing costs of running AI models”(大幅降低运行 AI 模型的算力成本),大概只对地球上 50 家公司成立。原因如下。
像 DeepSeek 那样跑起来,起步就是 128 块 GPU
问答文档对最低配置说得很直白:“the smallest efficient deployment unit is 64 GPUs of prefill plus 64 GPUs of decode”(最小的高效部署单元是 64 块 GPU 做 prefill,加 64 块 GPU 做 decode)。README 的基准测试是“measured on 4 SM100 GPUs for prefill and 64 for decode”(在 4 块 SM100 GPU 上做 prefill、64 块上做 decode 测得)。Decode 需要 EP64 或更高(模型的专家分布在 64 到 128 块 GPU 上)。所以我算了一下账单。
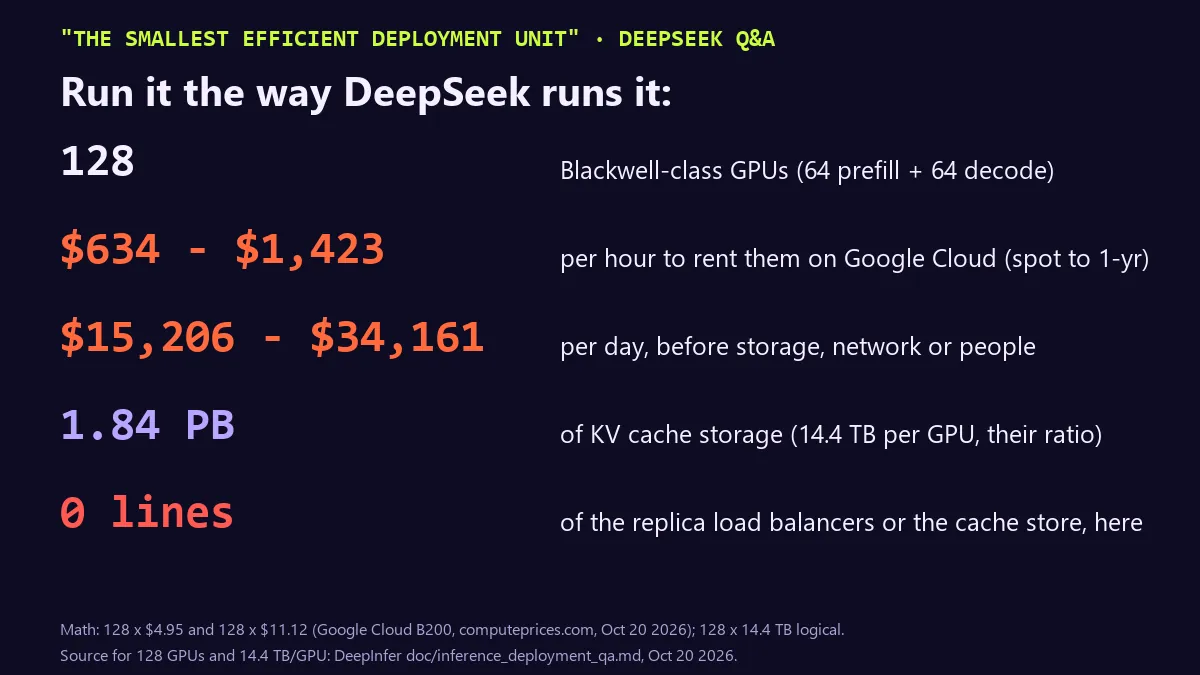
- 128 块 GPU x $4.95 到 $11.12 = 每小时 $634 到 $1,423。
- 也就是每天 $15,206 到 $34,161,还没算存储、网络,也没算一个工程师。
- 按他们每块 GPU 14.4 TB 的比例,需要 1.84 PB 的缓存存储。
- 再加上你现在得自己写的负载均衡器和缓存存储。
对比一下本周时间线上另一件 DeepSeek 的事:Unsloth 的 1-bit V4.1 Flash,从 508GB 压到 250GB,能在 128GB 以上内存的机器上运行。那才是大多数人真正会用到的开源模型。DeepInfer 是给云厂商用的。如果你是独立开发者,DeepSeek 给你的真正礼物依然是便宜的 API,而不是这个仓库。
他们的问答里甚至有整次发布中最好的一句话。能不能把 prefill 和 decode 拆到不同的数据中心?可以,但“at some cost in reliability, e.g., the fiber running between data centers is easily severed by construction work”(要牺牲一些可靠性,比如数据中心之间的光纤很容易被施工挖断)。致敬。这是一个被挖掘机毁过一整周的团队。
vLLM 说“主要基于 vLLM 构建”,我测出来是 6.82%
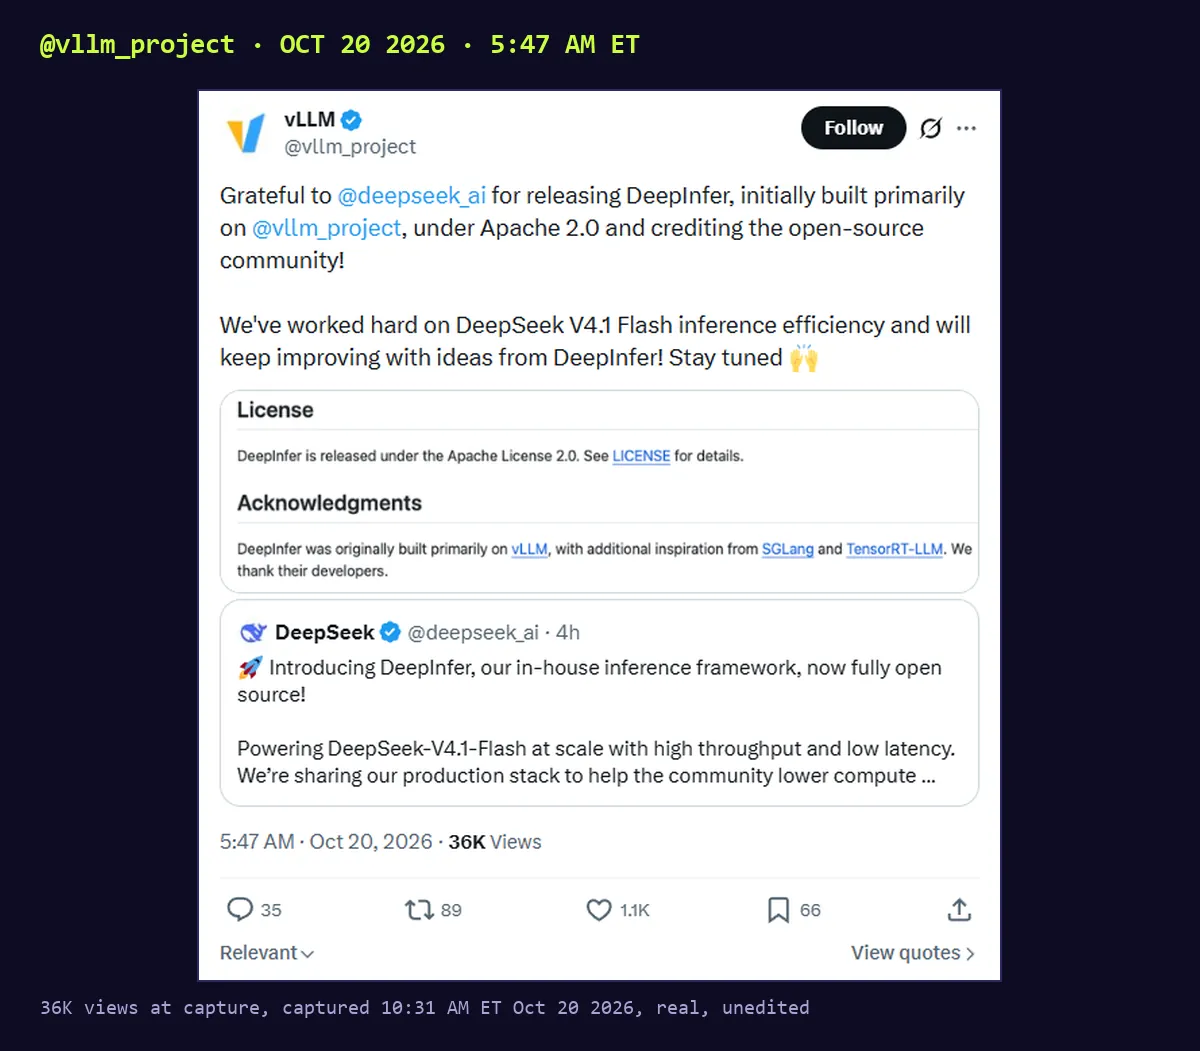
另一个重要反应来自 vLLM 团队,也就是业内大多数人在用的开源推理引擎。他们的帖子很大度,而 DeepSeek 的 README 也确实写了 DeepInfer “was originally built primarily on vLLM”(最初主要基于 vLLM 构建)。
于是我测了一下还剩多少 vLLM。我克隆了 DeepInfer(commit 774ce24),以及 vLLM 从 v0.2.0(2023 年)到今天 main 分支的九个版本。我取出 DeepInfer 的 deepinfer/ 包里每一行 25 个字符以上的 Python 代码,去掉注释和空行,合并空白字符,然后逐行检查它是否与每个 vLLM 版本中的某一行完全相同。脚本 60 行 Python,大约一分钟跑完,不需要 GPU。
def norm(l):
    l = l.strip()
    if not l or l.startswith('#'): return None
    if len(l) < 25: return None   # skip trivial lines
    return re.sub(r'\s+', ' ', l)

# every .py file in each vLLM tag, read straight out of git
p = subprocess.run(['git', '-C', VL, 'cat-file', '--batch'],
                   input='\n'.join(f'{ref}:{f}' for f in files).encode(),
                   capture_output=True)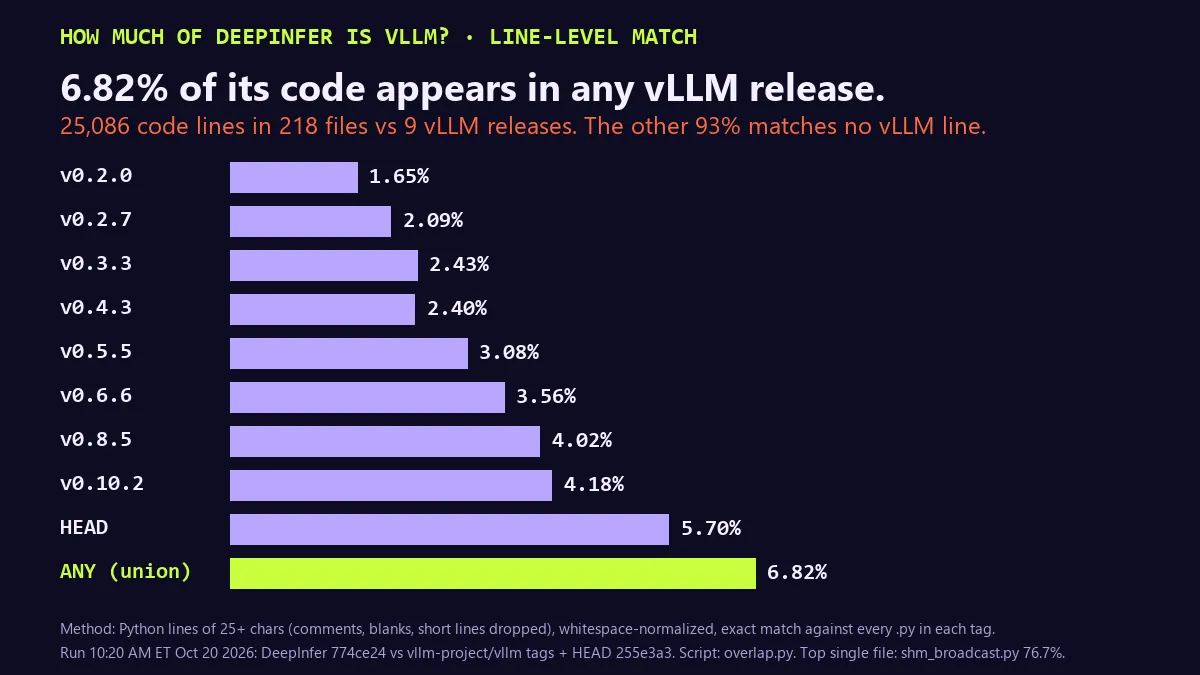
结果:25,086 行中有 1,711 行(6.82%)出现在至少一个 vLLM 版本里。单个版本里最高的是今天的 vLLM main,5.70%,这主要说明两个项目吸收了同样的新思路。vLLM 味最重的文件是 shm_broadcast.py,一个共享内存消息队列,76.7%。引擎核心 llm_engine.py 是 19.2%。V4 模型代码大约在 5% 到 12% 之间。
目录结构仍然带着 vLLM 的影子:worker/cache_engine.py、sequence.py、model_runner.py。这些都是 vLLM 在 2023 年用过的名字。但里面的代码已经被重写了。这种方法会漏掉改名的变量和重构,所以请把 6.82% 当作“家族相似度”的下限,而不是抄袭分数。我的看法:说“基于 vLLM 构建”,就像说一栋摩天大楼建在原来那片停车场上。没错,也很大度,而另外那 93% 是 DeepSeek 写的,这份功劳实实在在属于他们。
给华为的代码比给 Nvidia 的多 52%
下面是我认为这次发布真正的意义所在。DeepInfer 的自定义算子(做数学运算的小型 GPU 程序)在 tilelang_ops/ 里,每种芯片一个后端。同样 30 个算子,每个两个版本。我统计了非空行数。
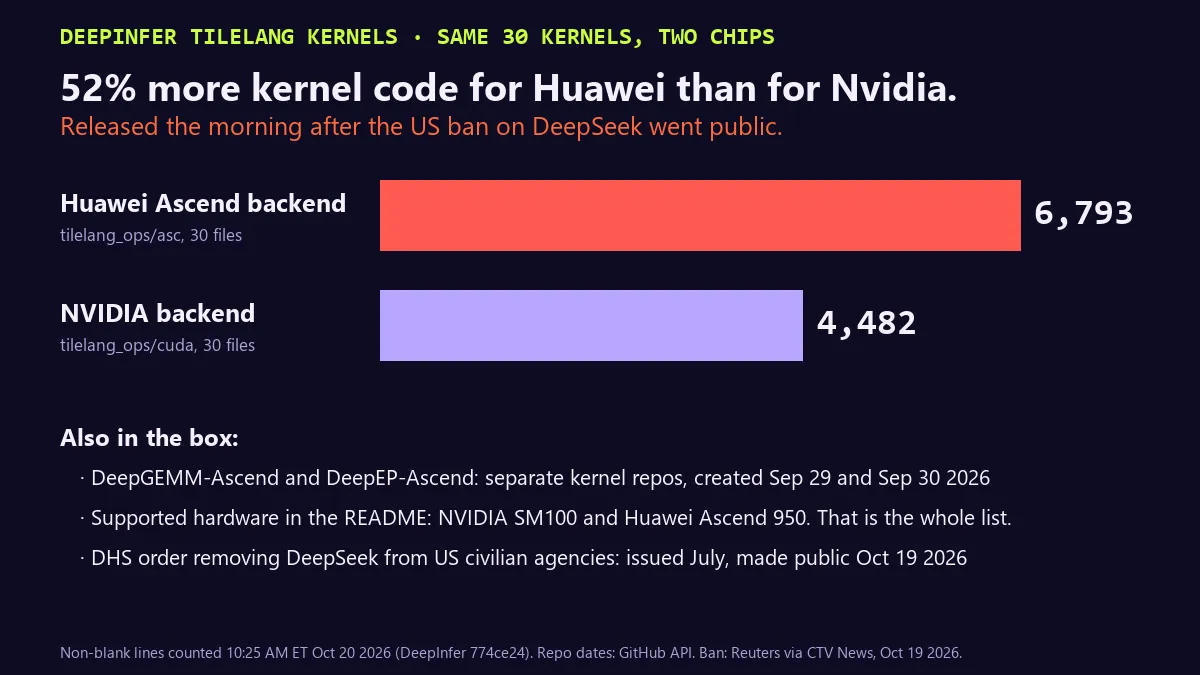
- 华为昇腾后端:6,793 行。NVIDIA 后端:4,482 行。多出 +51.6%。
- README 里支持的硬件:“NVIDIA SM100 GPUs”和“Huawei Ascend 950 NPUs”。就这些。没有 H100,没有 AMD。
- 昇腾算子库作为独立仓库发布:DeepGEMM-Ascend 和 DeepEP-Ascend,分别创建于 2026 年 9 月 29 日和 30 日,也就是今天的三周前。
- 发布前一天,路透社报道美国国土安全部正在命令联邦民事机构移除 DeepSeek 的产品以及基于其模型的第三方服务(7 月下达,10 月 19 日公开)。
- 同一天,The Information 报道(经 @unusual_whales 转发,14.9 万浏览),DeepSeek 和华为正联手设计新的 AI 芯片,以挑战 Nvidia。
多出的 52% 里,有一部分只是更年轻的芯片要付的代价:昇腾算子比 CUDA 算子更需要手把手照顾。但没人会为一款不打算继续推广的芯片写 6,793 行代码。下面是我认为真正在发生的事,他们永远不会说出口:这是一份套着 Apache 许可证的华为销售材料。现在,每一家想以 DeepSeek 的价格提供 DeepSeek 服务的中国云厂商,都有了一个能在美国断不了供的芯片上运行的生产级引擎。美国周一禁止联邦机构使用 DeepSeek,周二 DeepSeek 就让其他所有人用华为芯片部署它的模型变得更便宜。说实话,这是今年时机最准的一次开源发布。
再给“这是中国的生产系统,不是演示”这一说法加一条证据:包里 40,638 行非空代码中有 1,147 行带中文注释或文档字符串,比如 """compress 内核固定开启 fast math。"""。没人会为了发布博客写这种东西。整个提交历史只有 3 个 commit:美东时间凌晨 12:09 的一个“initial commit”,包含 345 个文件、63,326 行,然后是两次文档更新。它是今天早上从某个私有仓库导出来的。
依然比 OpenAI 更开放,这才是真正扎心的地方
对 DeepSeek 公平一点,对其他所有人就不那么公平了:OpenAI 的开源发布是 2025 年 8 月的 gpt-oss,权重以 Apache 2.0 发布,附参考代码。OpenAI、Anthropic 和 Google 为付费用户提供 ChatGPT、Claude 或 Gemini 服务的那套系统,一行代码都没公开过。而 DeepSeek 刚刚公开了引擎、算子、专家负载均衡器、一个主要用 Rust 写的分词服务(deepseek-recipe)、它的存储布局、每 GPU 小时收入,以及它的流量。
所以,选出你心中的反派吧。是那个发布了 93% 的生产引擎却说成 100% 的实验室,还是那些发布 0% 却自称好人的实验室?
今日观点排行
- 错得最离谱:@zephyr_z9,“They literally released the secret sauce behind their economics”(12.8 万浏览)。秘方是 72 小时缓存和四个负载均衡器,一个都没发布。
- 对大多数读者来说错得最离谱:@Polymarket,“dramatically reduce the computing costs of running AI models”(7.5 万)。对任何手里有 128 块 Blackwell 和一个 PB 的 SSD 的人来说,当然。
- 最大度:@vllm_project,“initially built primarily on vLLM”。今天是 6.82%。地基的功劳你们拿走,楼是 DeepSeek 的。
- 最准确:DeepSeek 自己的 README。那个团队里有人用大白话写了“not included in this release”(不包含在本次发布中)。写宣传帖的人没读它。
目前的数字
- DeepSeek 路由/缓存层中已发布的模块:5 个中的 1 个(EPLB),10 月 20 日美东时间上午 10:25 读取
- 在 9 个 vLLM 版本中任一版本出现过的 DeepInfer 代码行:25,086 行中的 1,711 行(6.82%)
- 算子代码行数,华为昇腾 vs NVIDIA:6,793 vs 4,482(+51.6%)
- DeepSeek 每 GPU 小时收入:$38(他们的问答文档),对比在 Google Cloud 租一块 B200 的 $4.95 到 $11.12
- 最小高效部署:128 块 GPU,每小时 $634 到 $1,423
- 星数:美东时间上午 10:33 为 8,663,距第一个 commit 约 10 小时
我的赌注,以及轮到你了
预测:到 11 月 30 日,vLLM 和 SGLang 会吸收 DeepInfer 的大部分技巧(draft token 解码、有界 SWA 重放),美国云厂商部署 V4.1 Flash 的速度会比今天更快。而到 12 月 31 日,中国以外没有人能像 DeepSeek 那样运行它,带着 72 小时缓存和四个负载均衡器,因为 DeepSeek 把这些留下了。如果我错了,把集群拿给我看,我会写一篇更正,标题里带上你的名字。
轮到你了:一个连一个 API 请求都没法服务的发布,称为“完全开源”公平吗?在评论里回答是或否,并说说理由。@deepseek_ai,也欢迎你们来回答。
想知道通过 API 用 V4.1 Flash 和自己租 GPU 相比要花多少钱?LLM API 成本计算器($7,Google Sheets + Excel,26 个模型)在一张表里算出每次请求的费用。免费版在网站上:tensorust.com/tools/llm-api-cost/。
tensorust.com 上的相关阅读:Meta 开源了一个 816B 模型,运行它大约需要 1TB 内存、LLM 代理基准测试:200 次重复调用变成 1 次,以及 Theo 的 60% 数据其实是一张宕机图。
方法与数据:DeepInfer 克隆于 774ce24(2026 年 10 月 20 日),vllm-project/vllm 标签 v0.2.0、v0.2.7、v0.3.3、v0.4.3、v0.5.5、v0.6.6、v0.8.5、v0.10.2 以及 main 255e3a3。所有统计在 2026 年 10 月 20 日美东时间上午 10:20 至 10:35 之间完成。X 截图于美东时间上午 10:31 截取,真实未经编辑。GPU 价格来自 computeprices.com 的 Google Cloud B200 页面,更新于 2026 年 10 月 20 日。
2026 年 10 月 20 日首发于 tensorust.com。同时发布在 X (@TensorustAI)、X (@MattBusel) 和 dev.to。相关链接:免费的 LLM API 成本计算器、Meta 816B 需要 1TB 内存、LLM 代理基准测试。
更多:作者、相关阅读、分享本文、一款免费游戏
接着读
免费工具:LLM API 成本计算器 → 输入 token 数、输出 token 数和每天的请求量,算出 24 个 GPT、Claude 和 Gemini 模型的月度成本。
- AI · 2026 年 10 月 21 日 · 阅读约 11 分钟LiteLLM 又被植入后门了。5 分钟查清它有没有拿走你的密钥
- AI · 2026 年 10 月 19 日 · 阅读约 13 分钟Theo 的 60% 数据其实是一张宕机图:43 小时的 Codex 故障
- AI · 2026 年 10 月 18 日 · 阅读约 13 分钟带抖动的指数退避:100 次 LLM 调用仍有 64 次失败