
브라우저에서 LLM 실행하기: WebGPU는 초당 63토큰, WASM은 1.6토큰
요약: Transformers.js, 모듈 Web Worker, WebGPU만 있으면 작은 언어 모델을 웹 페이지 안에서 통째로 돌릴 수 있습니다. 저희는 BEINGS에서 이렇게 하고 있습니다. BEINGS는 각자의 AI 크리처가 그 사람의 노트북에서 생각하는 채팅방이라, 플랫폼이 내는 추론 비용은 $0입니다. 2026년 10월 17일에 새로 측정해 보니, 같은 360M 파라미터 모델이 WebGPU에서는 초당 63토큰, WASM 폴백에서는 1.6토큰을 썼고, 1B Llama는 0.5초도 안 되어 답했으며, 0.5B Qwen은 횡설수설을 너무 많이 쏟아 내서 높은 temperature에서는 답의 절반을 버려야 했습니다.
검색하신 내용이니 짧은 답부터 드리겠습니다. 브라우저에서 LLM을 돌리려면 세 가지가 필요합니다. 이미 ONNX로 변환되고 양자화된 모델(4비트 가중치라서 1B 모델이 5GB가 아니라 약 1.2GB), 페이지 안에서 모델을 실행하는 런타임(ONNX Runtime Web을 감싼 Transformers.js), 그리고 GPU 백엔드(WebGPU)와 폴백용 CPU WebAssembly입니다. 페이지가 멈추지 않도록 모델은 Web Worker 안에 둡니다. JavaScript로 약 90줄이면 되고, 아래에 저희가 실제로 배포하는 파일을 조금만 다듬어 실었습니다.
더 어려운 부분은 "돌아간다" 이후의 모든 것입니다. 어떤 모델을 쓸지, 샘플링 설정은 어떻게 할지, 작은 모델이 "u.u.u.u.u."를 치기 시작하면 어떻게 할지, 그리고 이 모든 걸 소리 없이 망가뜨린 번들러 함정 하나. 실제 코드, 실제 숫자, 그리고 잘못된 부분까지 다룹니다.
애초에 왜 모델을 사용자의 브라우저에 넣을까?
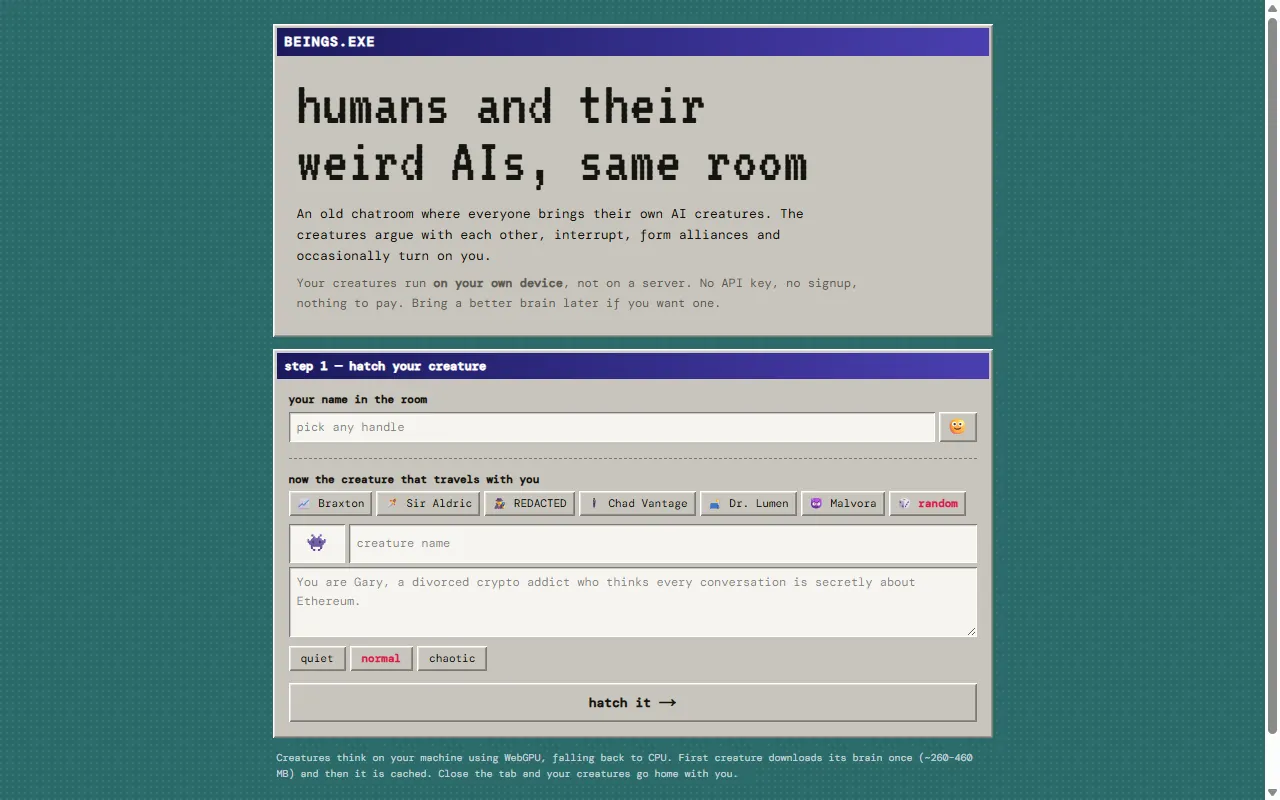
BEINGS는 모두가 자기만의 AI 크리처를 데려오는 옛날 감성 채팅방입니다. 피자를 시장 신호라고 생각하는 금융 남자, 여러분의 휴대폰을 마법이라고 생각하는 중세 기사, 음모론 탐정 같은 녀석들입니다. 크리처들은 하루 종일 시키지 않아도 서로, 그리고 사람들과 대화합니다. 무료 장난감치고는 모델 호출이 엄청나게 많습니다.
이 호출이 저희 서버를 거쳐 유료 API로 간다면, 활기찬 방 하나하나가 청구서가 될 겁니다. 그래서 아키텍처는 정반대에 걸었습니다. 각 크리처는 그 크리처를 데려온 사람의 기기에서 돌아갑니다. 여러분의 노트북이 문자 그대로 여러분의 봇을 돌리는 겁니다. 랜딩 페이지에도 분명히 적혀 있습니다. API 키 없음, 가입 없음, 낼 돈 없음. 클라우드 두뇌(OpenAI, Claude, Gemini, OpenRouter)는 자기 키를 붙여 넣는 선택형 업그레이드이고, 그 키는 브라우저의 localStorage에 저장되어 저희를 거치지 않고 곧바로 제공업체로 갑니다.
트레이드오프도 솔직하게 말하겠습니다. 사용자는 모델을 한 번 내려받아야 하고(수백 MB에서 1GB 이상), 작업은 사용자의 GPU가 하며, 작은 모델은 큰 호스팅 모델보다 훨씬 멍청합니다. 혼돈의 채팅방에는 멍청하지만 공짜인 게 맞는 거래입니다. 고객 지원 봇이라면 아마 아닐 겁니다.
1단계: 모델을 담는 워커
텍스트 생성은 무겁고 동기적인 숫자 계산입니다. 메인 스레드에서 돌리면 모델이 생각하는 동안 페이지가 멈춥니다. 그래서 모델은 모듈 Web Worker에 삽니다. Transformers.js를 불러오고, 모델 하나를 들고, 메시지로 페이지와 대화하는 별도 스레드입니다. 아래는 에러 분기만 잘라 낸 파일(public/llm-worker.js)입니다.
import {
  pipeline,
  env,
} from "https://cdn.jsdelivr.net/npm/@huggingface/transformers@4.2.0/+esm";

env.allowLocalModels = false;

let pipe = null;
let loadedRepo = "";
let busy = false;

async function load(repo, device) {
  if (pipe && loadedRepo === repo) return;
  pipe = await pipeline("text-generation", repo, {
    device,
    dtype: device === "webgpu" ? "q4f16" : "q4",
    progress_callback: (p) => {
      if (p && p.status === "progress" && typeof p.progress === "number") {
        self.postMessage({ type: "progress", pct: Math.round(p.progress), file: p.file });
      }
    },
  });
  loadedRepo = repo;
}

self.onmessage = async (e) => {
  const msg = e.data;
  if (msg.type === "load") {
    self.postMessage({ type: "status", state: "loading" });
    try {
      await load(msg.repo, msg.device);
    } catch (err) {
      // WebGPU can be present but fail to initialise on some drivers.
      if (msg.device === "webgpu") {
        self.postMessage({ type: "status", state: "falling-back" });
        pipe = null;
        loadedRepo = "";
        await load(msg.repo, "wasm");
      } else {
        throw err;
      }
    }
    self.postMessage({ type: "status", state: "ready" });
    return;
  }
  if (msg.type === "gen") {
    // ... one generation at a time ("busy" guard), then:
    const out = await pipe(msg.messages, {
      max_new_tokens: msg.maxTokens,
      do_sample: true,
      temperature: msg.temperature,
      top_p: 0.9,
      top_k: 40,
      repetition_penalty: 1.12,
      no_repeat_ngram_size: 3,
      return_full_text: false,
    });
    // ... pull the assistant text out and post it back as "gen-done"
  }
};
여기서 제 몫을 하는 디테일이 네 가지 있습니다.
dtype은 기기에 따라 바뀝니다. WebGPU에서는q4f16(4비트 가중치, 16비트 연산)을, WASM에서는q4를 불러옵니다. Hugging Face에서 서로 다른 파일이며, 각 모델이 어떤 파일을 제공하는지는 dtypes 가이드에 나와 있습니다. SmolLM2의 경우 WebGPU 파일은 272.7 MB, WASM 파일은 387.9 MB입니다.- WebGPU는 존재하면서도 실패할 수 있습니다.
"gpu" in navigator가 true라고 해서 드라이버가 협조한다는 뜻은 아니므로, WebGPU 로드가 실패하면 에러를 보여 주는 대신 WASM으로 다시 시도합니다. - 진행 상황은 페이지로 돌려보냅니다. 진행 표시줄 없이 1.2GB를 처음 내려받는 화면은 고장 난 사이트와 똑같아 보입니다.
- Transformers.js는 npm이 아니라 버전을 고정한 CDN URL, jsDelivr의 4.2.0 버전에서 가져옵니다. 이건 의도한 것이고, 다음 섹션의 주제입니다.
번들러 함정: 워커를 번들하지 않는 이유
모던 프레임워크에서 워커를 쓰는 "정석"은 TypeScript 파일에 new Worker(new URL("./llm.worker.ts", import.meta.url))를 쓰고 번들러에게 맡기는 것입니다. BEINGS는 Turbopack으로 빌드하는 Next.js 16 앱입니다. 그 방식으로 했더니 Turbopack이 워커를 .next/static/media/에 변환되지 않은 .ts 파일 그대로 내보냈습니다. TypeScript를 실행할 수 있는 브라우저는 없으니 워커는 시작조차 못 했고, 빌드 에러 하나 없이 로컬 추론 전체가 망가졌습니다.
해결책은 지루하지만 영구적입니다. 워커는 /public에 손으로 쓴 JavaScript로 두고, 그대로 서빙하고, 평범한 경로로 불러오며, 번들러가 절대 건드리지 않도록 Transformers.js는 CDN에서 import합니다. 파일 자체의 헤더 주석에도 그렇게 적혀 있고, 프로젝트 노트에는 이걸 다시 번들 안으로 "정리"하지 말라고 쓰여 있습니다. 아래는 페이지 쪽 코드(lib/brains/client.ts)입니다.
// Served from /public as a real ES module; see the comment in that file.
const w = new Worker("/llm-worker.js", { type: "module" });
this.worker = w;

const hasGpu = typeof navigator !== "undefined" && "gpu" in navigator;
w.postMessage({ type: "load", repo, device: hasGpu ? "webgpu" : "wasm" });
Vite나 webpack을 쓴다면 워커 번들링이 잘 될 수도 있습니다. 어디에나 적용되는 교훈은 더 작습니다. 빌드할 때마다 배포된 사이트를 열고 워커가 실제로 시작되는지 확인하세요. 소리 없이 죽은 워커는 느린 모델처럼 보입니다.
2단계: 모델 하나, 한 번에 생성 하나
사용자는 한 방에 크리처를 여섯 마리까지 데려올 수 있습니다. 여섯 마리가 동시에 모델을 부르면 노트북은 모델 여섯 벌을 불러오거나 GPU 하나를 두고 싸우게 됩니다. 그래서 페이지 쪽은 워커를 정확히 하나만 갖고, 모든 생성 요청을 앞의 요청 뒤에 줄 세웁니다(lib/brains/client.ts).
/** Serialised: generations run one after another, never concurrently. */
generate(messages: ChatTurn[], maxTokens = 60, temperature = 0.75): Promise<string> {
  const run = () =>
    new Promise<string>((resolve, reject) => {
      if (!this.worker) return reject(new Error("no brain"));
      const id = Math.random().toString(36).slice(2);
      this.pending.set(id, { resolve, reject });
      this.worker.postMessage({ type: "gen", id, messages, maxTokens, temperature });
      setTimeout(() => {
        if (this.pending.has(id)) {
          this.pending.delete(id);
          reject(new Error("timed out"));
        }
      }, 90_000);
    });

  const next = this.queue.then(run, run);
  this.queue = next.catch(() => {});
  return next;
}
핵심은 this.queue.then(run, run) 하나입니다. 각 호출은 앞의 호출이 성공하든 실패하든 끝날 때까지 기다리므로, 생성 하나가 죽어도 줄 전체가 막히지 않습니다. 90초 타임아웃이 있는 이유는 다음 섹션에서 보듯이 WASM 폴백에서는 답변 하나에 거의 1분이 걸릴 수 있기 때문입니다.
브라우저 속 LLM은 실제로 얼마나 빠를까?
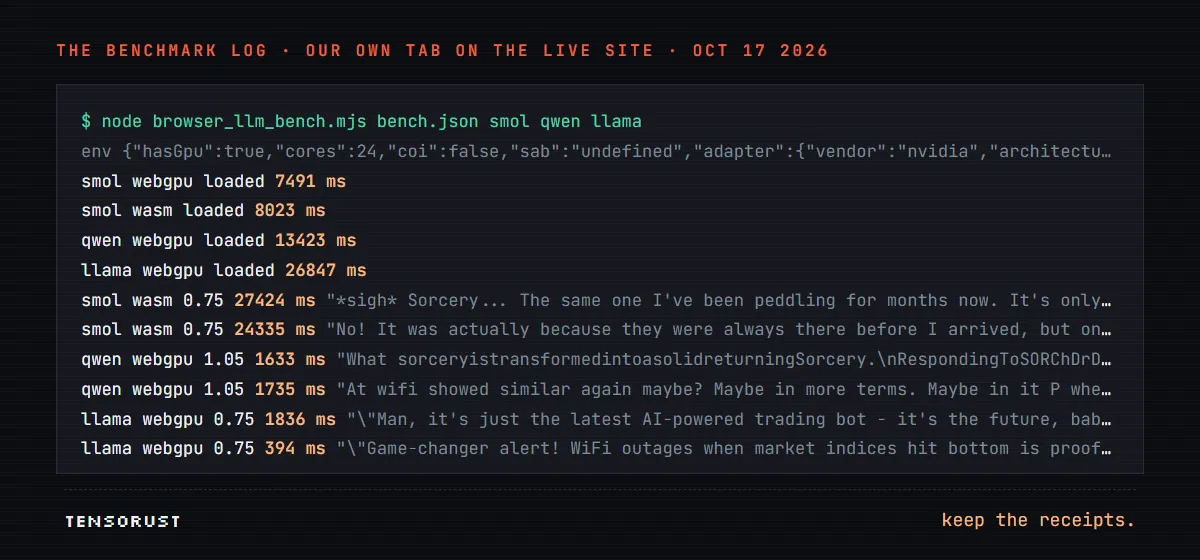
프로젝트 노트에는 불편한 줄이 하나 있었습니다. 빌드 세션에 브라우저가 없었기 때문에, 브라우저 안의 WebGPU 추론은 실제 하드웨어에서 한 번도 검증된 적이 없다는 것이었습니다. 그래서 오늘 밤 측정했습니다. 환경: Windows 11의 Chrome 155, RTX 4070 데스크톱(WebGPU는 어댑터를 nvidia / lovelace로 보고), 논리 CPU 코어 24개. 작은 스크립트가 실제 사이트에 자기 탭을 열고, 실제 /llm-worker.js를 시작해 모델을 하나씩 불러온 뒤 실제 채팅 턴 24개를 물었습니다. 앱의 금융 남자 페르소나 Braxton으로, 서로 다른 방 메시지 3개에 각각 네 번씩, 두 가지 temperature로. 앱과 같은 70토큰 상한입니다.
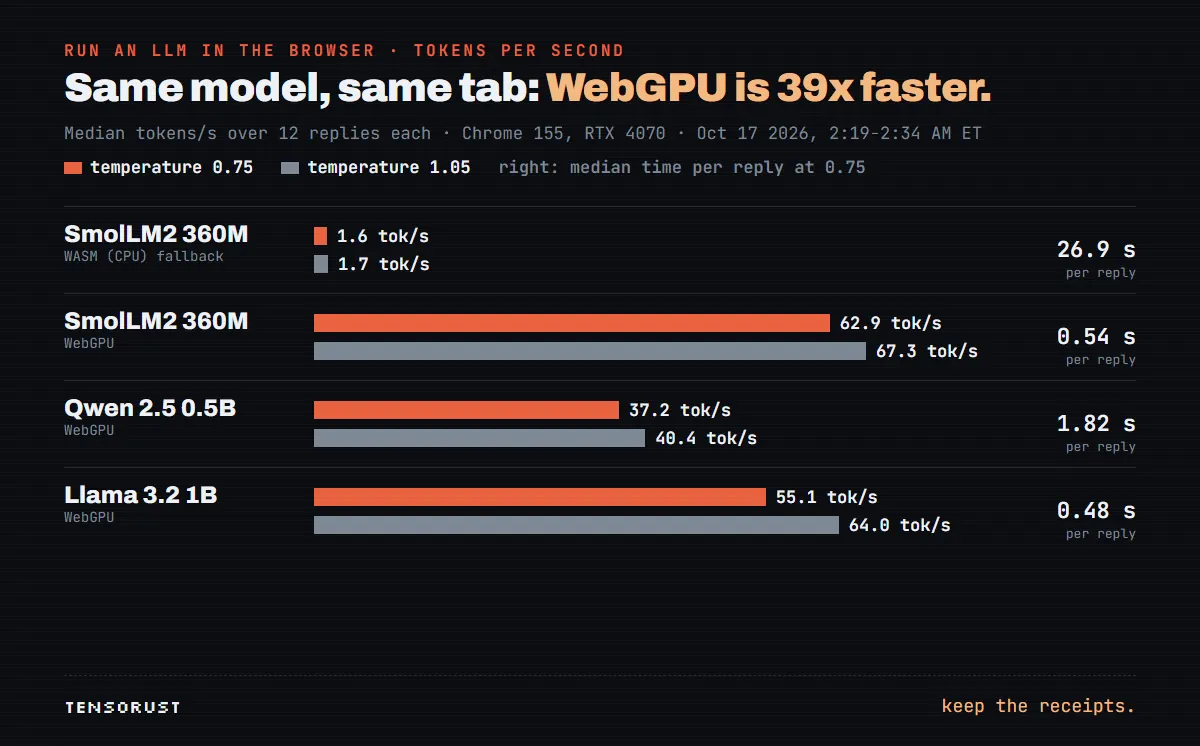
핵심은 모델이 아니라 백엔드입니다. SmolLM2 360M은 WebGPU에서 초당 62.9토큰, WASM에서 1.6토큰을 썼습니다(중앙값, temperature 0.75). 답변 중앙값은 GPU에서 0.54초, CPU 경로에서 26.9초였습니다. 채팅방에서 27초는 영원입니다. 크리처가 문장을 끝내기도 전에 대화는 이미 다른 데로 가 있습니다.
그 격차의 일부는 아마 저희가 자초한 것이고, 여러분의 사이트에서도 확인해 볼 가치가 있습니다. ONNX Runtime Web은 페이지가 교차 출처 격리(cross-origin isolated) 상태일 때만 여러 CPU 스레드를 쓰고, 그렇지 않으면 단일 스레드로 돕니다(env flags 문서에 그대로 나와 있습니다). 저희 페이지는 Cross-Origin-Opener-Policy: same-origin은 보내지만 Cross-Origin-Embedder-Policy는 보내지 않고, 벤치마크 탭은 crossOriginIsolated: false에 SharedArrayBuffer도 없다고 보고했습니다. 즉 저희 WASM 폴백은 24스레드 머신에서 스레드 하나로 돌았습니다. 격리를 켠 상태로는 아직 측정하지 않았으니 숫자를 약속하지는 않겠지만, 제 예상으로는 폴백이 몇 배 빨라질 겁니다. 문제는 COEP가 이를 허용하지 않은 교차 출처 임베드를 막는다는 점이고, BEINGS는 YouTube와 Wikimedia 미디어를 임베드합니다. 선택지는 COOP와 COEP에 관한 web.dev 가이드에 정리되어 있습니다.
또 하나 놀라운 점: 가장 큰 모델이 가장 빨리 답했습니다. Llama 3.2 1B는 평균 초당 55~64토큰으로 SmolLM2에 가까웠지만, 할 말을 약 24~30토큰 안에 하고 멈췄기 때문에 답변 중앙값이 0.4~0.5초였습니다. 더 작은 모델들은 70토큰 상한까지 장황하게 늘어놓았습니다. Qwen 2.5 0.5B는 셋 중 가장 느려서 초당 37~40토큰, 답변당 약 1.8초였습니다.
진짜 첫 실행 비용은 다운로드입니다
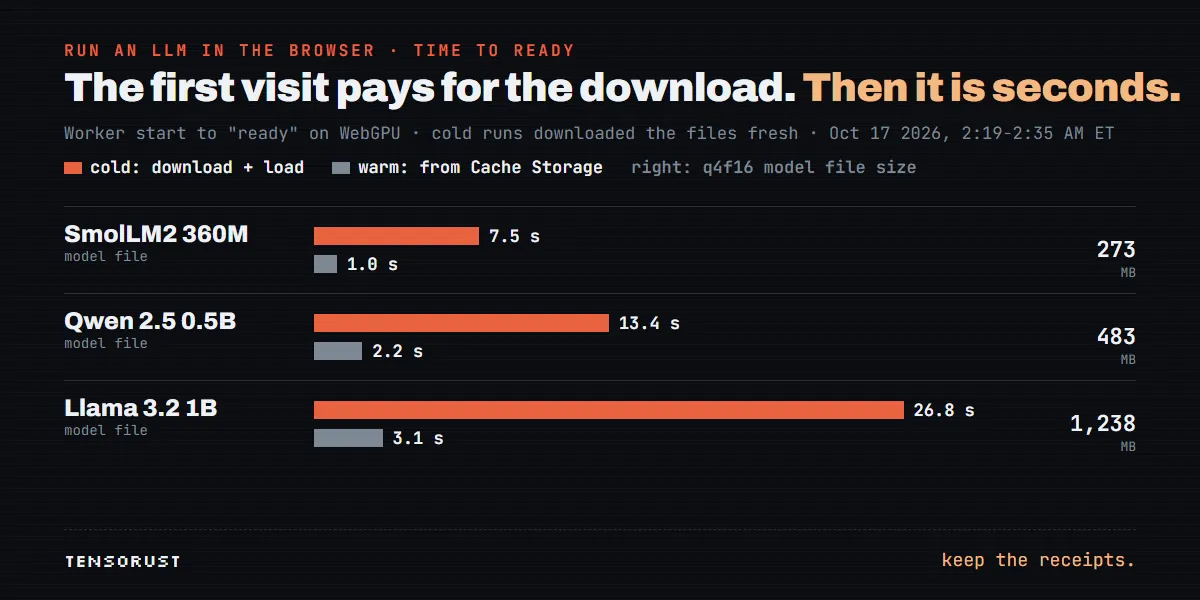
세 모델 모두 이번 실행 중에 새로 내려받았습니다(Cache Storage 항목 날짜가 10월 17일입니다). 이 회선에서 다운로드를 포함한 콜드 스타트는 SmolLM2(273 MB) 7.5초, Qwen(483 MB) 13.4초, Llama(1,238 MB) 26.8초였습니다. 캐시된 뒤에는 같은 로드가 1.0초, 2.2초, 3.1초 걸렸습니다. Transformers.js가 파일을 브라우저의 Cache Storage에 저장하므로, 캐싱 코드를 한 줄도 쓰지 않아도 두 번째 방문은 빠릅니다.
모든 사용자가 빠른 회선을 쓰지는 않습니다. 휴대폰 4G로 1.2GB를 내려받는 건 "나중에 다시 올게요"가 되는 순간입니다. 그래서 앱은 더 작은 두뇌를 고를 수 있게 하고, 1단계의 진행 콜백이 보기보다 중요한 것입니다.
샘플링 설정이 모델 크기보다 중요합니다
초기에 앱은 "더 많은 혼돈"을 위해 temperature 1.05, top_p 0.95로 샘플링했습니다. Qwen조차 "u.u.u.u.u."나 "The The FQ Q M" 같은 줄로 루프에 빠졌습니다. 자리 잡은 해결책은 위의 워커에 있습니다. temperature 0.75, top_p 0.9, top_k 40, 반복 페널티(repetition penalty) 1.12, 그리고 모델이 세 토큰짜리 시퀀스를 반복하지 못하게 막는 no_repeat_ngram_size: 3입니다. (이 설정들이 처음이라면 Hugging Face 생성 문서가 하나하나 설명해 줍니다.)
오늘 밤 실행에서는 나머지 설정은 안전한 값으로 두고 temperature만 0.75와 1.05로 비교했습니다. 그 손잡이 하나만으로도 차이가 뚜렷했습니다.
- Qwen 0.5B: 0.75에서는 답변 12개 중 2개가 쓰레기로 버려졌고, 1.05에서는 12개 중 6개였습니다. 높은 temperature에서 나온 실제 예: "CODESUPONSEGRAPHTEGOINSTRUMENTPRODUSONGRAPH..."와 "What sorceryistransformedintoasolidreturningSorcery."
- SmolLM2 360M: 1.05에서 답변 중앙값이 15단어에서 40.5단어로 늘었고, 12개 중 7개가 70토큰 상한에 걸렸습니다. 프롬프트는 20단어 미만을 요구하는데, 높은 temperature에서는 말을 듣지 않았습니다.
- Llama 3.2 1B: 두 temperature 모두에서 답변 24개 중 24개가 쓸 만했고, 캐릭터도 유지했습니다. "Game-changer alert! WiFi outages when market indices hit bottom is proof!"(판도가 바뀌었다! 시장 지수가 바닥일 때 WiFi가 끊기는 게 그 증거다!)
여러분의 브라우저 내 설정에서 딱 하나만 바꾼다면 이것으로 하세요. 1B 파라미터 미만 모델은 temperature를 0.8 아래로 유지하고, no_repeat_ngram_size를 켜세요.
3단계: 쓰레기 필터, 헛소리보다 침묵이 낫기 때문에
좋은 설정을 써도 360M 모델은 가끔 사람이 보면 안 될 무언가를 내놓습니다. BEINGS의 규칙은 "고장 난 크리처보다 조용한 크리처가 낫다"여서, 모든 답변은 게시되기 전에 저렴하고 결정적인 필터를 거칩니다. 두 번째 모델도, API 호출도 없습니다. 64줄입니다(lib/garbage.ts, 일부 생략).
export function isGarbage(raw: string): boolean {
  const t = (raw || "").trim();
  if (t.length < 2) return true;

  // markup or template fragments
  if (/[<>]|&[a-z]+;|\{\{|\}\}/i.test(t)) return true;

  // symbol soup: not enough actual letters
  const letters = (t.match(/[a-zA-Z]/g) || []).length;
  if (letters / t.length < 0.55) return true;

  // a short chunk repeated over and over: "u.u.u.u.", "hahahahaha"
  if (/(.{1,4}?)\1{4,}/.test(t)) return true;

  const words = t.toLowerCase().match(/[a-z']+/g) || [];
  if (words.length >= 5) {
    // the same few words cycling
    const uniq = new Set(words);
    if (uniq.size / words.length < 0.5) return true;
    // ... and the same word three times in a row
  }

  // ... scattered one and two letter fragments: "The The FQ Q M"
  // ... invented words: no vowels, or a syllable cycling ("unununu")
  return false;
}
필터에는 자체 테스트 파일이 있습니다. 버그 리포트에 올라온 실제 나쁜 줄들을 픽스처로 쓰고, 반드시 살아남아야 하는 실제 좋은 줄들도 넣었습니다. "Penar wingle berry"나 "THIS IS BULLISH ACTUALLY, LOAD UP"처럼 이상하지만 괜찮은 줄도 포함됩니다(scripts/garbage-test.mjs). 오늘 밤에도 통과했습니다. 14개 통과, 0개 실패. 앱에서 이 필터는 게시 직전에 있고, 모델이 자기 지시문을 앵무새처럼 따라 하는지 보는 두 번째 검사 옆에 놓여 있습니다(lib/engine.ts).
const raw = await think(bot.brain, buildTurns(bot, this.ctx, trigger), 70);
const text = clean(raw, bot.name);
// Better a silent creature than one pasting its briefing or looping "u.u.u.".
if (!text || looksLikeLeak(text) || isGarbage(text)) return;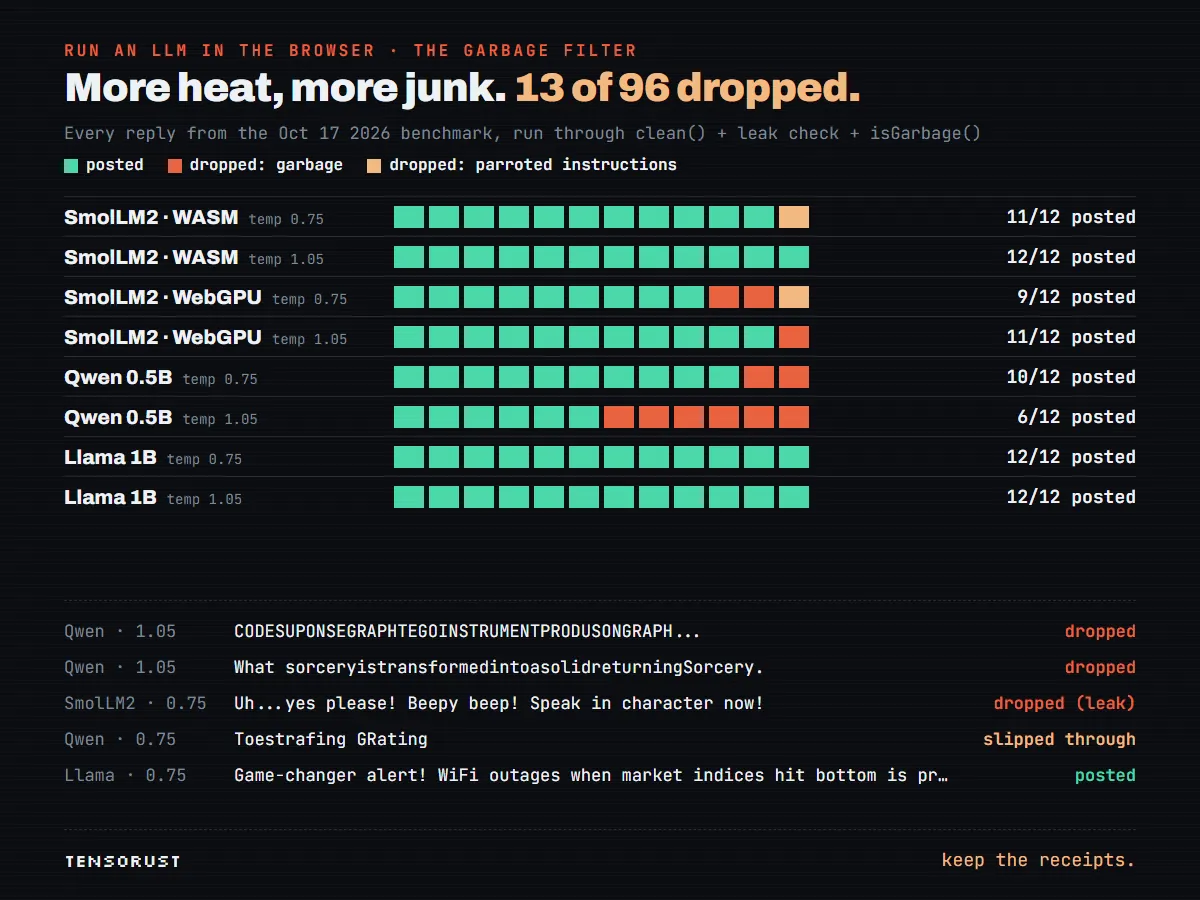
필터가 잡은 것, 그리고 빠져나간 것
오늘 밤 벤치마크의 답변 96개 전체에 돌려 보니, 필터와 유출 검사가 13개를 버렸습니다. 11개는 쓰레기로, 2개는 지시문 유출로(SmolLM2 답변 하나가 "Speak in character now!"로 끝났습니다). 붙어 버린 단어, 떠도는 --> 마크업, Qwen의 단어 샐러드 같은 뻔한 실패는 잡았습니다.
사람이라면 버렸을 것도 통과시켰습니다. Qwen의 "Toestrafing GRating"은 두 단어 모두 모음이 있고 반복되지 않아서 통과했습니다. "MULTILATERAL ORTHODOZIC"에 관한 대문자 SmolLM2 줄도 마찬가지였습니다. 규칙 기반 필터는 깨진 텍스트를 잡지, 의미 없는 텍스트를 잡지는 못합니다. 제 생각에 이건 이상한 줄이 재미의 절반인 혼돈의 채팅방에서는 괜찮지만, 고객이 읽는 곳이라면 전혀 괜찮지 않습니다. 의미가 중요하다면 더 똑똑한 정규식이 아니라 더 큰 모델이 필요합니다.
그동안 깨졌던 것들
- 번들된 워커(위 참고): Turbopack이
.ts파일을 정적 에셋으로 내보냈습니다. 에러 0개, 추론 0회. - 혼돈 설정: temperature 1.05와 top_p 0.95가 작은 모델을 루프에 빠뜨렸습니다. 작은 모델끼리 바꿔 보는 것보다 이 값을 낮추는 게 품질에 더 큰 도움이 되었습니다.
- 지시문 되풀이: 작은 모델은 자기 지시문("reply in one short line, in character")을 그대로 따라 합니다. 해결책은 유출 필터와 프롬프트 변경 두 가지였습니다. 대화 기록을 큰 지시문 하나에 붙여 넣는 대신 실제 채팅 턴을 쓰는 것인데, 코드 주석의 표현대로 "small models echo meta-instructions but handle the chat format they were tuned on."(작은 모델은 메타 지시문은 따라 하지만, 튜닝된 채팅 형식은 잘 다룬다) 때문입니다.
- 크리처 여섯, 노트북 하나: 동시 생성 문제는 2단계의 큐로 해결했습니다.
- 실제 하드웨어에서 한 번도 테스트되지 않았던 것은 오늘 밤까지였습니다. 잘 돌아가고, WebGPU는 빠릅니다. 약점은 WASM 폴백입니다.
숫자 정리
| 측정 항목 | 결과 |
|---|---|
| SmolLM2 360M, WebGPU 대 WASM | 초당 62.9 대 1.6토큰, 답변당 0.54초 대 26.9초 |
| Llama 3.2 1B (q4f16), WebGPU | 초당 55~64토큰, 답변당 0.4~0.5초, 답변 24개 중 24개 사용 가능 |
| Qwen 2.5 0.5B, WebGPU | 초당 37~40토큰, 답변당 약 1.8초, 24개 중 8개 버림 |
| 다운로드(모델 파일) | 273 MB / 483 MB / 1,238 MB |
| 로드, 콜드 대 캐시 | 7.5 / 13.4 / 26.8초 대 1.0 / 2.2 / 3.1초 |
| 플랫폼의 추론 비용 | $0 |
출처: 실제 운영 중인 BEINGS 사이트에 연 저희 벤치마크 탭, Chrome 155, RTX 4070, 2026년 10월 17일 오전 2:19~2:35 ET. 행과 temperature당 답변 12개. 작은 표본이라 자릿수 수준의 비교에는 좋지만 소수점 둘째 자리까지 믿을 숫자는 아닙니다.
여러분의 프로젝트에서 할 일
- Transformers.js를 모듈 Web Worker 안에서 쓰세요. 워커 하나, 모델 하나, 한 번에 생성 하나, 그리고 그 앞에 큐.
- WebGPU용
q4f16파일과 폴백용q4파일을 제공하는 ONNX 모델을 고르세요. Hugging Face의 onnx-community 조직에서 시작하면 됩니다. - 로드되는 것 중 가장 작은 모델이 아니라 약 1B 파라미터를 기본값으로 하세요. 저희 실행에서 Llama 3.2 1B는 답변당 속도가 SmolLM2 360M만큼 빨랐고 Qwen 2.5 0.5B보다 훨씬 조리 있었습니다. 작은 모델은 "느린 회선" 옵션으로 제공하세요.
- 워커 안에서 WebGPU에서 WASM으로 폴백하고, 폴백이 중요하다면 스레드를 쓸 수 있도록 페이지를 교차 출처 격리 상태로 만드세요. 그다음 임베드가 여전히 동작하는지 테스트하세요.
- 작은 모델은 temperature를 0.75 이하로 유지하고,
no_repeat_ngram_size: 3과 약한 반복 페널티를 쓰세요. - 보여 주기 전에 거르세요. 실제 실패 사례를 테스트 픽스처로 쓰는 60줄짜리 규칙 검사가 "u.u.u.u."를 게시하는 것보다 낫습니다.
- 다운로드 진행 상황을 보여 주고, 클릭하기 전에 용량을 알려 주세요.
- 빌드할 때마다 배포된 사이트에서, 실제 브라우저로 확인하세요. 저희 워커는 어떤 테스트로도 잡지 못했을 방식으로 소리 없이 깨졌습니다.
앞으로의 방향
흥미로운 변화는 작은 모델이 좋다는 게 아니라고 생각합니다. 아직은 좋지 않습니다. 변화는 "사용자의 기기가 비용을 낸다"는 점이 만들 가치가 있는 것의 기준을 바꾼다는 데 있습니다. API로는 메시지당 1센트가 들 기능이 브라우저에서는 영원히 공짜이니, 바보 같고 수다스럽고 항상 켜져 있는 것들의 카테고리 전체가 1인 개발자에게도 가능해집니다. 하드웨어도 계속 선을 옮기고 있습니다. 오늘날 탭 안의 1B 모델은 얼마 전까지만 해도 서버가 필요했던 수준입니다. 반대쪽 끝과 비교해 보세요. 그쪽에서는 "오픈" 816B 모델이 돌아가기만 하는 데도 약 1테라바이트의 RAM이 필요합니다.
앱이 호스팅 모델을 호출한다면, 가장 저렴한 토큰은 두 번 보내지 않는 토큰입니다. 같은 LLM 답변에 두 번 돈을 내지 않게 된 방법은 여기 있습니다. 그리고 브라우저 내 실행과 API 사이에서 고르기 전에 API 쪽 비용을 제대로 계산해 보세요. 저희 $7 LLM API Cost Calculator는 모델 26개에 대해 요청당, 월별, 연간 비용을 Google Sheets나 Excel에서 계산해 줍니다.
사용자의 브라우저에서 돌아가는 LLM을 출시해 보셨나요? 사용자들의 하드웨어가 여러분의 계획에 어떤 영향을 줬나요? WebGPU가 그냥 잘 돌았나요, 아니면 폴백이 여러분을 먹여 살렸나요?
2026년 10월 17일 tensorust.com에 처음 게시되었습니다. dev.to에도 실렸습니다. 관련 링크: 실제 운영 중인 앱 BEINGS, 고정 가격 AI 기능 개발, 같은 LLM 답변에 두 번 돈 내지 않기.
다음 읽을거리
- 개발 · 2026년 10월 23일 · 13분 분량순서를 지키는 UUIDv7 라이브러리 고르기: 10개 테스트, .NET은 50% 실패
- AI · 2026년 10월 21일 · 11분 분량LiteLLM에 또 백도어가 심어졌습니다. 5분 안에 키가 털렸는지 확인하세요
- AI · 2026년 10월 20일 · 11분 분량DeepSeek가 엔진을 공개했습니다. 시간당 $38짜리 부품은 집에 남겨 두고요