
DeepSeek이 엔진을 공개했다. 시간당 $38짜리 부품은 집에 남겼다
요약 전체 보기
요약: 오늘 오전 5:30 ET, DeepSeek은 자사 API를 돌리는 엔진 DeepInfer가 "이제 완전한 오픈 소스"라고 발표했습니다. 다섯 시간 만에 150만 명이 그 게시물을 봤습니다. 그런데 DeepSeek의 README에는 실제 서비스에 필요한 세 가지가 "이번 릴리스에 포함되지 않음"으로 적혀 있고, 자체 Q&A에는 그 서비스의 GPU 한 장이 시간당 $38을 번다고 나와 있습니다. 오늘 아침 저장소를 클론해 직접 측정했습니다. DeepSeek의 다이어그램에서 트래픽을 라우팅하거나 캐시를 보관하는 상자 5개 중 4개가 빠져 있고, 코드 중 vLLM과 일치하는 건 6.82%뿐이며, Huawei용 커널은 Nvidia용보다 52% 더 큽니다.
그러니까 아닙니다, @zephyr_z9. 그들은 "경제성의 비법 소스를 말 그대로 공개"하지 않았습니다. 오븐을 공개했습니다. GPU를 시간당 $38로 바꾸는 레시피는 여전히 항저우에 있습니다. 그래도 올해 AI 연구소가 개발자에게 준 선물 중 최고이고, 그래도 게시물이 말하는 그것은 아닙니다.
"완전한 오픈 소스." README는 다르게 말한다
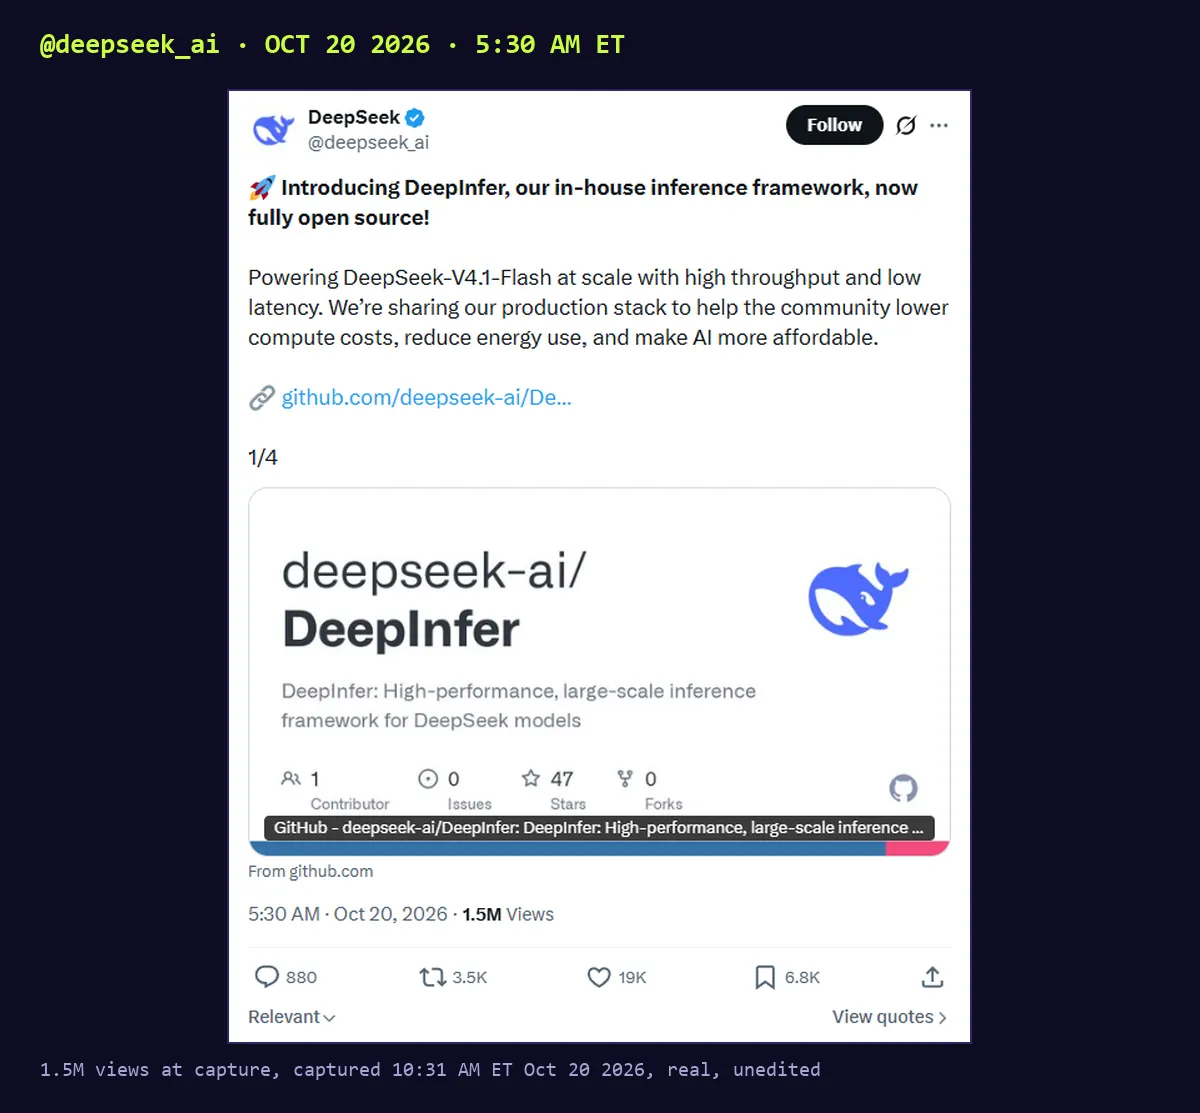
문제의 게시물은 오전 5:30 ET의 @deepseek_ai 글입니다. 오전 10:31까지 조회수 1.5M, 좋아요 19K를 기록했습니다. 저장소는 오전 10:33에 스타 8,663개를 찍었고, Hacker News 스레드는 1,222포인트, 댓글 437개로 1위였습니다.
이제 README를 열어 보세요. "Supported hardware" 아래에 이런 제목의 목록이 있습니다. 문구 그대로입니다: "Required for a complete inference service (not included in this release)"(완전한 추론 서비스에 필요함, 이번 릴리스에는 포함되지 않음):
- "A KV cache system"(KV 캐시 시스템)
- "VE/Prefill/Decode disaggregation (most required engine functionality is already implemented)"(VE/Prefill/Decode 분리, 필요한 엔진 기능 대부분은 이미 구현됨)
- "Load balancing across data-parallel replicas for both prefill and decode"(prefill과 decode 모두에 대한 데이터 병렬 레플리카 간 로드 밸런싱)
README의 첫 줄도 똑같이 솔직합니다: "This open-source release provides offline inference."(이 오픈 소스 릴리스는 오프라인 추론을 제공합니다.) 저장소에 API 서버는 없습니다. grep으로 찾아봤는데, HTTP 코드라고는 환경 변수로 켜는 프로파일링 엔드포인트 하나뿐이었습니다. 여러분의 클러스터에서 DeepInfer로 프롬프트를 돌릴 수는 있습니다. 고객을 거기에 연결할 수는 없습니다.
용어를 쉽게 풀어 보겠습니다. Prefill은 모델이 프롬프트를 읽는 단계입니다. Decode는 모델이 토큰을 하나씩 답을 써 내려가는 단계입니다. KV 캐시는 이미 읽은 프롬프트에 대한 모델의 메모로, 같은 프롬프트를 다시 읽지 않게 해 줍니다. 분리(disaggregation)는 prefill과 decode를 서로 다른 머신에서 돌린다는 뜻입니다. 로드 밸런서는 요청을 어느 머신이 받을지 정합니다. 이 하나하나가 엔진을 비즈니스로 바꾸는 부분입니다.
그들의 다이어그램을 저장소 옆에 놓아 봤다
DeepSeek은 릴리스와 함께 배포 Q&A를 공개했습니다. 여기에 V4.1 Flash 서빙 시스템 전체의 아키텍처 다이어그램이 있습니다. README의 "포함되지 않음" 목록과 코드를 읽은 결과를 바탕으로 상자마다 라벨을 붙였습니다.
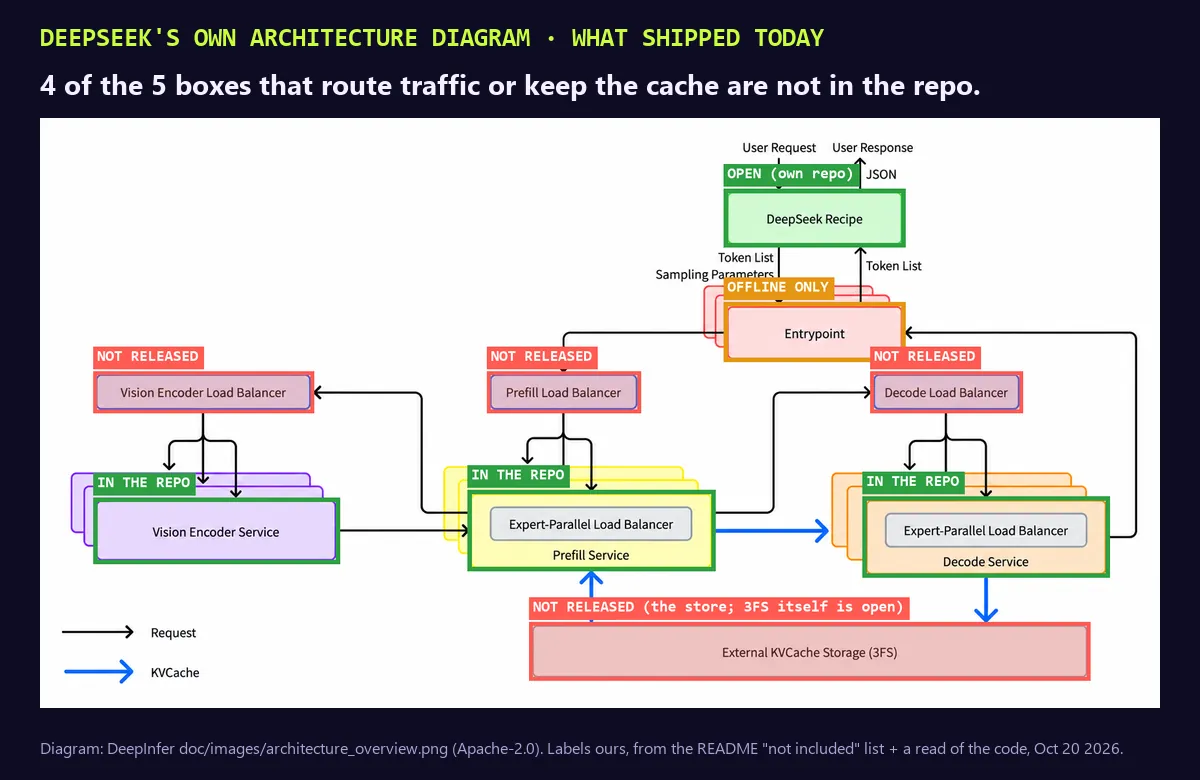
Q&A는 트래픽을 라우팅하거나 캐시를 보관하는 부품 다섯 개를 꼽습니다: Prefill Load Balancer, Decode Load Balancer, Vision Encoder Load Balancer, Expert-Parallel Load Balancer, KVCache Storage. 이 중 공개된 건 expert-parallel 하나뿐입니다(deepinfer/model_executor/eplb/에 있음). 5개 중 1개입니다. 캐시 아래에 있는 3FS 파일 시스템은 2025년 2월부터 공개되어 있습니다. 그 위에서 캐시를 돌리는 구성 요소, Q&A에서 kvcache-store라고 부르는 것은 저장소에 없습니다.
그리고 DeepSeek은 그 이유를 Q&A에서, 대부분이 스크롤로 넘겨 버린 한 문단에서 직접 밝힙니다:
"The KV cache management and load balancing components of the inference system are tightly coupled to our internal infrastructure, so that code is not yet fully open-sourced." (추론 시스템의 KV 캐시 관리와 로드 밸런싱 구성 요소는 내부 인프라와 강하게 결합되어 있어, 해당 코드는 아직 완전히 공개되지 않았습니다.)
"아직 완전히 공개되지 않았다"와 "이제 완전한 오픈 소스"는 둘 다 같은 날 아침 DeepSeek이 쓴 문장입니다. 트윗에 들어간 건 그중 하나뿐입니다.
비법 소스는 캐시이고, 그들 스스로 그렇게 말했다
"경제성을 통째로 공개했다"는 의견이 틀린 이유가 여기 있습니다. DeepSeek은 시스템의 설계 목표 세 가지를 밝혔습니다. 세 번째 목표: "Retain KV cache for more than 72 hours"(KV 캐시를 72시간 넘게 유지). 그래야 반복되는 프롬프트가 비싼 읽기 단계를 건너뜁니다. 싼 추론은 여기서 나옵니다. 같은 50페이지짜리 코드베이스를 두 번 읽는 데 돈을 내지 않는 것이죠.
Q&A가 그 빠진 부품들의 가치를 어떻게 말하는지 보세요:
- 클러스터 하나로 하루 155조 토큰.
- GPU 시간당 매출 $38, "밸리 요금 기준"(DeepSeek의 비수기 할인이므로 아마 하한선).
- 로드 밸런싱 덕분에 완벽하게 균형 잡힌 벤치마크의 약 80%까지 도달합니다. GPU가 들어 있는 상자와 GPU가 바쁘게 돌아가는 상자 사이의 그 차이가 바로 비즈니스입니다.
- 캐시 스토리지는 GPU당 14.4 TB로 잡혀 있고, 30.73 TB짜리 SSD 20개가 들어간 서버에, 노드 11개 중 아무 10개만 있으면 응답할 수 있도록 이레이저 코딩되어 있습니다.
이제 답글에서 아무도 하지 않은 비교입니다. Google Cloud는 DeepInfer의 "SM100" 타깃과 같은 Blackwell 급인 B200을 스팟 시간당 $4.95, 3년 약정 $7.09, 1년 약정 $11.12에 빌려줍니다(가격은 오늘 갱신). DeepSeek의 숫자는 GPU 임대료의 3.4x에서 7.7x입니다. 매출은 이익이 아니고, DeepSeek은 하드웨어를 빌리지 않고 소유하지만, 그 차이가 바로 경제성입니다. 그리고 그 차이는 저장소에 없는 상자 4개 안에 있습니다.
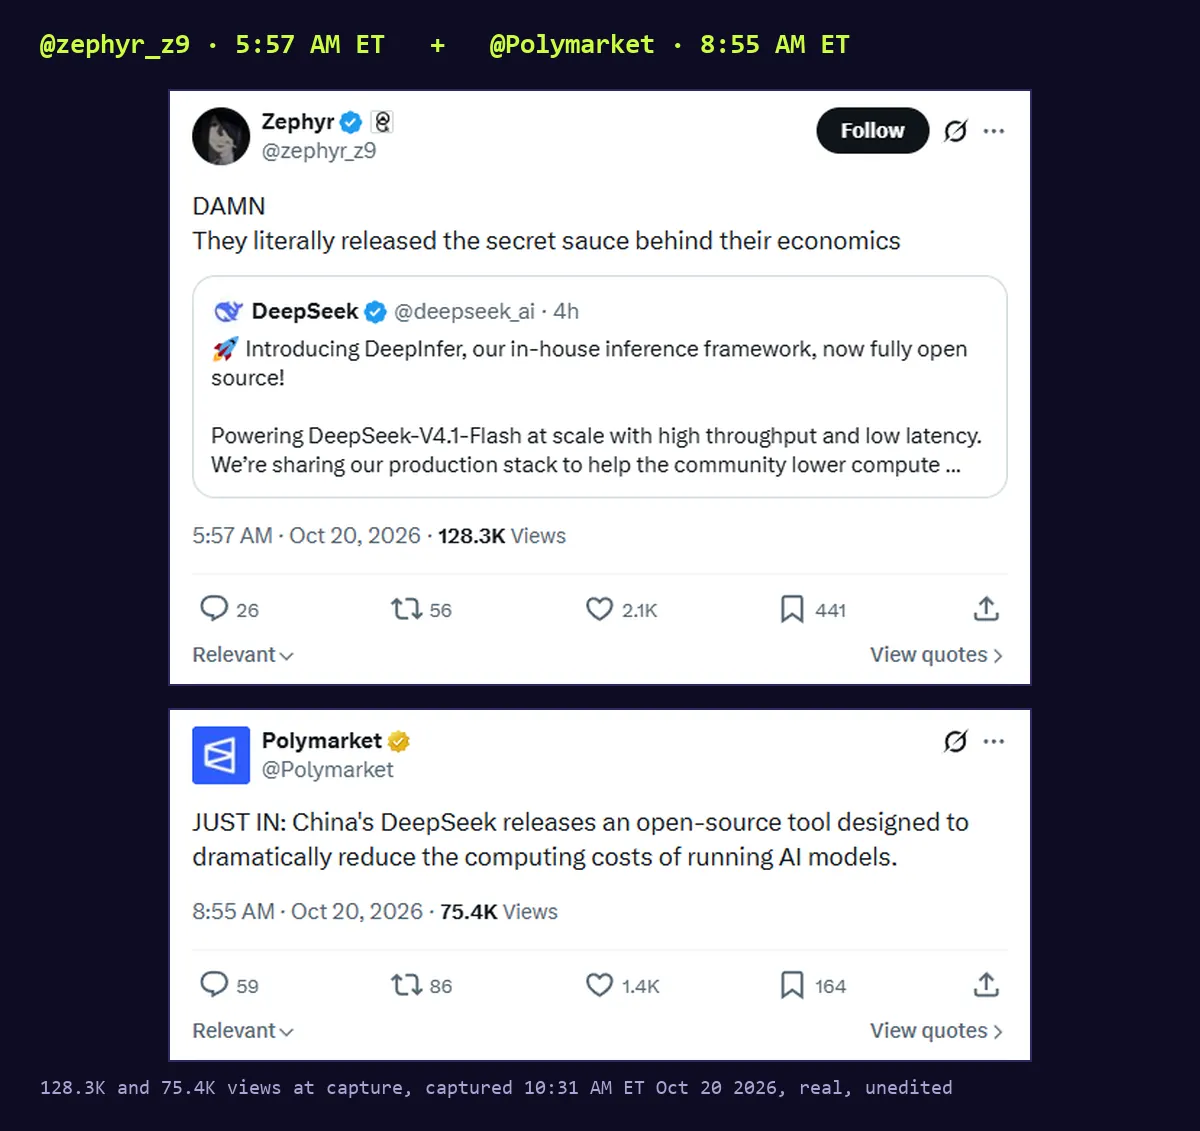
과감한 의견이고, 물러서지 않겠습니다: @Polymarket의 "AI 모델 운영 컴퓨팅 비용을 획기적으로 줄인다"는 말은 지구상에서 많아야 50개 회사에만 해당합니다. 이유는 이렇습니다.
DeepSeek처럼 돌리려면 GPU 128장부터
Q&A는 최소 규모에 대해 직설적입니다: "가장 작은 효율적 배포 단위는 prefill GPU 64장과 decode GPU 64장입니다." README 벤치마크는 "prefill에 SM100 GPU 4장, decode에 64장으로 측정"되었습니다. Decode는 EP64 이상(모델의 전문가들을 GPU 64장에서 128장에 나눠 배치)을 원합니다. 그래서 청구서를 계산해 봤습니다.
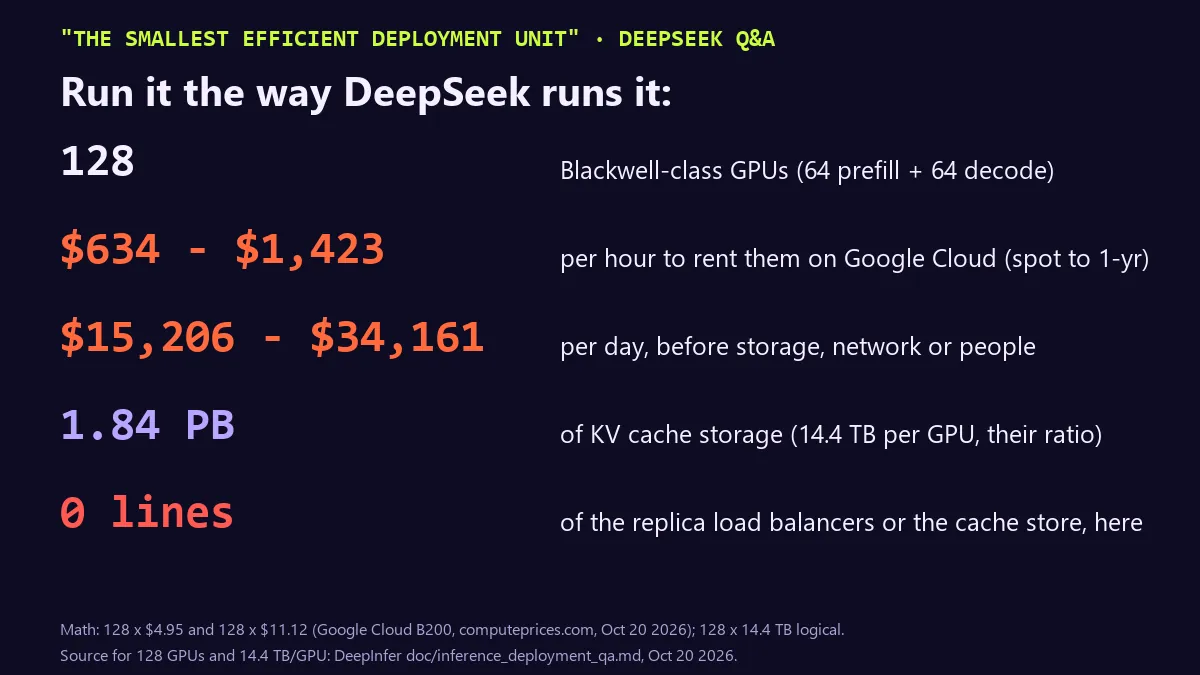
- GPU 128장 x $4.95에서 $11.12 = 시간당 $634에서 $1,423.
- 스토리지, 네트워크, 엔지니어 한 명 인건비를 빼고도 하루 $15,206에서 $34,161입니다.
- GPU당 14.4 TB 비율로 캐시 스토리지 1.84 PB.
- 여기에 이제 직접 짜야 하는 로드 밸런서와 캐시 스토어.
이번 주 타임라인에 올라온 다른 DeepSeek 소식과 비교해 보세요: Unsloth의 1-bit V4.1 Flash는 508GB를 250GB로 줄여서 RAM 128GB 이상인 머신에서 돌아갑니다. 대부분의 사람이 실제로 만져 볼 오픈 모델은 그쪽입니다. DeepInfer는 클라우드용입니다. 인디 개발자라면 DeepSeek이 주는 진짜 선물은 여전히 이 저장소가 아니라 저렴한 API입니다.
Q&A에는 이번 릴리스 전체에서 최고의 문장도 있습니다. prefill과 decode를 여러 데이터 센터에 나눠 돌릴 수 있냐고요? 가능합니다, "신뢰성을 일부 희생하면요. 예를 들어 데이터 센터 사이를 잇는 광섬유는 공사 한 번에 쉽게 끊깁니다." 존경합니다. 굴착기 때문에 한 주를 날려 본 팀의 말입니다.
vLLM은 "주로 vLLM 위에 만들었다"고 한다. 측정해 보니 6.82%
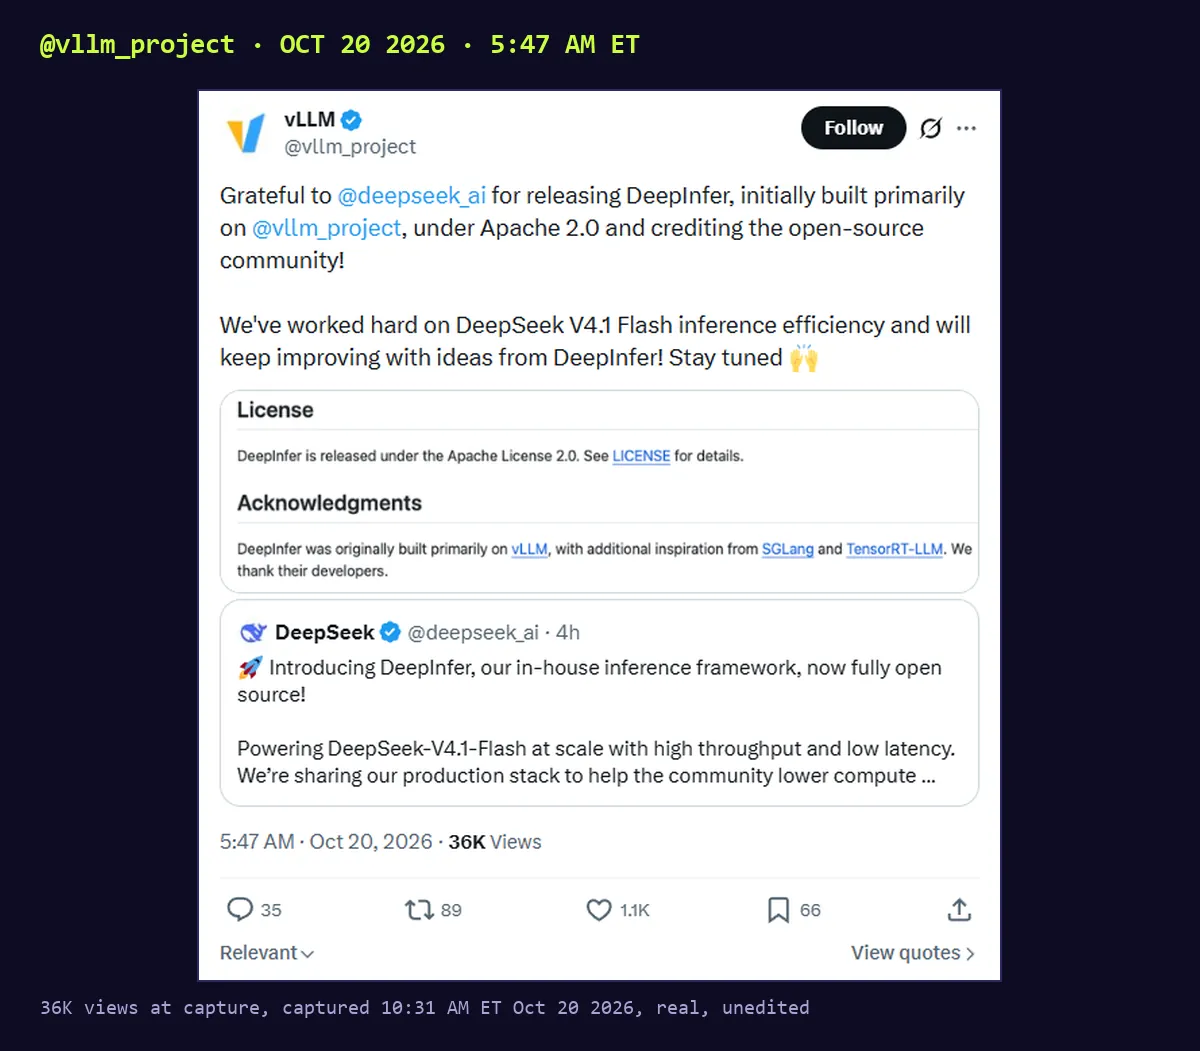
또 하나의 큰 반응은 업계 대부분이 쓰는 오픈 소스 엔진 vLLM 팀에서 나왔습니다. 그들의 게시물은 품위 있고, DeepSeek의 README에도 DeepInfer가 "원래 주로 vLLM을 기반으로 만들어졌다"고 적혀 있습니다.
그래서 vLLM이 얼마나 남아 있는지 측정했습니다. DeepInfer(커밋 774ce24)와 v0.2.0(2023년)부터 오늘의 main 브랜치까지 vLLM 릴리스 9개를 클론했습니다. DeepInfer의 deepinfer/ 패키지에서 25자 이상인 Python 줄을 모두 뽑아, 주석과 빈 줄을 버리고 공백을 하나로 합친 뒤, 각 줄이 vLLM 릴리스 어딘가에 정확히 일치하는지 확인했습니다. 스크립트는 Python 60줄이고, 약 1분 걸렸으며, GPU는 필요 없었습니다.
def norm(l):
    l = l.strip()
    if not l or l.startswith('#'): return None
    if len(l) < 25: return None   # skip trivial lines
    return re.sub(r'\s+', ' ', l)

# every .py file in each vLLM tag, read straight out of git
p = subprocess.run(['git', '-C', VL, 'cat-file', '--batch'],
                   input='\n'.join(f'{ref}:{f}' for f in files).encode(),
                   capture_output=True)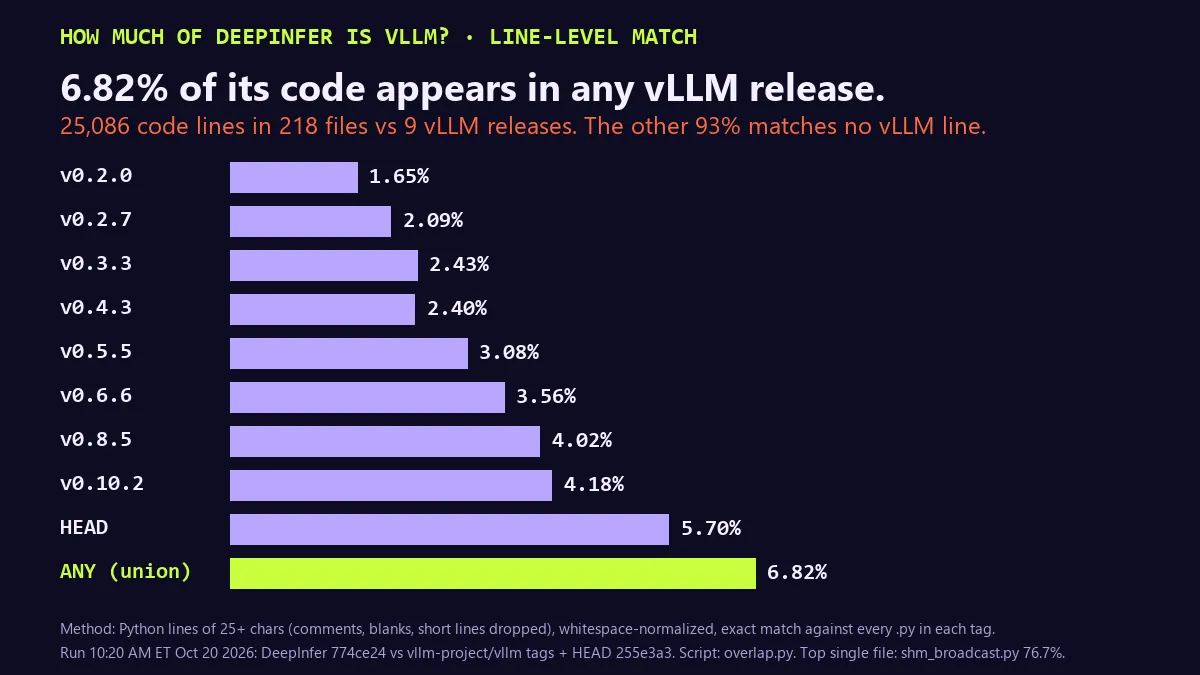
결과: 25,086줄 중 1,711줄(6.82%)이 적어도 하나의 vLLM 릴리스에 나옵니다. 단일 릴리스로 가장 높은 건 오늘의 vLLM main으로 5.70%인데, 대부분 두 프로젝트가 같은 새 아이디어를 받아들였다는 뜻입니다. 가장 vLLM다운 파일은 공유 메모리 메시지 큐인 shm_broadcast.py로 76.7%입니다. 엔진 코어 llm_engine.py는 19.2%입니다. V4 모델 코드는 5에서 12% 정도입니다.
폴더 구조는 아직 vLLM 그대로입니다: worker/cache_engine.py, sequence.py, model_runner.py. 2023년 vLLM이 쓰던 이름들입니다. 하지만 그 안의 코드는 다시 쓰였습니다. 이 방법은 이름이 바뀐 변수와 리팩터링을 놓치므로, 6.82%는 표절 점수가 아니라 가족 유사성의 하한선으로 보셔야 합니다. 제 해석: "vLLM 위에 만들었다"는 말은 고층 빌딩이 원래 그 자리에 있던 주차장 위에 지어졌다는 말과 같습니다. 사실이고, 너그러운 말이며, 나머지 93%를 쓴 DeepSeek은 제대로 인정받아야 합니다.
Nvidia보다 Huawei용 코드가 52% 더 많다
제가 보기에 이번 릴리스의 진짜 의미는 여기 있습니다. DeepInfer의 커스텀 커널(연산을 수행하는 작은 GPU 프로그램)은 tilelang_ops/에 있고, 칩마다 백엔드가 하나씩 있습니다. 같은 커널 30개, 각각 두 버전. 빈 줄을 뺀 줄 수를 셌습니다.
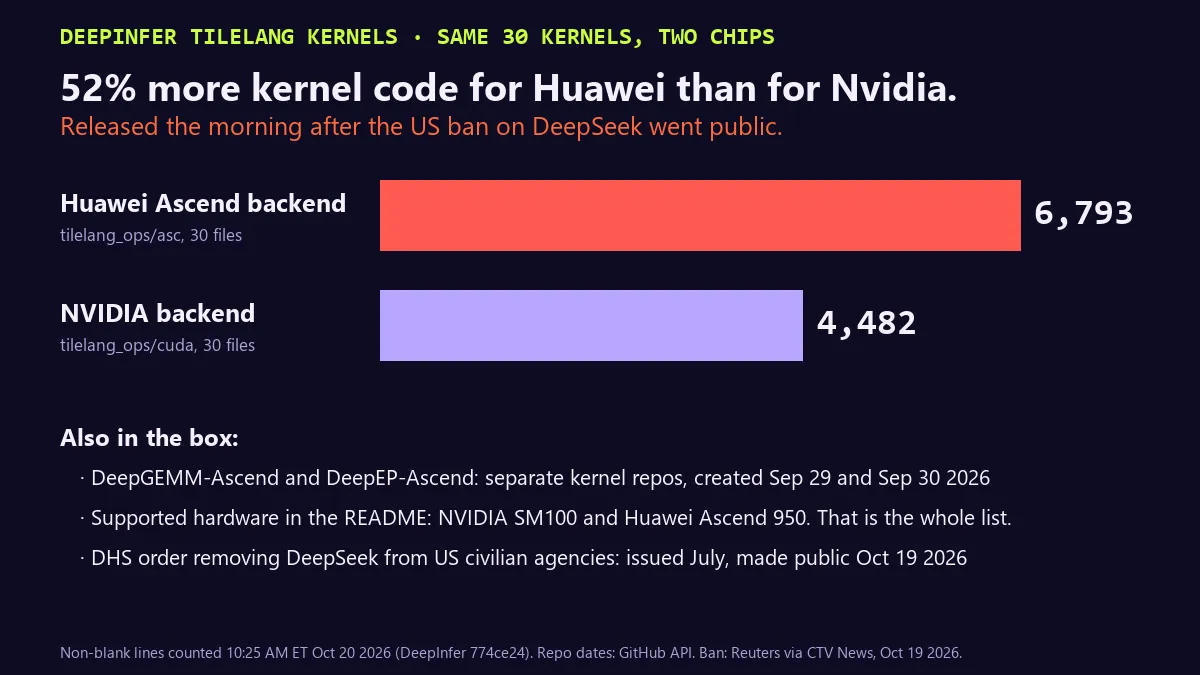
- Huawei Ascend 백엔드: 6,793줄. NVIDIA 백엔드: 4,482줄. +51.6%입니다.
- README의 지원 하드웨어: "NVIDIA SM100 GPUs"와 "Huawei Ascend 950 NPUs". 목록은 그게 전부입니다. H100도 없고, AMD도 없습니다.
- Ascend 커널 라이브러리는 별도 저장소 DeepGEMM-Ascend와 DeepEP-Ascend로 나와 있고, 둘 다 오늘로부터 3주 전인 2026년 9월 29일과 30일에 생성됐습니다.
- 릴리스 하루 전, Reuters는 미국 국토안보부(DHS)가 연방 민간 기관에 DeepSeek 제품과 그 모델로 만든 서드파티 서비스를 제거하라고 명령했다고 보도했습니다(7월에 발령, 10월 19일 공개).
- 같은 날 The Information은 DeepSeek과 Huawei가 Nvidia에 도전할 새 AI 칩 설계를 위해 손잡는다고 보도했습니다(@unusual_whales 경유, 조회수 149K).
그 +52% 중 일부는 그냥 더 젊은 칩의 비용입니다. Ascend 커널은 CUDA 커널보다 손이 더 많이 갑니다. 하지만 팔 계획도 없는 칩을 위해 6,793줄을 쓰는 사람은 없습니다. 제가 보기에 실제로 벌어지는 일은 이렇고, 그들은 절대 입 밖에 내지 않을 겁니다: 이건 Apache 라이선스를 단 Huawei 영업 자료입니다. DeepSeek의 가격으로 DeepSeek을 서빙하고 싶은 중국의 모든 클라우드가 이제 미국이 끊을 수 없는 칩에서 돌아가는 프로덕션급 엔진을 갖게 됐습니다. 월요일에 미국이 정부 기관에서 DeepSeek을 금지합니다. 화요일에 DeepSeek은 Huawei 실리콘 위에서 다른 모두가 자기 모델을 더 싸게 서빙할 수 있게 만듭니다. 솔직히 올해 가장 타이밍 좋은 오픈 소스 공개입니다.
"데모가 아니라 중국의 프로덕션 시스템"이라는 쪽에 증거 하나 더: 패키지의 빈 줄 제외 40,638줄 중 1,147줄에 중국어 주석이나 docstring이 있습니다. 예를 들어 """compress 内核固定开启 fast math。"""("compress 커널은 항상 fast math를 켠다")처럼요. 출시 블로그용으로 쓴 코드가 아닙니다. 전체 이력은 커밋 3개입니다. 오전 12:09 ET에 파일 345개, 63,326줄짜리 "initial commit" 하나, 그다음 문서 업데이트 두 개. 오늘 아침 어딘가 비공개 저장소에서 내보낸 것입니다.
그래도 OpenAI보다는 더 열려 있다. 진짜 뼈 때리는 건 그거다
DeepSeek에게 공정하게, 다른 모두에게는 불공정하게 말하자면: OpenAI의 공개 릴리스는 2025년 8월의 gpt-oss로, Apache 2.0 가중치와 레퍼런스 코드였습니다. OpenAI, Anthropic, Google은 유료 사용자에게 ChatGPT, Claude, Gemini를 실제로 서빙하는 시스템의 코드를 한 줄도 공개하지 않았습니다. DeepSeek은 방금 엔진, 커널, 전문가 밸런서, 대부분 Rust로 작성된 토크나이저 서비스(deepseek-recipe), 스토리지 구성, GPU 시간당 매출, 트래픽까지 공개했습니다.
그러니 악당을 고르세요. 프로덕션 엔진의 93%를 내놓고 100%라고 부르는 연구소인가요, 아니면 0%를 내놓고 스스로를 착한 쪽이라고 부르는 연구소들인가요?
오늘의 의견 순위
- 가장 틀린 의견: @zephyr_z9, "They literally released the secret sauce behind their economics"(경제성의 비법 소스를 말 그대로 공개했다, 조회수 128K). 소스는 72시간 캐시와 로드 밸런서 네 개입니다. 둘 다 공개되지 않았습니다.
- 대부분의 독자에게 가장 틀린 의견: @Polymarket, "AI 모델 운영 컴퓨팅 비용을 획기적으로 줄인다"(75K). Blackwell 128장과 페타바이트급 SSD를 가진 곳이라면, 물론이죠.
- 가장 너그러운 의견: @vllm_project, "처음에는 주로 vLLM 위에 만들어졌다". 오늘 기준 6.82%. 기초를 놓은 공은 가져가세요. 건물은 DeepSeek의 것입니다.
- 가장 정확한 의견: DeepSeek의 README. 그 팀의 누군가가 "not included in this release"(이번 릴리스에 포함되지 않음)라고 평범한 말로 적었습니다. 마케팅 게시물은 그걸 읽지 않았습니다.
지금까지의 숫자
- DeepSeek 라우팅/캐시 계층 중 공개된 상자: 5개 중 1개(EPLB), 10월 20일 오전 10:25 ET 확인
- vLLM 릴리스 9개 중 어느 하나에서라도 발견된 DeepInfer 줄: 25,086줄 중 1,711줄(6.82%)
- 커널 줄 수, Huawei Ascend 대 NVIDIA: 6,793 대 4,482(+51.6%)
- DeepSeek의 GPU 시간당 매출: $38(그들의 Q&A) 대 Google Cloud B200 임대료 $4.95에서 $11.12
- 가장 작은 효율적 배포: GPU 128장, 시간당 $634에서 $1,423
- 스타: 오전 10:33 ET 기준 8,663개, 첫 커밋 후 약 10시간
제 예측, 그리고 여러분 차례
예측: 11월 30일까지 vLLM과 SGLang이 DeepInfer의 기법 대부분(드래프트 토큰 디코딩, 범위가 제한된 SWA 리플레이)을 출시하고, 미국 클라우드들은 지금보다 V4.1 Flash를 더 빠르게 서빙할 겁니다. 그리고 12월 31일까지 중국 밖에서 72시간 캐시와 밸런서 네 개를 갖추고 DeepSeek처럼 돌리는 곳은 없을 겁니다. DeepSeek이 그 부분을 남겨 뒀으니까요. 제가 틀렸다면 클러스터를 보여 주세요. 여러분의 이름을 제목에 넣어 정정 글을 쓰겠습니다.
여러분 차례입니다: API 요청 하나도 서빙할 수 없는 릴리스에 "완전한 오픈 소스"라는 말이 공정할까요? 예 또는 아니오, 그리고 이유를 답글로 남겨 주세요. @deepseek_ai도 답해 주시면 환영입니다.
V4.1 Flash를 API로 쓸 때와 GPU를 직접 빌릴 때 비용이 얼마나 다른지 보고 싶으신가요? LLM API Cost Calculator($7, Google Sheets + Excel, 모델 26개)가 요청당 계산을 시트 하나로 해 줍니다. 무료 버전은 사이트의 tensorust.com/tools/llm-api-cost/에 있습니다.
tensorust.com의 관련 글(영어): Meta가 816B 모델을 공개했다. 돌리려면 RAM 약 1TB가 필요하다, LLM 프록시 벤치마크: 중복 호출 200개가 1개가 됐다, Theo의 60% 통계는 장애 차트다.
방법과 데이터: DeepInfer는 774ce24에서 클론(2026년 10월 20일), vllm-project/vllm 태그 v0.2.0, v0.2.7, v0.3.3, v0.4.3, v0.5.5, v0.6.6, v0.8.5, v0.10.2와 main 255e3a3. 모든 집계는 2026년 10월 20일 오전 10:20부터 10:35 ET 사이에 실행. X 스크린샷은 오전 10:31 ET 캡처, 실제 화면이며 편집하지 않음. GPU 가격은 computeprices.com의 Google Cloud B200 페이지, 2026년 10월 20일 갱신.
2026년 10월 20일 tensorust.com에 처음 게시되었습니다. X(@TensorustAI), X(@MattBusel), dev.to에도 실렸습니다. 관련 링크: 무료 LLM API 비용 계산기, Meta 816B에는 RAM 1TB가 필요하다, LLM 프록시 벤치마크.
더 보기: 글쓴이, 관련 글, 공유하기, 무료 게임
다음 읽을거리
무료 도구: LLM API 비용 계산기 → 입력 토큰, 출력 토큰, 하루 요청 수를 넣으면 GPT, Claude, Gemini 모델 24개의 월 비용을 보여 줍니다.
- AI · 2026년 10월 21일 · 11분 분량LiteLLM에 또 백도어. 내 키가 털렸는지 5분 만에 확인하기
- AI · 2026년 10월 19일 · 13분 분량Theo의 60% 통계는 장애 차트다: Codex 장애 43시간
- AI · 2026년 10월 18일 · 13분 분량지터를 넣은 지수 백오프: LLM 호출 100개 중 64개가 그래도 실패했다