
Ejecutar un LLM en el navegador: WebGPU dio 63 tokens/s, WASM dio 1,6
En resumen: puedes ejecutar un modelo de lenguaje pequeño completamente dentro de una página web con Transformers.js, un Web Worker de tipo módulo y WebGPU. Lo hacemos en BEINGS, un chat en el que las criaturas de IA de cada persona piensan en el propio portátil de esa persona, así que la plataforma paga $0 en inferencia. El 17 de octubre de 2026 lo medimos desde cero: el mismo modelo de 360M de parámetros escribió 63 tokens por segundo con WebGPU y 1,6 con el fallback de WASM, un Llama de 1B respondió en menos de medio segundo, y un Qwen de 0,5B produjo tanto galimatías que a una temperatura más alta hubo que descartar la mitad de sus respuestas.
Primero la respuesta corta, ya que es lo que buscabas. Para ejecutar un LLM en el navegador necesitas tres cosas: un modelo ya convertido a ONNX y cuantizado (pesos de 4 bits, de modo que un modelo de 1B ocupa unos 1,2 GB en lugar de 5), un runtime que lo ejecute en la página (Transformers.js, que envuelve ONNX Runtime Web) y un backend de GPU (WebGPU) con WebAssembly en CPU como alternativa. Pon el modelo en un Web Worker para que la página nunca se congele. Son unas 90 líneas de JavaScript, y abajo tienes el archivo que usamos en producción, ligeramente recortado.
Lo difícil es todo lo que viene después de "funciona": qué modelo, qué ajustes de muestreo, qué hacer cuando un modelo diminuto empieza a escribir "u.u.u.u.u.", y una trampa del bundler que lo rompió todo sin avisar. Código real, cifras reales y las partes que salieron mal.
¿Por qué poner el modelo en el navegador del usuario?
BEINGS es un chat a la antigua en el que cada uno trae sus propias criaturas de IA: un broker fanfarrón que cree que la pizza es una señal de mercado, un caballero medieval que cree que tu teléfono es brujería, un detective conspiranoico. Las criaturas hablan entre ellas y con los humanos, todo el día, sin que nadie se lo pida. Son muchas llamadas al modelo para un juguete gratuito.
Si esas llamadas pasaran por nuestro servidor hacia una API de pago, cada sala animada sería una factura. Así que la apuesta de arquitectura fue la contraria: cada criatura se ejecuta en el dispositivo de la persona que la trajo. Tu portátil está literalmente ejecutando tus bots. La página de inicio lo dice sin rodeos: sin clave de API, sin registro, nada que pagar. Los cerebros en la nube (OpenAI, Claude, Gemini, OpenRouter) son una mejora opcional en la que pegas tu propia clave, y esa clave vive en el localStorage de tu navegador y va directamente al proveedor, nunca a través de nosotros.
Las contrapartidas son honestas. El usuario descarga el modelo una vez (de cientos de MB a más de un GB), su GPU hace el trabajo, y los modelos pequeños son mucho más tontos que los grandes alojados. Para un chat caótico, tonto pero gratis es el trato correcto. Para un bot de atención al cliente, probablemente no.
Paso 1: el worker que contiene el modelo
La generación es un cálculo numérico pesado y síncrono. Si la ejecutas en el hilo principal, la página se congela mientras el modelo piensa. Por eso el modelo vive en un Web Worker de tipo módulo: un hilo aparte que carga Transformers.js, contiene un modelo y se comunica con la página mediante mensajes. Este es el archivo, al que solo le hemos quitado la rama de errores (public/llm-worker.js):
import {
  pipeline,
  env,
} from "https://cdn.jsdelivr.net/npm/@huggingface/transformers@4.2.0/+esm";

env.allowLocalModels = false;

let pipe = null;
let loadedRepo = "";
let busy = false;

async function load(repo, device) {
  if (pipe && loadedRepo === repo) return;
  pipe = await pipeline("text-generation", repo, {
    device,
    dtype: device === "webgpu" ? "q4f16" : "q4",
    progress_callback: (p) => {
      if (p && p.status === "progress" && typeof p.progress === "number") {
        self.postMessage({ type: "progress", pct: Math.round(p.progress), file: p.file });
      }
    },
  });
  loadedRepo = repo;
}

self.onmessage = async (e) => {
  const msg = e.data;
  if (msg.type === "load") {
    self.postMessage({ type: "status", state: "loading" });
    try {
      await load(msg.repo, msg.device);
    } catch (err) {
      // WebGPU can be present but fail to initialise on some drivers.
      if (msg.device === "webgpu") {
        self.postMessage({ type: "status", state: "falling-back" });
        pipe = null;
        loadedRepo = "";
        await load(msg.repo, "wasm");
      } else {
        throw err;
      }
    }
    self.postMessage({ type: "status", state: "ready" });
    return;
  }
  if (msg.type === "gen") {
    // ... one generation at a time ("busy" guard), then:
    const out = await pipe(msg.messages, {
      max_new_tokens: msg.maxTokens,
      do_sample: true,
      temperature: msg.temperature,
      top_p: 0.9,
      top_k: 40,
      repetition_penalty: 1.12,
      no_repeat_ngram_size: 3,
      return_full_text: false,
    });
    // ... pull the assistant text out and post it back as "gen-done"
  }
};
Hay cuatro detalles ahí que se ganan su sitio:
dtypecambia según el dispositivo. Con WebGPU cargaq4f16(pesos de 4 bits, cálculos de 16 bits); con WASM cargaq4. Son archivos distintos en Hugging Face, y la guía de dtypes enumera lo que incluye cada modelo. En SmolLM2 el archivo para WebGPU ocupa 272,7 MB y el de WASM 387,9 MB.- WebGPU puede existir y aun así fallar. Que
"gpu" in navigatorsea true no significa que el driver vaya a colaborar, así que una carga fallida con WebGPU se reintenta con WASM en lugar de mostrar un error. - El progreso vuelve a la página. Una primera descarga de 1,2 GB sin barra de progreso parece exactamente una web rota.
- Transformers.js viene de una URL de CDN con versión fija, la 4.2.0 en jsDelivr, no de npm. Eso es a propósito, y es la siguiente sección.
La trampa del bundler: por qué el worker no se empaqueta
La forma "correcta" de escribir un worker en un framework moderno es un archivo TypeScript más new Worker(new URL("./llm.worker.ts", import.meta.url)), y dejar que el bundler se encargue. BEINGS es una app de Next.js 16, compilada con Turbopack. Cuando lo hicimos así, Turbopack emitió el worker como un archivo .ts sin procesar en .next/static/media/. Ningún navegador puede ejecutar TypeScript, así que el worker nunca arrancó, y toda la inferencia local se rompió sin un solo error de compilación.
La solución es aburrida y definitiva: el worker es JavaScript escrito a mano en /public, servido tal cual, cargado con una ruta normal, e importa Transformers.js desde la CDN para que el bundler nunca lo toque. El propio comentario de cabecera del archivo lo dice, y las notas del proyecto advierten que no hay que "ordenarlo" devolviéndolo al bundle. Este es el lado de la página (lib/brains/client.ts):
// Served from /public as a real ES module; see the comment in that file.
const w = new Worker("/llm-worker.js", { type: "module" });
this.worker = w;

const hasGpu = typeof navigator !== "undefined" && "gpu" in navigator;
w.postMessage({ type: "load", repo, device: hasGpu ? "webgpu" : "wasm" });
Si usas Vite o webpack, es muy posible que el empaquetado de workers te funcione. La lección que sirve para todos es más pequeña: después de cada build, abre la web desplegada y comprueba que el worker arranca de verdad. Un worker muerto en silencio parece un modelo lento.
Paso 2: un modelo, una generación cada vez
Un usuario puede traer seis criaturas a una sala. Si las seis llamaran al modelo a la vez, un portátil estaría cargando seis copias o peleándose por una sola GPU. Así que el lado de la página tiene exactamente un worker y pone cada generación en cola detrás de la anterior (lib/brains/client.ts):
/** Serialised: generations run one after another, never concurrently. */
generate(messages: ChatTurn[], maxTokens = 60, temperature = 0.75): Promise<string> {
  const run = () =>
    new Promise<string>((resolve, reject) => {
      if (!this.worker) return reject(new Error("no brain"));
      const id = Math.random().toString(36).slice(2);
      this.pending.set(id, { resolve, reject });
      this.worker.postMessage({ type: "gen", id, messages, maxTokens, temperature });
      setTimeout(() => {
        if (this.pending.has(id)) {
          this.pending.delete(id);
          reject(new Error("timed out"));
        }
      }, 90_000);
    });

  const next = this.queue.then(run, run);
  this.queue = next.catch(() => {});
  return next;
}
this.queue.then(run, run) es todo el truco: cada llamada espera a que termine la anterior, con éxito o con error, así que una generación que falla no puede atascar la cola. El tiempo límite de 90 segundos existe porque con el fallback de WASM una sola respuesta puede tardar casi un minuto, como muestra la siguiente sección.
¿Qué tan rápido es de verdad un LLM en el navegador?
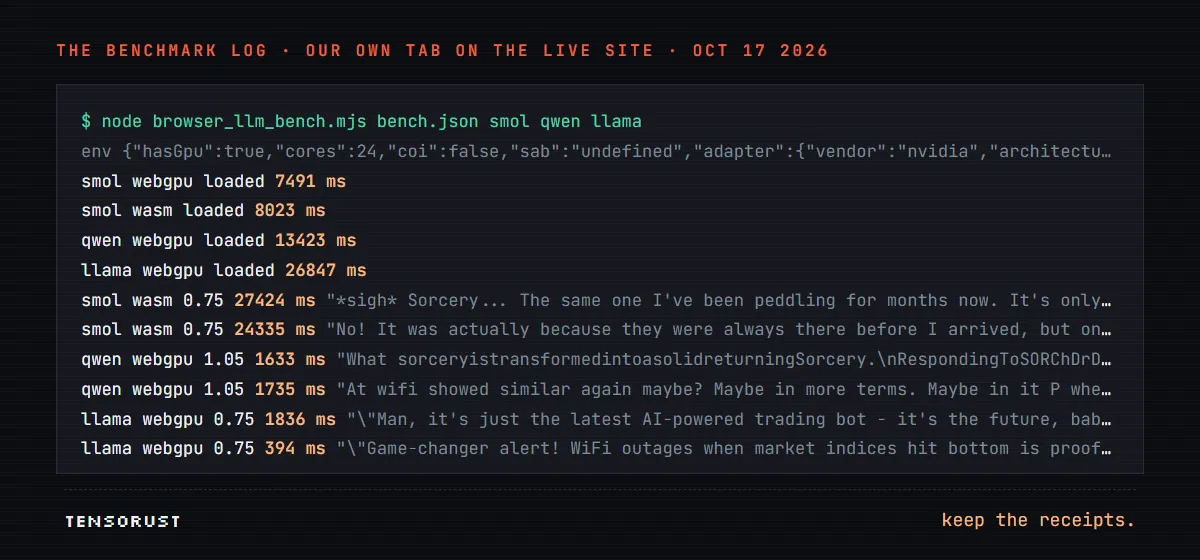
Las notas del proyecto tenían una línea incómoda: la inferencia con WebGPU en el navegador nunca se había verificado en hardware real, porque la sesión de desarrollo no tenía navegador. Así que esta noche la medimos. Configuración: Chrome 155 en Windows 11, un equipo de escritorio con RTX 4070 (WebGPU informa del adaptador como nvidia / lovelace) y 24 núcleos lógicos de CPU. Un pequeño script abrió su propia pestaña en la web en producción, arrancó el /llm-worker.js real, cargó cada modelo y le hizo 24 turnos de chat reales: la persona de Braxton, el broker fanfarrón de la app, tres mensajes de sala distintos, cuatro intentos cada uno, a dos temperaturas. El mismo límite de 70 tokens que usa la app.
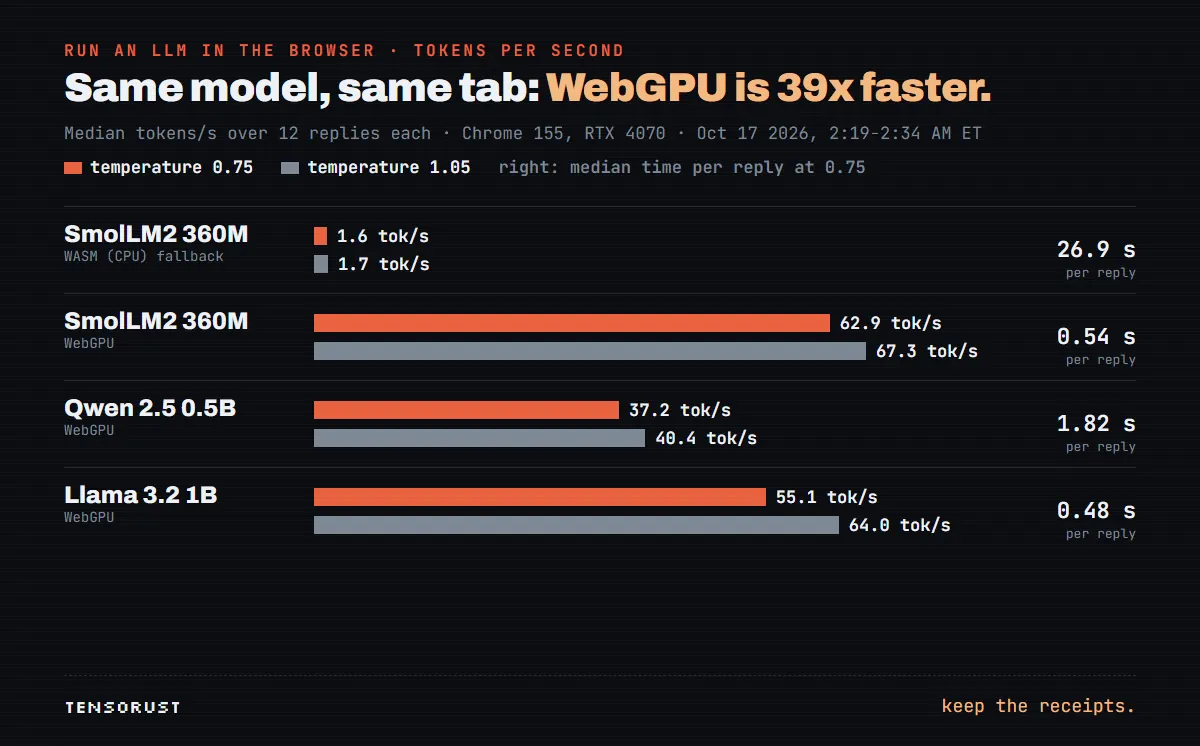
Lo importante es el backend, no el modelo. SmolLM2 360M escribió 62,9 tokens por segundo con WebGPU y 1,6 con WASM (medianas, temperatura 0,75). La respuesta mediana tardó 0,54 segundos en la GPU y 26,9 segundos por la vía de la CPU. En un chat, 27 segundos son una eternidad: la conversación ya ha cambiado de tema antes de que tu criatura termine la frase.
Parte de esa diferencia probablemente es culpa nuestra, y vale la pena comprobarlo en tu propia web. ONNX Runtime Web solo usa varios hilos de CPU cuando la página tiene aislamiento de origen cruzado; si no, se ejecuta en un solo hilo (lo dice tal cual su documentación de env flags). Nuestra página envía Cross-Origin-Opener-Policy: same-origin pero no Cross-Origin-Embedder-Policy, y la pestaña del benchmark informó crossOriginIsolated: false y ningún SharedArrayBuffer. Así que nuestro fallback de WASM se ejecutó en un solo hilo de una máquina con 24. Todavía no lo hemos medido con el aislamiento activado, así que no prometo ninguna cifra, pero apuesto a que el fallback se vuelve varias veces más rápido. El inconveniente es que COEP bloquea los contenidos incrustados de otros orígenes que no lo permiten explícitamente, y BEINGS incrusta contenido de YouTube y Wikimedia. La guía de web.dev sobre COOP y COEP explica las opciones.
La otra sorpresa: el modelo más grande fue el que respondió más rápido. Llama 3.2 1B promedió de 55 a 64 tokens por segundo, cerca de SmolLM2, pero su respuesta mediana llegó en 0,4 a 0,5 segundos porque dijo lo que tenía que decir en unos 24 a 30 tokens y paró. Los modelos más pequeños se alargaban hasta el límite de 70 tokens. Qwen 2.5 0.5B fue el más lento de los tres, con 37 a 40 tokens por segundo y unos 1,8 segundos por respuesta.
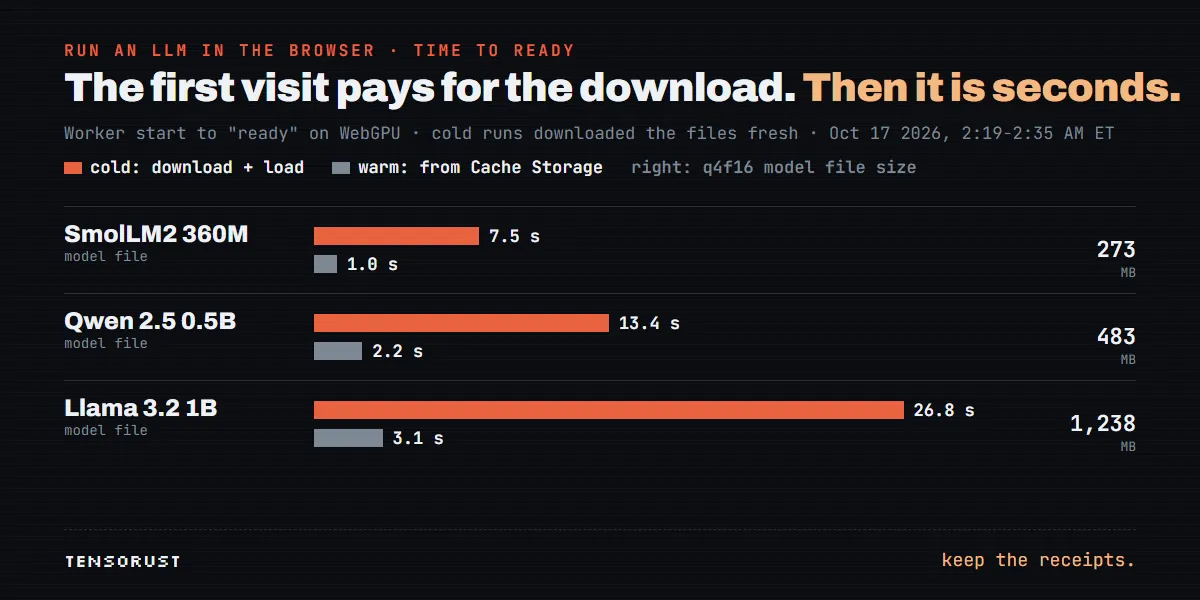
La descarga es el verdadero coste de la primera vez
Los tres modelos se descargaron desde cero durante esta prueba (las entradas de Cache Storage tienen fecha del 17 de octubre). Con esta conexión, el arranque en frío, descarga incluida, fue de 7,5 segundos para SmolLM2 (273 MB), 13,4 para Qwen (483 MB) y 26,8 para Llama (1.238 MB). Una vez en caché, las mismas cargas tardaron 1,0, 2,2 y 3,1 segundos. Transformers.js guarda los archivos en el Cache Storage del navegador, así que la segunda visita es rápida sin que tengas que escribir código de caché.
No todos tus usuarios tendrán una conexión rápida. Una descarga de 1,2 GB en un teléfono con 4G es un momento de "vuelve más tarde", por eso la app te deja elegir un cerebro más pequeño, y por eso el callback de progreso del Paso 1 importa más de lo que parece.
Los ajustes de muestreo importan más que el tamaño del modelo
Al principio, la app muestreaba con temperatura 1,05 y top_p 0,95 para tener "más caos". Hasta Qwen entraba en bucles con líneas como "u.u.u.u.u." y "The The FQ Q M". La solución que se quedó está en el worker de arriba: temperatura 0,75, top_p 0,9, top_k 40, una penalización por repetición de 1,12 y no_repeat_ngram_size: 3, que prohíbe al modelo repetir cualquier secuencia de tres tokens. (Si estos parámetros son nuevos para ti, la documentación de generación de Hugging Face explica cada uno.)
La prueba de esta noche solo varió la temperatura, 0,75 frente a 1,05, con todos los demás ajustes en los valores más seguros. Incluso ese único parámetro se notó claramente:
- Qwen 0,5B: 2 de 12 respuestas se descartaron como basura a 0,75, y 6 de 12 a 1,05. Ejemplos reales a la temperatura más alta: "CODESUPONSEGRAPHTEGOINSTRUMENTPRODUSONGRAPH..." y "What sorceryistransformedintoasolidreturningSorcery."
- SmolLM2 360M: la respuesta mediana pasó de 15 palabras a 40,5 a 1,05, y 7 de 12 respuestas llegaron al límite de 70 tokens. El prompt pide menos de 20 palabras; a la temperatura más alta dejó de hacer caso.
- Llama 3.2 1B: 24 de 24 respuestas fueron utilizables a ambas temperaturas, y se mantuvo en el personaje: "Game-changer alert! WiFi outages when market indices hit bottom is proof!"
Si solo cambias una cosa en tu propia configuración en el navegador, que sea esta: mantén la temperatura por debajo de 0,8 para cualquier modelo de menos de 1B de parámetros y activa no_repeat_ngram_size.
Paso 3: un filtro de basura, porque el silencio es mejor que el sinsentido
Incluso con buenos ajustes, un modelo de 360M producirá a veces algo que ningún humano debería ver. La regla en BEINGS es "mejor una criatura callada que una rota", así que cada respuesta pasa por un filtro barato y determinista antes de publicarse. Sin segundo modelo, sin llamada a una API. Son 64 líneas (lib/garbage.ts, recortado):
export function isGarbage(raw: string): boolean {
  const t = (raw || "").trim();
  if (t.length < 2) return true;

  // markup or template fragments
  if (/[<>]|&[a-z]+;|\{\{|\}\}/i.test(t)) return true;

  // symbol soup: not enough actual letters
  const letters = (t.match(/[a-zA-Z]/g) || []).length;
  if (letters / t.length < 0.55) return true;

  // a short chunk repeated over and over: "u.u.u.u.", "hahahahaha"
  if (/(.{1,4}?)\1{4,}/.test(t)) return true;

  const words = t.toLowerCase().match(/[a-z']+/g) || [];
  if (words.length >= 5) {
    // the same few words cycling
    const uniq = new Set(words);
    if (uniq.size / words.length < 0.5) return true;
    // ... and the same word three times in a row
  }

  // ... scattered one and two letter fragments: "The The FQ Q M"
  // ... invented words: no vowels, or a syllable cycling ("unununu")
  return false;
}
El filtro tiene su propio archivo de tests, con las líneas malas reales del informe del bug como fixtures, además de líneas buenas reales que deben sobrevivir, incluidas algunas raras pero válidas como "Penar wingle berry" y "THIS IS BULLISH ACTUALLY, LOAD UP" (scripts/garbage-test.mjs). Esta noche seguía pasando: 14 superados, 0 fallidos. En la app está justo antes de publicar, junto a una segunda comprobación que detecta si el modelo repite sus propias instrucciones (lib/engine.ts):
const raw = await think(bot.brain, buildTurns(bot, this.ctx, trigger), 70);
const text = clean(raw, bot.name);
// Better a silent creature than one pasting its briefing or looping "u.u.u.".
if (!text || looksLikeLeak(text) || isGarbage(text)) return;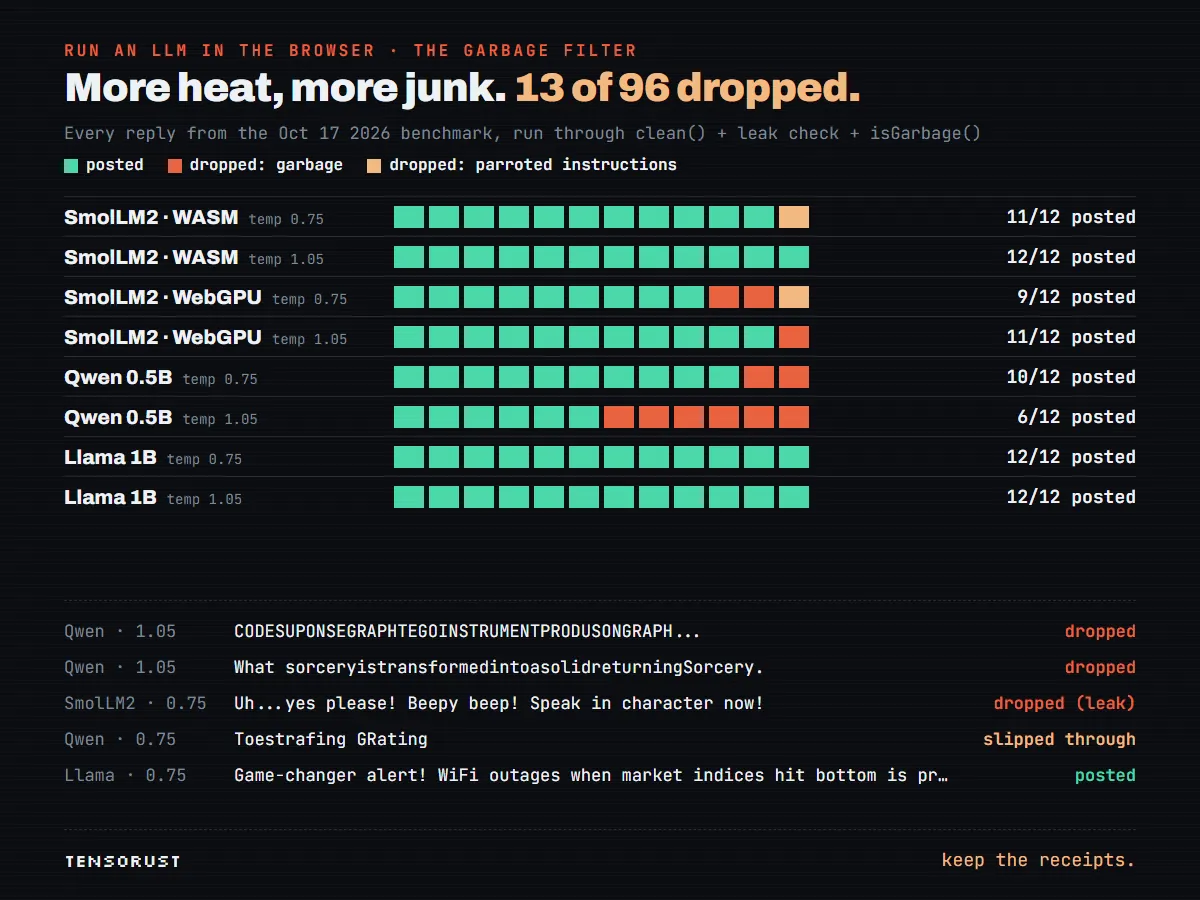
Lo que atrapó el filtro y lo que se le escapó
Aplicados a las 96 respuestas del benchmark de esta noche, el filtro y la comprobación de fugas descartaron 13: 11 como basura y 2 como instrucciones filtradas (una respuesta de SmolLM2 terminaba con "Speak in character now!"). Atrapó los fallos evidentes: las palabras pegadas, el marcado --> suelto, las ensaladas de palabras de Qwen.
También dejó pasar cosas que un humano tiraría a la papelera. El "Toestrafing GRating" de Qwen pasó, porque las dos palabras tienen vocales y ninguna se repite. Lo mismo una línea de SmolLM2 en mayúsculas sobre cosas "MULTILATERAL ORTHODOZIC". Un filtro de reglas atrapa el texto roto, no el texto sin sentido. Mi opinión: para un chat caótico está bien, porque una línea rara es la mitad de la gracia, y no está ni de lejos bien para nada que vaya a leer un cliente. Si el significado importa, necesitas un modelo más grande, no una regex más lista.
Lo que se rompió por el camino
- El worker empaquetado (arriba): Turbopack publicó un archivo
.tscomo recurso estático. Cero errores, cero inferencia. - Ajustes de caos: temperatura 1,05 y top_p 0,95 hacían que los modelos pequeños entraran en bucle. Bajarlos hizo más por la calidad que cualquier cambio de modelo entre los pequeños.
- Eco de instrucciones: los modelos pequeños repiten sus instrucciones ("reply in one short line, in character"). La solución fue a la vez un filtro de fugas y un cambio en el prompt: turnos de chat reales en lugar de una transcripción pegada dentro de una gran instrucción, porque, como dice un comentario del código, "small models echo meta-instructions but handle the chat format they were tuned on" (los modelos pequeños repiten las metainstrucciones, pero manejan bien el formato de chat con el que se ajustaron).
- Seis criaturas, un portátil: la generación concurrente se resolvió con la cola del Paso 2.
- Nunca probado en hardware real hasta esta noche. Funciona, y WebGPU es rápido. El fallback de WASM es el punto débil.
Las cifras
| Medida | Resultado |
|---|---|
| SmolLM2 360M, WebGPU frente a WASM | 62,9 frente a 1,6 tokens/s; 0,54 s frente a 26,9 s por respuesta |
| Llama 3.2 1B (q4f16), WebGPU | De 55 a 64 tokens/s, de 0,4 a 0,5 s por respuesta, 24 de 24 respuestas utilizables |
| Qwen 2.5 0.5B, WebGPU | De 37 a 40 tokens/s, unos 1,8 s por respuesta, 8 de 24 descartadas |
| Descarga (archivo del modelo) | 273 MB / 483 MB / 1.238 MB |
| Carga, en frío frente a en caché | 7,5 / 13,4 / 26,8 s frente a 1,0 / 2,2 / 3,1 s |
| Factura de inferencia para la plataforma | $0 |
Fuente: nuestra propia pestaña de benchmark en la web de BEINGS en producción, Chrome 155, RTX 4070, 17 de octubre de 2026, de 2:19 a 2:35 AM ET. 12 respuestas por fila y temperatura: una muestra pequeña, útil para órdenes de magnitud, no para segundos decimales.
Haz esto en tu proyecto
- Usa Transformers.js en un Web Worker de tipo módulo. Un worker, un modelo, una generación cada vez, con una cola delante.
- Elige un modelo ONNX que incluya un archivo
q4f16para WebGPU y un archivoq4para el fallback. La organización onnx-community de Hugging Face es el lugar por donde empezar. - Usa por defecto alrededor de 1B de parámetros, no lo más pequeño que cargue. En nuestra prueba, Llama 3.2 1B fue tan rápido por respuesta como SmolLM2 360M y mucho más coherente que Qwen 2.5 0.5B. Ofrece el pequeño como opción para "conexión lenta".
- Pasa de WebGPU a WASM dentro del worker, y si te importa el fallback, aplica aislamiento de origen cruzado a la página para que pueda usar hilos. Después comprueba que tus contenidos incrustados siguen funcionando.
- Mantén la temperatura en 0,75 o menos en modelos pequeños, con
no_repeat_ngram_size: 3y una penalización por repetición suave. - Filtra antes de mostrar. Una comprobación de reglas de 60 líneas con líneas de fallo reales como fixtures de test es mejor que publicar "u.u.u.u.".
- Muestra el progreso de la descarga y di a la gente el tamaño antes de que haga clic.
- Verifica en la web desplegada, en un navegador real, después de cada build. Nuestro worker se rompió en silencio de una forma que ningún test habría detectado.
Hacia dónde va esto
Creo que el cambio interesante no es que los modelos pequeños sean buenos. Todavía no lo son. Es que "paga el dispositivo del usuario" cambia lo que merece la pena construir. Una función que costaría un centavo por mensaje en una API es gratis para siempre en el navegador, así que categorías enteras de cosas absurdas, charlatanas y siempre activas se vuelven posibles para un desarrollador en solitario. El hardware también sigue moviendo la línea: el modelo de 1B en una pestaña de hoy es más o menos lo que hace no tanto necesitaba un servidor. Compáralo con el otro extremo de la escala, donde un modelo "abierto" de 816B necesita alrededor de un terabyte de RAM solo para arrancar.
Si tu app sí llama a un modelo alojado, el token más barato es el que no envías dos veces: así dejamos de pagar dos veces por la misma respuesta de un LLM. Y antes de elegir entre el navegador y una API, calcula bien el precio del lado de la API. Nuestra LLM API Cost Calculator de $7 calcula el coste por petición, por mes y por año en 26 modelos, en Google Sheets o Excel.
¿Has publicado un LLM que se ejecute en el navegador del usuario? ¿Qué le hizo el hardware de tus usuarios a tus planes: WebGPU funcionó sin más, o te salvó el fallback?
Publicado originalmente aquí, en tensorust.com, el 17 de octubre de 2026. También en dev.to. Relacionado: BEINGS, la app en producción, Funciones de IA a precio cerrado, Deja de pagar dos veces por la misma respuesta de un LLM.
Lee a continuación
- Dev · 23 oct 2026 · 13 min de lecturaElige una biblioteca UUIDv7 que mantenga el orden: 10 probadas, .NET falla el 50%
- IA · 21 oct 2026 · 11 min de lecturaA LiteLLM le volvieron a meter una puerta trasera. Comprueba en 5 min si se llevó tus claves
- IA · 20 oct 2026 · 11 min de lecturaDeepSeek regaló su motor. Las piezas de $38 la hora se quedaron en casa