
DeepSeek regaló su motor. Las piezas de $38 la hora se quedaron en casa
Leer el resumen completo
En resumen: hoy a las 5:30 AM ET, DeepSeek dijo que DeepInfer, el motor que hay detrás de su propia API, es "now fully open source" (ya totalmente de código abierto). 1,5 millones de personas vieron esa publicación en cinco horas. El propio README de DeepSeek enumera tres cosas que necesita un servicio real y que "no se incluyen en esta versión", y su propio documento de preguntas y respuestas dice que cada GPU de ese servicio genera $38 por hora. Esta mañana cloné el repositorio y lo medí: faltan 4 de las 5 cajas del propio diagrama de DeepSeek que enrutan el tráfico o mantienen la caché, solo el 6,82% del código coincide con vLLM y los kernels para Huawei son un 52% más grandes que los de Nvidia.
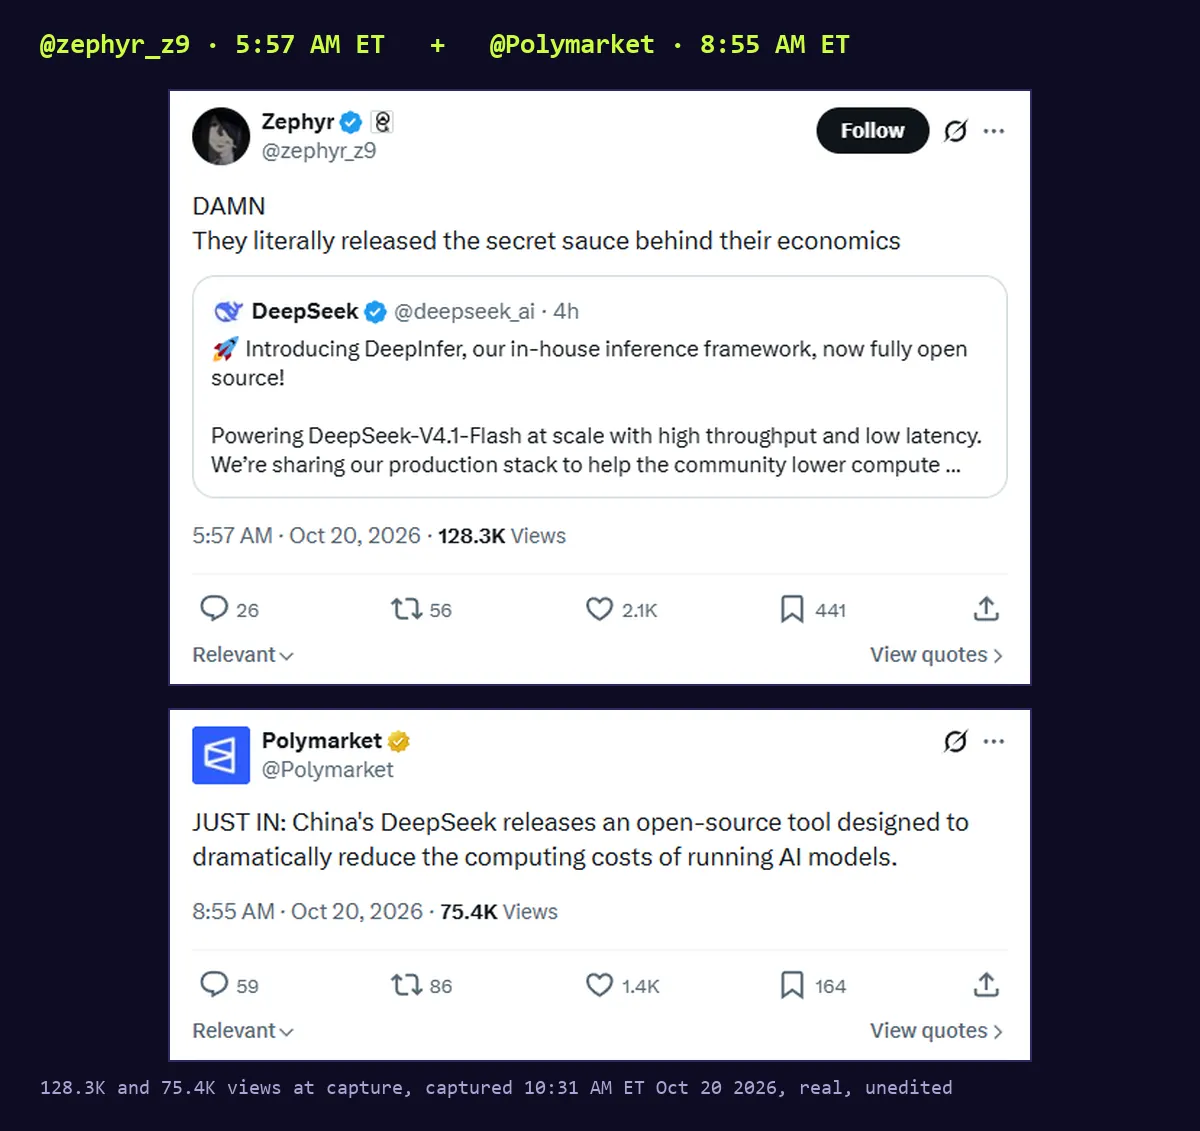
Así que no, @zephyr_z9, no "liberaron literalmente la salsa secreta de su economía". Liberaron el horno. La receta que convierte las GPU en $38 la hora sigue en Hangzhou. Sigue siendo el mejor regalo que un laboratorio de IA ha hecho a los desarrolladores este año, y sigue sin ser lo que dice la publicación.
"Totalmente de código abierto." Su README no está de acuerdo
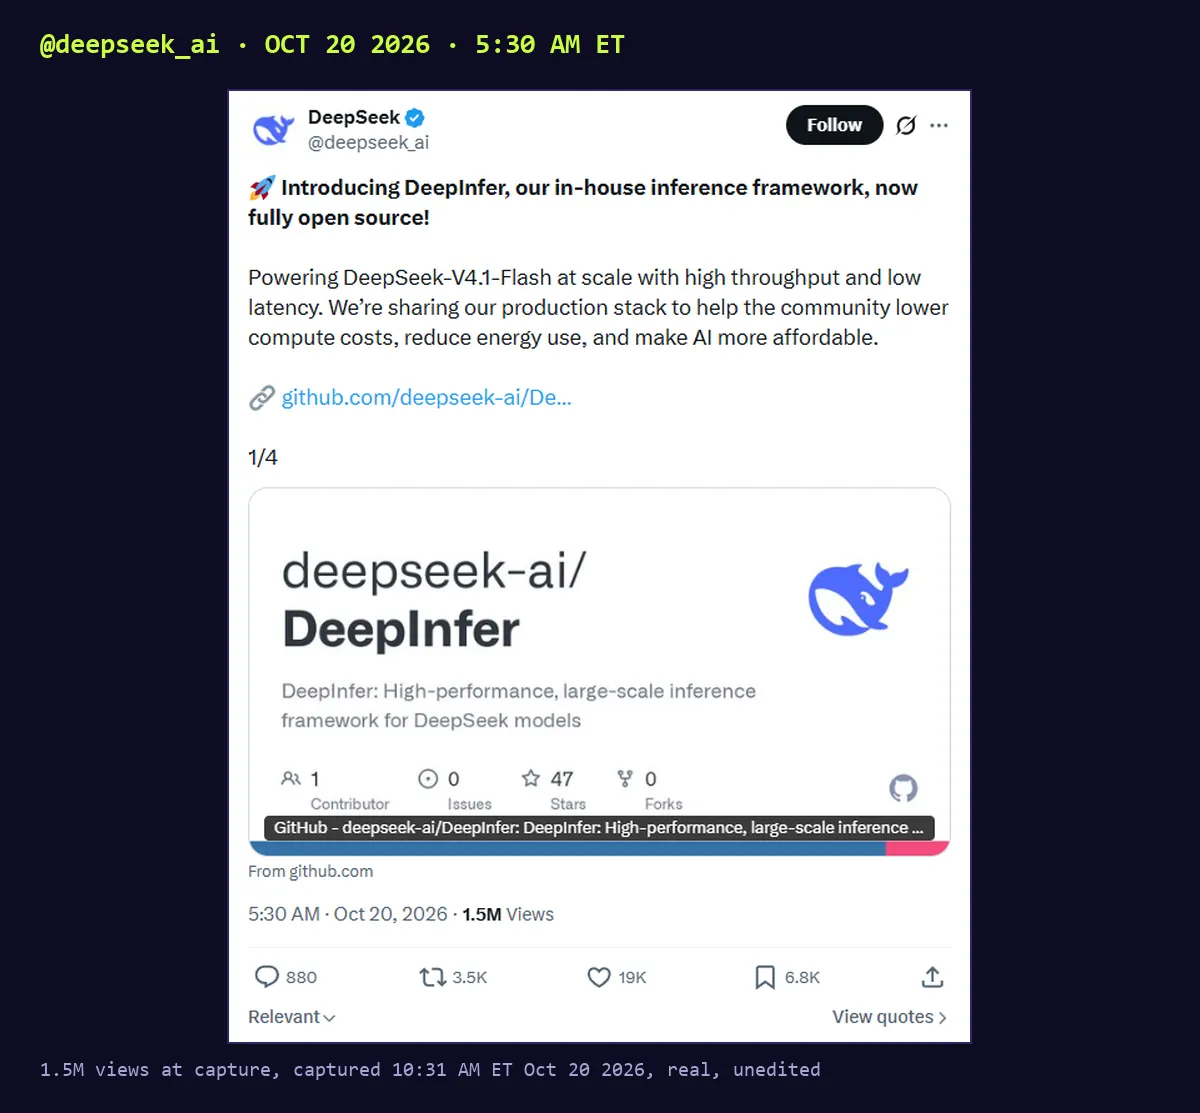
Esta es la publicación, de @deepseek_ai a las 5:30 AM ET. A las 10:31 AM tenía 1,5 M de visualizaciones y 19.000 me gusta. El repositorio llegó a 8.663 estrellas a las 10:33 AM, y el hilo de Hacker News estaba en el n.º 1 con 1.222 puntos y 437 comentarios.
Ahora abre el README. Debajo de "Supported hardware" hay una lista con este título, palabra por palabra: "Required for a complete inference service (not included in this release)" (necesario para un servicio de inferencia completo, no incluido en esta versión):
- "A KV cache system" (un sistema de caché KV)
- "VE/Prefill/Decode disaggregation (most required engine functionality is already implemented)" (desagregación de VE/prefill/decode; la mayor parte de la funcionalidad necesaria del motor ya está implementada)
- "Load balancing across data-parallel replicas for both prefill and decode" (balanceo de carga entre réplicas de paralelismo de datos, tanto para prefill como para decode)
La primera línea del README es igual de honesta: "This open-source release provides offline inference" (esta versión de código abierto ofrece inferencia offline). No hay ningún servidor de API en el repositorio. Lo busqué con grep: el único código HTTP es un endpoint de profiling que se activa con una variable de entorno. Puedes pasar prompts por DeepInfer en tu propio clúster. No puedes poner a un cliente a usarlo.
La jerga, en palabras sencillas. Prefill es el modelo leyendo tu prompt. Decode es el modelo escribiendo la respuesta, token a token. La caché KV son las notas del modelo sobre un prompt que ya ha leído, para no tener que leerlo otra vez. Desagregación significa que el prefill y el decode se ejecutan en máquinas distintas. Un balanceador de carga decide qué máquina recibe tu petición. Cada una de esas piezas es lo que convierte un motor en un negocio.
Puse su propio diagrama al lado del repositorio
DeepSeek publicó junto con la versión un documento de preguntas y respuestas sobre el despliegue. Incluye un diagrama de arquitectura de todo el sistema que sirve V4.1 Flash. Etiqueté cada caja a partir de la lista de "no incluido" del README y de una lectura del código.
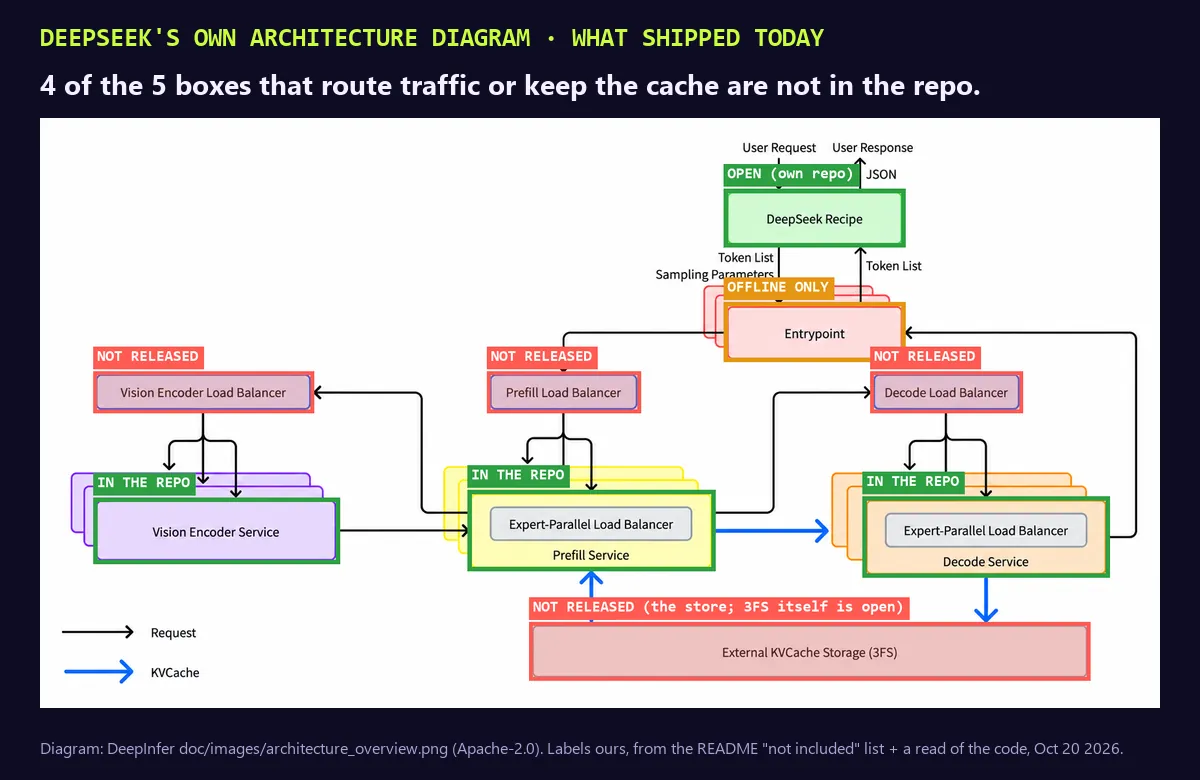
El documento nombra cinco piezas que enrutan el tráfico o mantienen la caché: un Prefill Load Balancer, un Decode Load Balancer, un Vision Encoder Load Balancer, un Expert-Parallel Load Balancer y el KVCache Storage. Solo se publica el de paralelismo de expertos (está en deepinfer/model_executor/eplb/). Eso es 1 de 5. El sistema de archivos 3FS que hay debajo de la caché es abierto desde febrero de 2025. El componente que gestiona la caché encima de él, que el documento llama kvcache-store, no está en el repositorio.
Y DeepSeek te dice por qué, en el propio documento, en un párrafo que casi todo el mundo pasó de largo:
"The KV cache management and load balancing components of the inference system are tightly coupled to our internal infrastructure, so that code is not yet fully open-sourced."
(Los componentes de gestión de la caché KV y de balanceo de carga del sistema de inferencia están muy acoplados a nuestra infraestructura interna, así que ese código todavía no es totalmente de código abierto.) "Todavía no es totalmente de código abierto" y "ya totalmente de código abierto" son frases de DeepSeek, publicadas la misma mañana. Solo una de ellas está en el tuit.
La salsa secreta es la caché, y lo dijeron ellos
Esta es la parte que desmonta las opiniones de "regalaron su economía". DeepSeek enumeró tres objetivos de diseño para el sistema. El tercero: "Retain KV cache for more than 72 hours" (conservar la caché KV más de 72 horas), para que un prompt repetido se salte el costoso paso de lectura. De ahí sale la inferencia barata: no pagas por leer dos veces el mismo código base de 50 páginas.
Mira cuánto valen, según el documento, esas piezas que faltan:
- 155 billones de tokens al día a través de un solo clúster.
- $38 de ingresos por hora de GPU, "con tarifa valle" (el descuento de DeepSeek fuera de las horas punta, así que probablemente es el extremo bajo).
- El balanceo de carga los lleva a cerca del 80% de un benchmark perfectamente equilibrado. Esa diferencia entre una caja de GPU y una caja de GPU ocupada es el negocio.
- Almacenamiento de caché dimensionado a 14,4 TB por GPU, en servidores con 20 SSD de 30,73 TB cada uno, con codificación de borrado para que respondan 10 nodos cualesquiera de 11.
Ahora la comparación que nadie hizo en las respuestas. Google Cloud alquila una B200, de la misma clase Blackwell que el objetivo "SM100" de DeepInfer, por $4,95 la hora en spot, $7,09 con un contrato de 3 años y $11,12 con uno de 1 año (precios actualizados hoy). La cifra de DeepSeek es de 3,4x a 7,7x lo que cuesta alquilar la GPU. Ingresos no son beneficios, y DeepSeek tiene hardware propio en lugar de alquilarlo, pero ese margen es la economía. Y el margen vive en las 4 cajas que no están en el repositorio.
Opinión polémica, y la mantengo: el "dramatically reduce the computing costs of running AI models" (reducir drásticamente el coste de computación de ejecutar modelos de IA) de @Polymarket es verdad para quizá 50 empresas en el planeta. Te explico por qué.
Ejecutarlo como DeepSeek empieza en 128 GPU
El documento es directo sobre el mínimo: "la unidad de despliegue eficiente más pequeña son 64 GPU de prefill más 64 GPU de decode". Los benchmarks del README se "midieron con 4 GPU SM100 para prefill y 64 para decode". El decode pide EP64 o más (los expertos del modelo repartidos entre 64 y 128 GPU). Así que hice la cuenta.
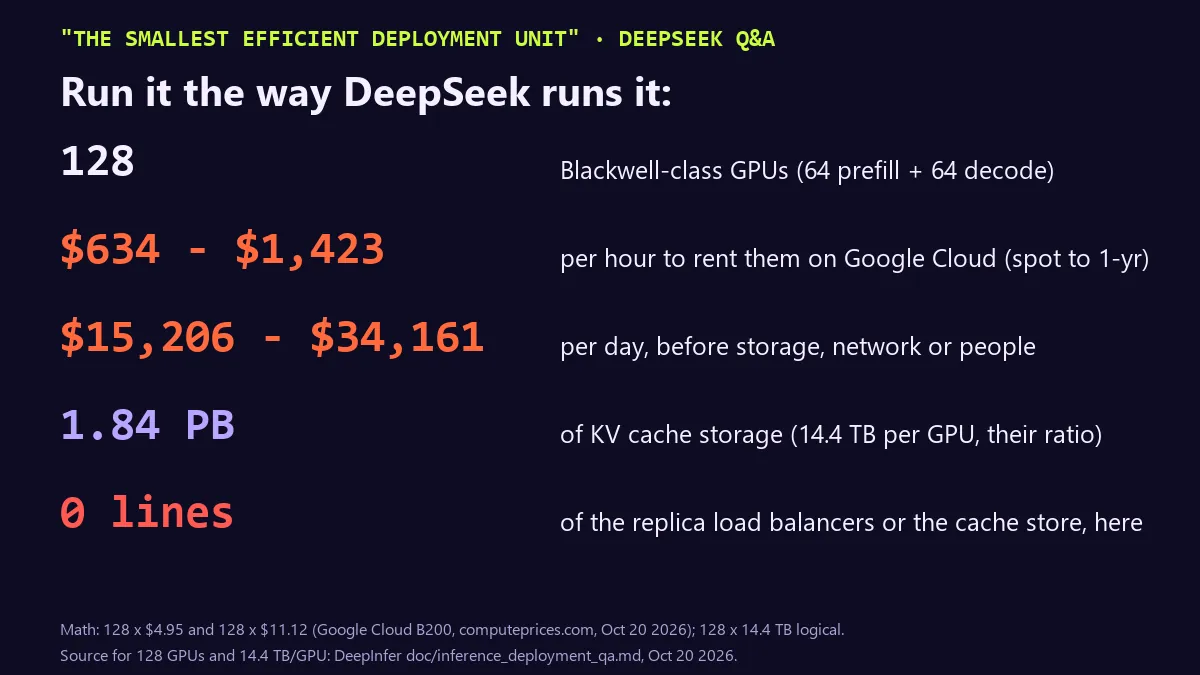
- 128 GPU x de $4,95 a $11,12 = de $634 a $1.423 la hora.
- Eso son de $15.206 a $34.161 al día, antes de almacenamiento, red o un solo ingeniero.
- 1,84 PB de almacenamiento de caché con su proporción de 14,4 TB por GPU.
- Más los balanceadores de carga y el almacén de caché, que ahora tienes que escribir tú.
Compáralo con lo otro de DeepSeek que salió en el timeline esta semana: el V4.1 Flash de 1 bit de Unsloth, que reduce 508GB a 250GB y funciona en una máquina con 128GB o más de RAM. Ese es el modelo abierto que la mayoría de la gente va a tocar de verdad. DeepInfer es para nubes. Si eres un dev indie, el regalo real de DeepSeek para ti sigue siendo la API barata, no este repositorio.
Su documento tiene incluso la mejor frase de todo el lanzamiento. ¿Se puede repartir prefill y decode entre centros de datos? Sí, "a costa de algo de fiabilidad; por ejemplo, la fibra que une los centros de datos se corta con facilidad por obras". Respeto. Es un equipo al que una excavadora le ha arruinado la semana.
vLLM dice "construido principalmente sobre vLLM". Yo medí un 6,82%
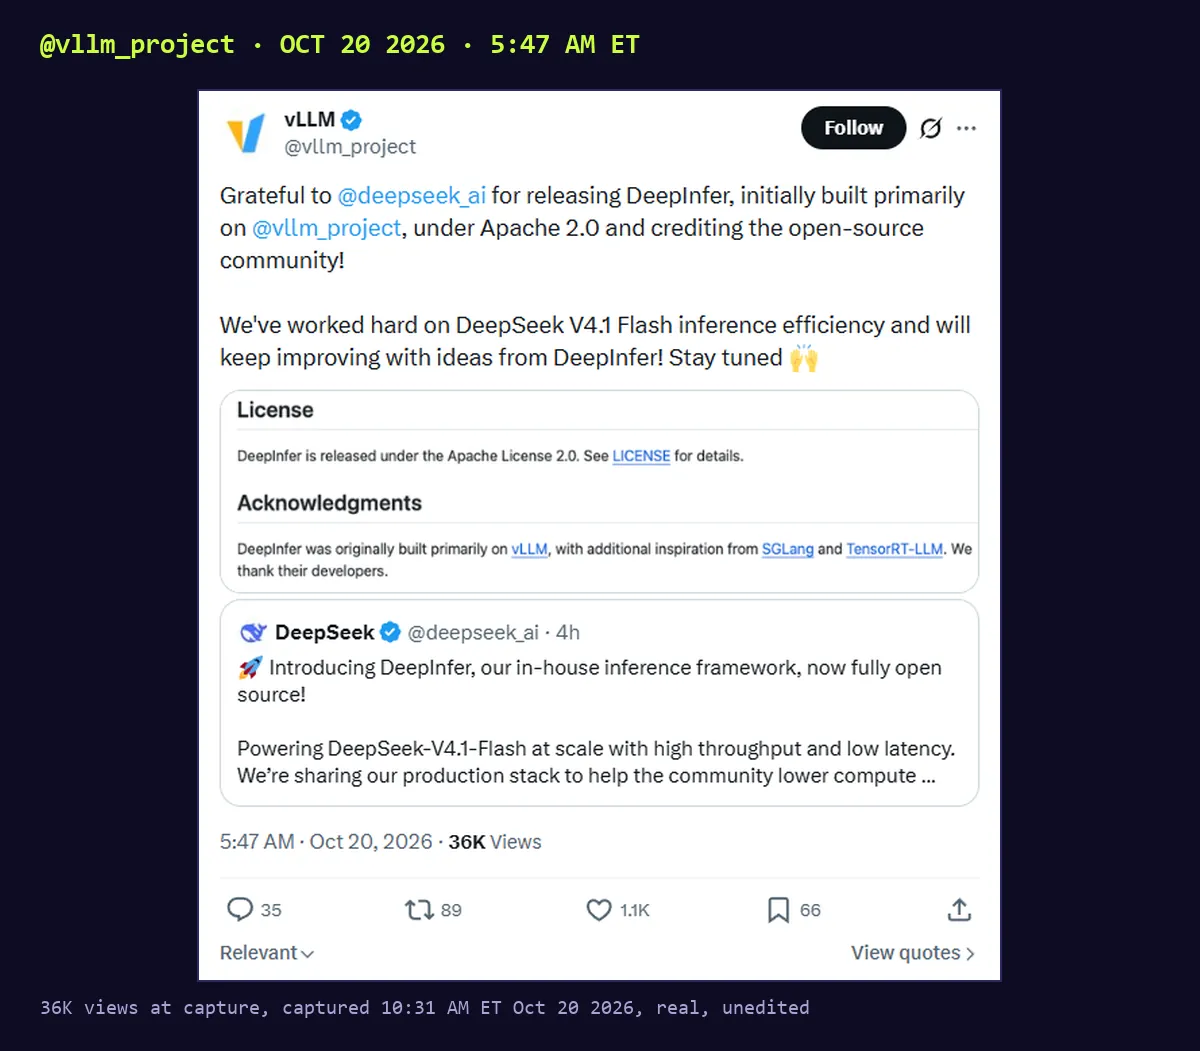
La otra gran reacción vino del equipo de vLLM, el motor de código abierto sobre el que funciona la mayor parte de la industria. Su publicación es generosa, y el README de DeepSeek sí dice que DeepInfer "was originally built primarily on vLLM" (se construyó originalmente, sobre todo, sobre vLLM).
Así que medí cuánto queda de vLLM. Cloné DeepInfer (commit 774ce24) y vLLM en nueve versiones, desde v0.2.0 (2023) hasta la rama main de hoy. Tomé cada línea de Python de 25 caracteres o más del paquete deepinfer/ de DeepInfer, quité comentarios y líneas vacías, colapsé los espacios en blanco y comprobé si cada línea aparecía exactamente igual en algún punto de cada versión de vLLM. El script tiene 60 líneas de Python, tardó cerca de un minuto y no necesitó GPU.
def norm(l):
    l = l.strip()
    if not l or l.startswith('#'): return None
    if len(l) < 25: return None   # skip trivial lines
    return re.sub(r'\s+', ' ', l)

# every .py file in each vLLM tag, read straight out of git
p = subprocess.run(['git', '-C', VL, 'cat-file', '--batch'],
                   input='\n'.join(f'{ref}:{f}' for f in files).encode(),
                   capture_output=True)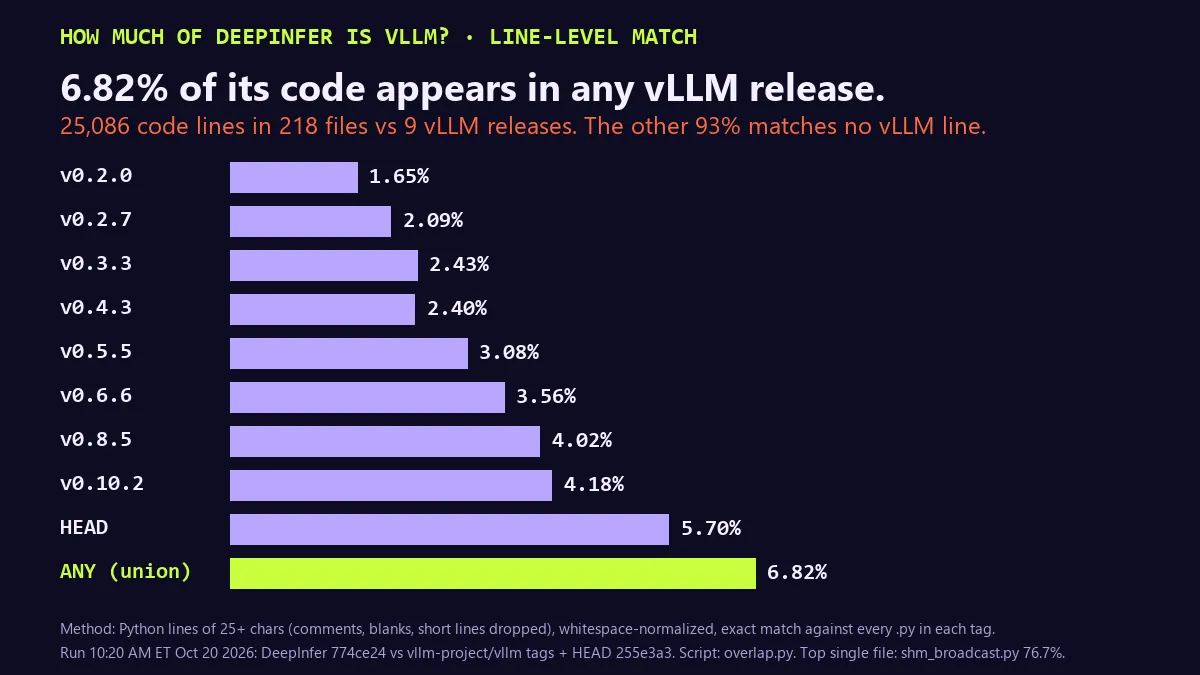
Resultado: 1.711 de 25.086 líneas (6,82%) aparecen en al menos una versión de vLLM. La mejor versión individual es la main de vLLM de hoy, con un 5,70%, lo que sobre todo significa que ambos proyectos adoptaron las mismas ideas nuevas. El archivo con más sabor a vLLM es shm_broadcast.py, una cola de mensajes en memoria compartida, con un 76,7%. El núcleo del motor, llm_engine.py, está en un 19,2%. El código del modelo V4 ronda entre el 5 y el 12%.
La estructura de carpetas todavía dice vLLM: worker/cache_engine.py, sequence.py, model_runner.py. Son los nombres que vLLM usaba allá por 2023. Pero el código de dentro se reescribió. Este método no detecta variables renombradas ni refactorizaciones, así que toma el 6,82% como el suelo del parecido familiar, no como una puntuación de plagio. Mi lectura: "construido sobre vLLM" es como decir que un rascacielos está construido sobre el aparcamiento que había antes. Es verdad, es generoso, y DeepSeek merece reconocimiento de verdad por escribir el otro 93%.
Un 52% más de código para Huawei que para Nvidia
Esto es, creo, de lo que va realmente el lanzamiento. Los kernels propios de DeepInfer (los pequeños programas de GPU que hacen las cuentas) viven en tilelang_ops/, con un backend por chip. Los mismos 30 kernels, dos versiones de cada uno. Conté las líneas no vacías.
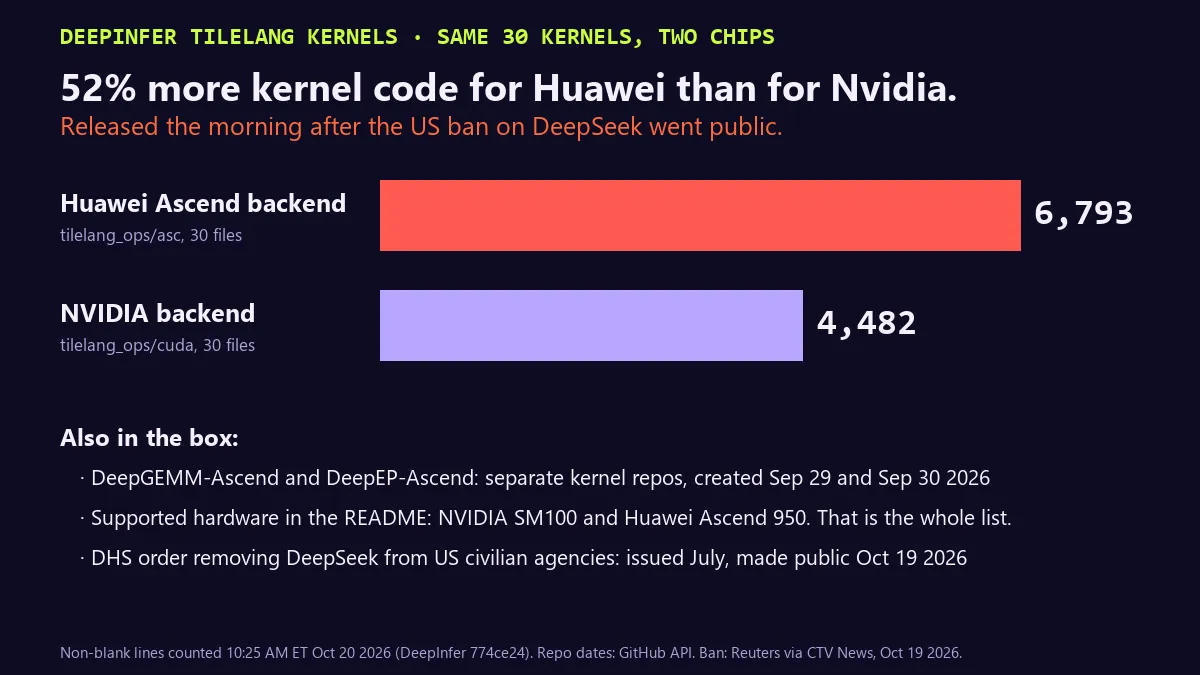
- Backend de Huawei Ascend: 6.793 líneas. Backend de NVIDIA: 4.482. Eso es un +51,6%.
- Hardware compatible según el README: "NVIDIA SM100 GPUs" y "Huawei Ascend 950 NPUs". Esa es toda la lista. Ni H100. Ni AMD.
- Las bibliotecas de kernels para Ascend salen como repositorios propios, DeepGEMM-Ascend y DeepEP-Ascend, creados el 29 y el 30 de septiembre de 2026, tres semanas antes de hoy.
- Un día antes del lanzamiento, Reuters informó de que el Departamento de Seguridad Nacional de EE. UU. está ordenando a las agencias federales civiles retirar los productos de DeepSeek y los servicios de terceros construidos sobre sus modelos (la orden se emitió en julio y se hizo pública el 19 de octubre).
- Ese mismo día, The Information informó (vía @unusual_whales, 149.000 visualizaciones) de que DeepSeek y Huawei se alían en nuevos diseños de chips de IA para plantar cara a Nvidia.
Parte de ese +52% es simplemente el coste de un chip más joven: los kernels de Ascend necesitan más ayuda que los de CUDA. Pero nadie escribe 6.793 líneas para un chip en el que no piensa seguir apostando. Esto es lo que creo que está pasando de verdad, y nunca lo dirán en voz alta: es una presentación comercial de Huawei con licencia Apache. Cada nube china que quiera servir DeepSeek a los precios de DeepSeek tiene ahora un motor de nivel de producción que funciona en chips que EE. UU. no puede cortar. El lunes, EE. UU. prohíbe DeepSeek en sus agencias. El martes, DeepSeek abarata servir su modelo para todos los demás, sobre silicio de Huawei. Probablemente el lanzamiento de código abierto mejor sincronizado del año.
Una prueba más para el montón de "es un sistema de producción chino, no una demo": 1.147 de 40.638 líneas no vacías del paquete llevan comentarios o docstrings en chino, como """compress 内核固定开启 fast math。""" ("el kernel compress siempre activa fast math"). Nadie escribió esto para un blog de lanzamiento. Todo el historial son 3 commits: un "initial commit" de 345 archivos y 63.326 líneas a las 12:09 AM ET, y luego dos actualizaciones de documentación. Se exportó esta mañana desde algún sitio privado.
Aun así, más abierto que OpenAI. Esa es la verdadera pulla
Para ser justos con DeepSeek, e injustos con todos los demás: la versión abierta de OpenAI fue gpt-oss en agosto de 2025, pesos bajo Apache 2.0 con código de referencia. OpenAI, Anthropic y Google han publicado cero líneas de los sistemas que de verdad sirven ChatGPT, Claude o Gemini a los usuarios de pago. DeepSeek acaba de publicar el motor, los kernels, el balanceador de expertos, un servicio de tokenizador escrito sobre todo en Rust (deepseek-recipe), su estructura de almacenamiento, sus ingresos por hora de GPU y su tráfico.
Así que elige a tu villano. ¿Es el laboratorio que publica el 93% de un motor de producción y lo llama 100%, o los laboratorios que publican el 0% y se llaman a sí mismos los buenos?
El ranking de las opiniones de hoy
- La más equivocada: @zephyr_z9, "They literally released the secret sauce behind their economics" (liberaron literalmente la salsa secreta de su economía; 128.000 visualizaciones). La salsa es una caché de 72 horas y cuatro balanceadores de carga. No se publicó ninguna de las dos cosas.
- La más equivocada para la mayoría de los lectores: @Polymarket, "dramatically reduce the computing costs of running AI models" (75.000). Para quien tenga 128 Blackwell y un petabyte de SSD, claro.
- La más generosa: @vllm_project, "initially built primarily on vLLM". Hoy, un 6,82%. Que se lleven el mérito de los cimientos; el edificio es de DeepSeek.
- La más precisa: el propio README de DeepSeek. Alguien de ese equipo escribió "not included in this release" con todas las letras. La publicación de marketing no lo leyó.
Las cifras hasta ahora
- Cajas de la capa de enrutamiento y caché de DeepSeek que se publicaron: 1 de 5 (EPLB), leído a las 10:25 AM ET del 20 de octubre
- Líneas de DeepInfer encontradas en alguna de 9 versiones de vLLM: 1.711 de 25.086 (6,82%)
- Líneas de kernels, Huawei Ascend frente a NVIDIA: 6.793 frente a 4.482 (+51,6%)
- Ingresos de DeepSeek por hora de GPU: $38 (su documento) frente a entre $4,95 y $11,12 por alquilar una B200 en Google Cloud
- Despliegue eficiente más pequeño: 128 GPU, de $634 a $1.423 la hora
- Estrellas: 8.663 a las 10:33 AM ET, unas 10 horas después del primer commit
Mi apuesta, y tu turno
Predicción: antes del 30 de noviembre, vLLM y SGLang incorporan la mayoría de los trucos de DeepInfer (el decoding con tokens borrador, el replay SWA acotado) y las nubes de EE. UU. sirven V4.1 Flash más rápido que hoy. Y a 31 de diciembre, nadie fuera de China lo ejecuta como DeepSeek, con la caché de 72 horas y los cuatro balanceadores, porque DeepSeek se los quedó. Si me equivoco, enséñame el clúster y escribiré la corrección con tu nombre en el titular.
Tu turno: ¿es justo llamar "totalmente de código abierto" a una versión con la que no puedes servir ni una sola petición de API? Sí o no, y explica por qué en las respuestas. @deepseek_ai, también puedes contestar.
¿Quieres ver lo que te cuesta V4.1 Flash por API frente a alquilar las GPU tú mismo? La LLM API Cost Calculator ($7, Google Sheets + Excel, 26 modelos) hace la cuenta por petición en una sola hoja. La versión gratuita está en el sitio, en tensorust.com/tools/llm-api-cost/.
Relacionado en tensorust.com: Meta liberó un modelo de 816B. Ejecutarlo requiere cerca de 1TB de RAM, Benchmark de proxies de LLM: 200 llamadas duplicadas se quedaron en 1 y La estadística del 60% de Theo es un gráfico de caídas.
Método y datos: DeepInfer clonado en 774ce24 (20 de octubre de 2026), etiquetas de vllm-project/vllm v0.2.0, v0.2.7, v0.3.3, v0.4.3, v0.5.5, v0.6.6, v0.8.5, v0.10.2 y main en 255e3a3. Todos los recuentos se ejecutaron entre las 10:20 y las 10:35 AM ET del 20 de octubre de 2026. Capturas de X tomadas a las 10:31 AM ET, reales y sin editar. Precios de GPU de la página de B200 de Google Cloud en computeprices.com, actualizada el 20 de octubre de 2026.
Publicado originalmente aquí, en tensorust.com, el 20 de octubre de 2026. También en X (@TensorustAI), X (@MattBusel) y dev.to. Relacionado: Calculadora gratuita de coste de APIs de LLM, El modelo de 816B de Meta necesita 1TB de RAM, Benchmark de proxies de LLM.
Más: el autor, lecturas relacionadas, compartir y un juego gratis
Lee a continuación
Herramienta gratuita: calculadora de coste de APIs de LLM → Tokens de entrada, tokens de salida, peticiones al día: el coste mensual en 24 modelos de GPT, Claude y Gemini.
- IA · 21 oct 2026 · 11 min de lecturaLiteLLM ha vuelto a tener una puerta trasera. Comprueba en 5 minutos si se llevó tus claves
- IA · 19 oct 2026 · 13 min de lecturaLa estadística del 60% de Theo es un gráfico de caídas: 43 horas de incidentes de Codex
- IA · 18 oct 2026 · 13 min de lecturaBackoff exponencial con jitter: 64 de 100 llamadas a LLM siguieron fallando