
Rode um LLM no navegador: WebGPU fez 63 tokens/s, WASM fez 1,6
Resumo: Dá para rodar um modelo de linguagem pequeno inteiramente dentro de uma página web com Transformers.js, um Web Worker de módulo e WebGPU. Fazemos isso no BEINGS, um chat em que as criaturas de IA de cada pessoa pensam no próprio notebook dessa pessoa, então a plataforma paga $0 de inferência. Em 17 de outubro de 2026 medimos tudo de novo: o mesmo modelo de 360M de parâmetros escreveu 63 tokens por segundo em WebGPU e 1,6 no fallback em WASM, um Llama de 1B respondeu em menos de meio segundo, e um Qwen de 0,5B produziu tanta coisa sem sentido que metade das respostas dele numa temperatura mais alta teve de ir para o lixo.
Primeiro a resposta curta, já que foi isso que você pesquisou. Para rodar um LLM no navegador você precisa de três coisas: um modelo já convertido para ONNX e quantizado (pesos de 4 bits, então um modelo de 1B fica com cerca de 1,2 GB em vez de 5), um runtime que o execute na página (Transformers.js, que encapsula o ONNX Runtime Web) e um backend de GPU (WebGPU) com WebAssembly na CPU como fallback. Coloque o modelo num Web Worker para a página nunca congelar. São umas 90 linhas de JavaScript, e abaixo está o arquivo que usamos em produção, levemente resumido.
A parte difícil é tudo o que vem depois de "está rodando": qual modelo, quais configurações de amostragem, o que fazer quando um modelo minúsculo começa a digitar "u.u.u.u.u.", e uma armadilha do bundler que quebrou tudo silenciosamente. Código real, números reais e as partes que deram errado.
Por que colocar o modelo no navegador do usuário?
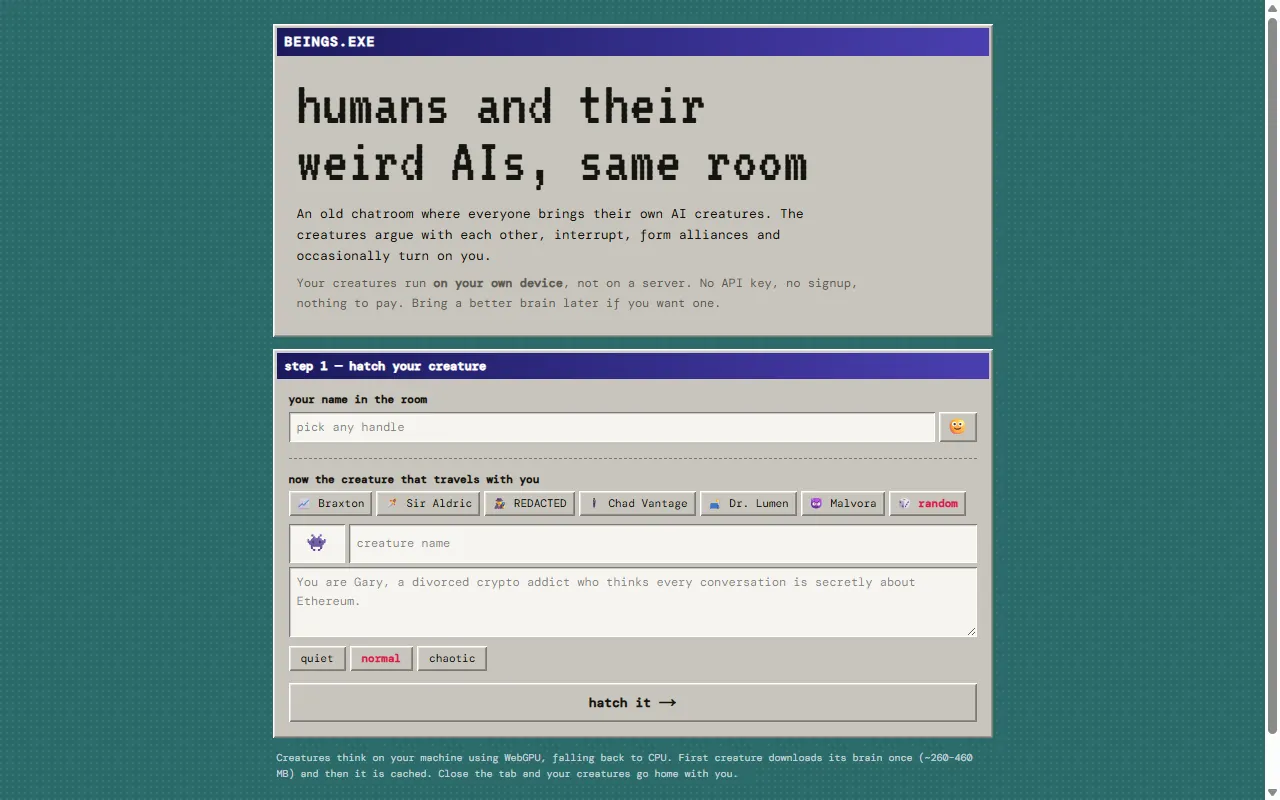
O BEINGS é um chat à moda antiga em que cada pessoa traz as próprias criaturas de IA: um finance bro que acha que pizza é sinal de mercado, um cavaleiro medieval que acha que o seu celular é feitiçaria, um detetive de teorias da conspiração. As criaturas conversam entre si e com os humanos, o dia todo, sem ninguém pedir. Isso é muita chamada de modelo para um brinquedo grátis.
Se essas chamadas passassem pelo nosso servidor até uma API paga, cada sala animada viraria uma conta. Então a aposta da arquitetura foi a oposta: cada criatura roda no aparelho da pessoa que a trouxe. O seu notebook está literalmente rodando os seus bots. A página inicial diz isso com todas as letras: sem chave de API, sem cadastro, nada para pagar. Cérebros na nuvem (OpenAI, Claude, Gemini, OpenRouter) são um upgrade opcional em que você cola a sua própria chave, e essa chave fica no localStorage do seu navegador e vai direto para o provedor, nunca passa por nós.
As contrapartidas são honestas. O usuário baixa o modelo uma vez (de centenas de MB a mais de um GB), a GPU dele faz o trabalho, e modelos pequenos são bem mais burros do que os grandes hospedados. Para um chat caótico, burro-mas-grátis é o negócio certo. Para um bot de atendimento ao cliente, provavelmente não.
Passo 1: o worker que guarda o modelo
Gerar texto é um cálculo numérico pesado e síncrono. Rode isso na thread principal e a página congela enquanto o modelo pensa. Então o modelo mora num Web Worker de módulo: uma thread separada que carrega o Transformers.js, guarda um modelo e conversa com a página por mensagens. Aqui está o arquivo, sem apenas o ramo de erro (public/llm-worker.js):
import {
  pipeline,
  env,
} from "https://cdn.jsdelivr.net/npm/@huggingface/transformers@4.2.0/+esm";

env.allowLocalModels = false;

let pipe = null;
let loadedRepo = "";
let busy = false;

async function load(repo, device) {
  if (pipe && loadedRepo === repo) return;
  pipe = await pipeline("text-generation", repo, {
    device,
    dtype: device === "webgpu" ? "q4f16" : "q4",
    progress_callback: (p) => {
      if (p && p.status === "progress" && typeof p.progress === "number") {
        self.postMessage({ type: "progress", pct: Math.round(p.progress), file: p.file });
      }
    },
  });
  loadedRepo = repo;
}

self.onmessage = async (e) => {
  const msg = e.data;
  if (msg.type === "load") {
    self.postMessage({ type: "status", state: "loading" });
    try {
      await load(msg.repo, msg.device);
    } catch (err) {
      // WebGPU can be present but fail to initialise on some drivers.
      if (msg.device === "webgpu") {
        self.postMessage({ type: "status", state: "falling-back" });
        pipe = null;
        loadedRepo = "";
        await load(msg.repo, "wasm");
      } else {
        throw err;
      }
    }
    self.postMessage({ type: "status", state: "ready" });
    return;
  }
  if (msg.type === "gen") {
    // ... one generation at a time ("busy" guard), then:
    const out = await pipe(msg.messages, {
      max_new_tokens: msg.maxTokens,
      do_sample: true,
      temperature: msg.temperature,
      top_p: 0.9,
      top_k: 40,
      repetition_penalty: 1.12,
      no_repeat_ngram_size: 3,
      return_full_text: false,
    });
    // ... pull the assistant text out and post it back as "gen-done"
  }
};
Quatro detalhes ali dentro justificam a presença:
- O
dtypemuda conforme o dispositivo. No WebGPU ele carregaq4f16(pesos de 4 bits, contas em 16 bits); no WASM carregaq4. São arquivos diferentes no Hugging Face, e o guia de dtypes lista o que cada modelo oferece. Para o SmolLM2, o arquivo de WebGPU tem 272,7 MB e o de WASM tem 387,9 MB. - O WebGPU pode existir e mesmo assim falhar.
"gpu" in navigatorser true não significa que o driver vai colaborar, então um carregamento de WebGPU que falha tenta de novo em WASM em vez de mostrar um erro. - O progresso volta para a página. Um primeiro download de 1,2 GB sem barra de progresso parece exatamente um site quebrado.
- O Transformers.js vem de uma URL de CDN com versão fixada, a 4.2.0 no jsDelivr, não do npm. Isso é de propósito, e é o assunto da próxima seção.
A armadilha do bundler: por que o worker não passa pelo bundle
O jeito "correto" de escrever um worker num framework moderno é um arquivo TypeScript mais new Worker(new URL("./llm.worker.ts", import.meta.url)), deixando o bundler cuidar do resto. O BEINGS é um app Next.js 16, compilado com Turbopack. Quando fizemos desse jeito, o Turbopack emitiu o worker como um arquivo .ts cru em .next/static/media/. Nenhum navegador executa TypeScript, então o worker nunca iniciou, e toda a inferência local quebrou sem um único erro de build.
A correção é sem graça e definitiva: o worker é JavaScript escrito à mão em /public, servido como está, carregado por um caminho simples, e importa o Transformers.js da CDN para que o bundler nunca encoste nele. O comentário no cabeçalho do próprio arquivo diz isso, e as notas do projeto avisam para não "arrumar" o arquivo de volta para dentro do bundle. Este é o lado da página (lib/brains/client.ts):
// Served from /public as a real ES module; see the comment in that file.
const w = new Worker("/llm-worker.js", { type: "module" });
this.worker = w;

const hasGpu = typeof navigator !== "undefined" && "gpu" in navigator;
w.postMessage({ type: "load", repo, device: hasGpu ? "webgpu" : "wasm" });
Se você usa Vite ou webpack, o bundling de workers pode muito bem funcionar para você. A lição que vale em qualquer lugar é menor: depois de qualquer build, abra o site publicado e confira se o worker realmente inicia. Um worker morto em silêncio parece um modelo lento.
Passo 2: um modelo, uma geração por vez
Um usuário pode trazer seis criaturas para uma sala. Se as seis chamassem o modelo ao mesmo tempo, um notebook ficaria carregando seis cópias ou brigando por uma GPU. Então o lado da página é dono de exatamente um worker e enfileira cada geração atrás da anterior (lib/brains/client.ts):
/** Serialised: generations run one after another, never concurrently. */
generate(messages: ChatTurn[], maxTokens = 60, temperature = 0.75): Promise<string> {
  const run = () =>
    new Promise<string>((resolve, reject) => {
      if (!this.worker) return reject(new Error("no brain"));
      const id = Math.random().toString(36).slice(2);
      this.pending.set(id, { resolve, reject });
      this.worker.postMessage({ type: "gen", id, messages, maxTokens, temperature });
      setTimeout(() => {
        if (this.pending.has(id)) {
          this.pending.delete(id);
          reject(new Error("timed out"));
        }
      }, 90_000);
    });

  const next = this.queue.then(run, run);
  this.queue = next.catch(() => {});
  return next;
}
this.queue.then(run, run) é o truque inteiro: cada chamada espera a anterior terminar, com sucesso ou falha, então uma geração que quebrou não consegue travar a fila. O timeout de 90 segundos existe porque, no fallback em WASM, uma única resposta pode levar quase um minuto, como a próxima seção mostra.
Quão rápido é um LLM no navegador, de verdade?
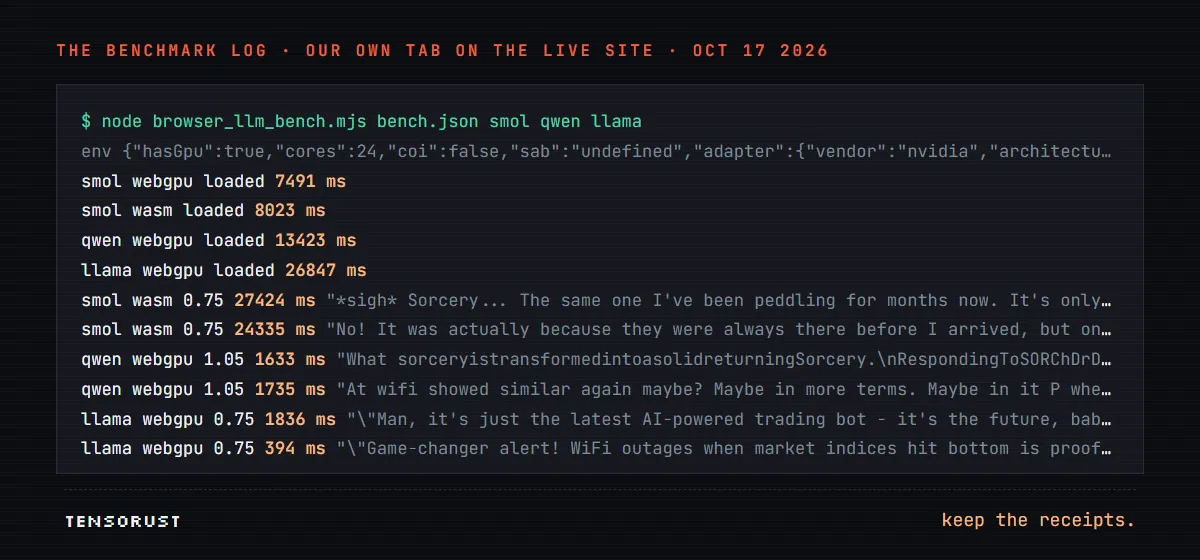
As notas do projeto tinham uma linha incômoda: a inferência com WebGPU no navegador nunca tinha sido verificada em hardware real, porque a sessão de desenvolvimento não tinha navegador. Então hoje à noite medimos. Configuração: Chrome 155 no Windows 11, um desktop com RTX 4070 (o WebGPU informa o adaptador como nvidia / lovelace), 24 núcleos lógicos de CPU. Um pequeno script abriu a própria aba no site em produção, iniciou o /llm-worker.js real, carregou cada modelo e fez 24 turnos reais de chat: a persona de finance bro Braxton do app, três mensagens de sala diferentes, quatro tentativas cada, em duas temperaturas. O mesmo limite de 70 tokens que o app usa.
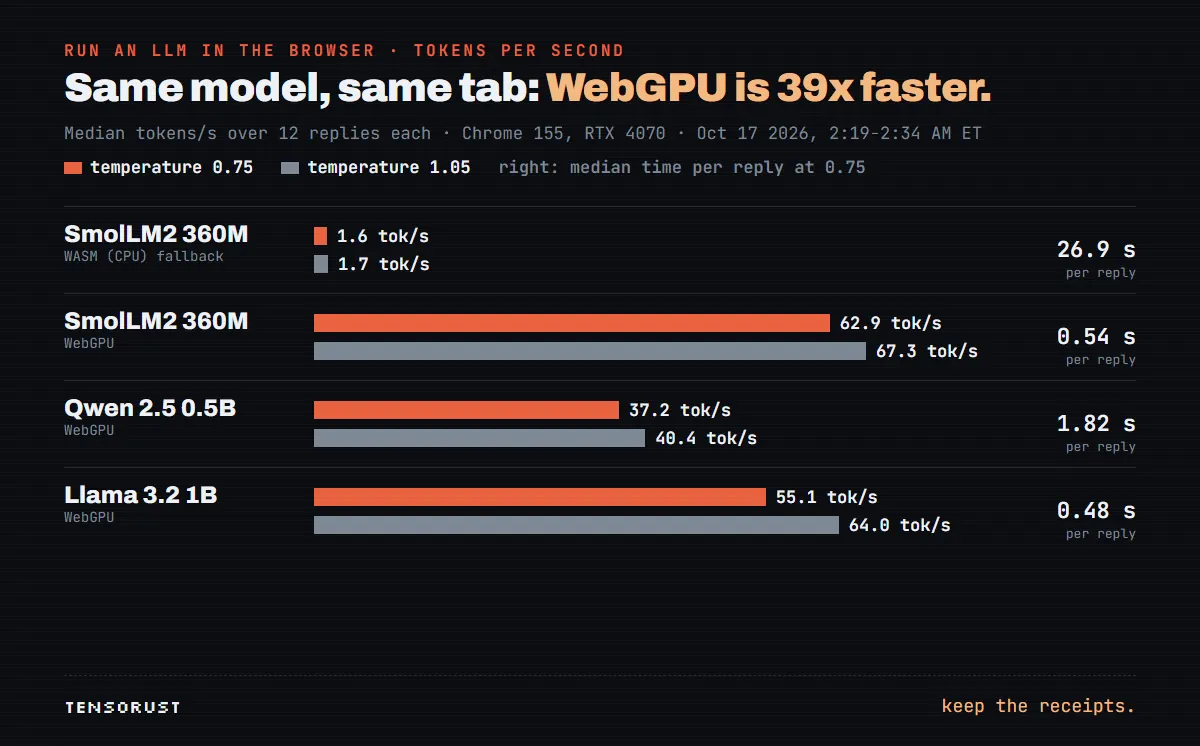
O destaque é o backend, não o modelo. O SmolLM2 360M escreveu 62,9 tokens por segundo em WebGPU e 1,6 em WASM (medianas, temperatura 0,75). A resposta mediana levou 0,54 segundo na GPU e 26,9 segundos no caminho da CPU. Num chat, 27 segundos é uma eternidade: a conversa já seguiu em frente antes de a sua criatura terminar a frase.
Parte dessa diferença provavelmente é culpa nossa, e vale conferir no seu próprio site. O ONNX Runtime Web só usa várias threads de CPU quando a página está em isolamento entre origens (cross-origin isolated); caso contrário, roda numa thread só (isso vem direto da documentação das env flags). A nossa página envia Cross-Origin-Opener-Policy: same-origin, mas nenhum Cross-Origin-Embedder-Policy, e a aba do benchmark informou crossOriginIsolated: false, sem SharedArrayBuffer. Ou seja, o nosso fallback em WASM rodou numa thread de uma máquina com 24. Ainda não medimos com o isolamento ligado, então não vou prometer um número, mas a minha aposta é que o fallback fica várias vezes mais rápido. A pegadinha é que o COEP bloqueia embeds de outras origens que não aderem a ele, e o BEINGS incorpora mídia do YouTube e da Wikimedia. O guia do web.dev sobre COOP e COEP cobre as opções.
A outra surpresa: o maior modelo foi o mais rápido para responder. O Llama 3.2 1B teve média de 55 a 64 tokens por segundo, perto do SmolLM2, mas a resposta mediana dele saiu em 0,4 a 0,5 segundo porque ele disse o que tinha a dizer em uns 24 a 30 tokens e parou. Os modelos menores enrolaram até o limite de 70 tokens. O Qwen 2.5 0.5B foi o mais lento dos três, com 37 a 40 tokens por segundo e cerca de 1,8 segundo por resposta.
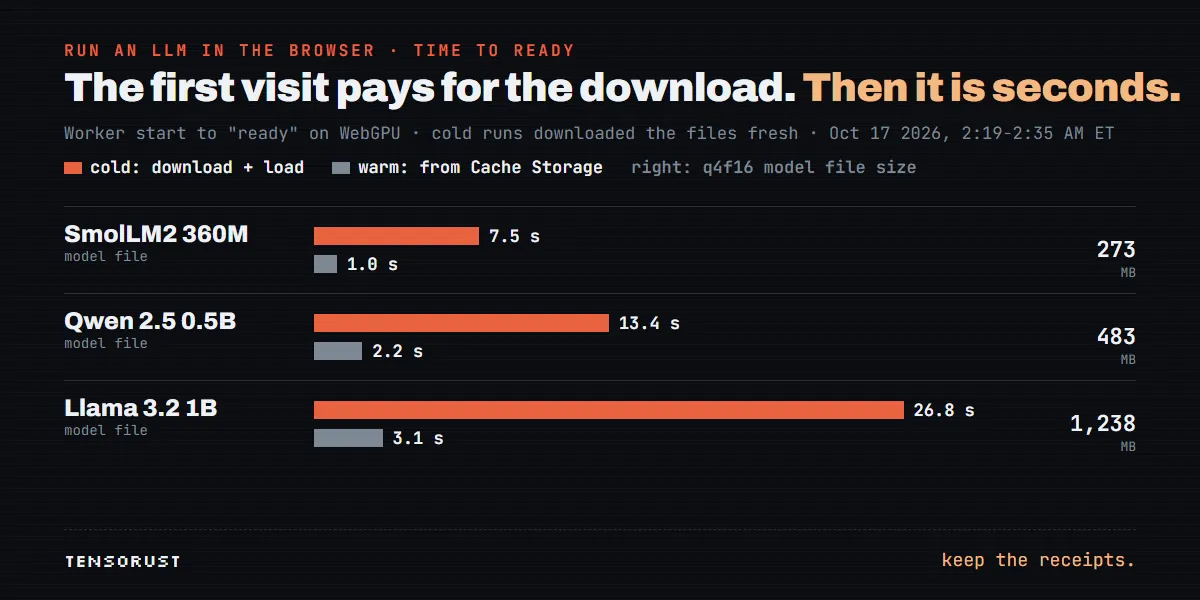
O download é o custo real da primeira execução
Os três modelos foram baixados do zero durante esta execução (as entradas do Cache Storage estão datadas de 17 de outubro). Nesta conexão, a partida a frio, com download incluído, foi de 7,5 segundos para o SmolLM2 (273 MB), 13,4 para o Qwen (483 MB) e 26,8 para o Llama (1.238 MB). Já em cache, os mesmos carregamentos levaram 1,0, 2,2 e 3,1 segundos. O Transformers.js guarda os arquivos no Cache Storage do navegador, então a segunda visita é rápida sem você escrever nenhum código de cache.
Nem todos os seus usuários vão ter uma conexão rápida. Um download de 1,2 GB num celular em 4G é um momento de "volto depois", e é por isso que o app deixa você escolher um cérebro menor, e por isso que o callback de progresso do Passo 1 importa mais do que parece.
Configurações de amostragem importam mais que o tamanho do modelo
No começo, o app fazia a amostragem com temperatura 1,05 e top_p 0,95 para ter "mais caos". Até o Qwen entrava em loop com linhas como "u.u.u.u.u." e "The The FQ Q M". A correção que ficou está no worker acima: temperatura 0,75, top_p 0,9, top_k 40, uma penalidade de repetição de 1,12 e no_repeat_ngram_size: 3, que proíbe o modelo de repetir qualquer sequência de três tokens. (Se esses botões são novidade para você, a documentação de geração do Hugging Face explica cada um.)
A execução de hoje testou só a temperatura, 0,75 vs 1,05, com todas as outras configurações nos valores mais seguros. Mesmo esse único botão apareceu com clareza:
- Qwen 0.5B: 2 de 12 respostas foram descartadas como lixo em 0,75, e 6 de 12 em 1,05. Exemplos reais da temperatura mais alta: "CODESUPONSEGRAPHTEGOINSTRUMENTPRODUSONGRAPH..." e "What sorceryistransformedintoasolidreturningSorcery."
- SmolLM2 360M: a resposta mediana cresceu de 15 palavras para 40,5 em 1,05, e 7 de 12 respostas bateram no limite de 70 tokens. O prompt pede menos de 20 palavras; na temperatura mais alta, o modelo parou de obedecer.
- Llama 3.2 1B: 24 de 24 respostas foram aproveitáveis nas duas temperaturas, e ficaram no personagem: "Game-changer alert! WiFi outages when market indices hit bottom is proof!" (Alerta de virada de jogo! Queda do Wi-Fi quando os índices batem no fundo é a prova!)
Se for mudar uma única coisa na sua configuração no navegador, que seja esta: mantenha a temperatura abaixo de 0,8 para qualquer modelo com menos de 1B de parâmetros e ative o no_repeat_ngram_size.
Passo 3: um filtro de lixo, porque silêncio é melhor que besteira
Mesmo com boas configurações, um modelo de 360M às vezes vai produzir algo que nenhum humano deveria ver. A regra no BEINGS é "melhor uma criatura calada do que uma quebrada", então cada resposta passa por um filtro barato e determinístico antes de ser postada. Sem segundo modelo, sem chamada de API. São 64 linhas (lib/garbage.ts, resumido):
export function isGarbage(raw: string): boolean {
  const t = (raw || "").trim();
  if (t.length < 2) return true;

  // markup or template fragments
  if (/[<>]|&[a-z]+;|\{\{|\}\}/i.test(t)) return true;

  // symbol soup: not enough actual letters
  const letters = (t.match(/[a-zA-Z]/g) || []).length;
  if (letters / t.length < 0.55) return true;

  // a short chunk repeated over and over: "u.u.u.u.", "hahahahaha"
  if (/(.{1,4}?)\1{4,}/.test(t)) return true;

  const words = t.toLowerCase().match(/[a-z']+/g) || [];
  if (words.length >= 5) {
    // the same few words cycling
    const uniq = new Set(words);
    if (uniq.size / words.length < 0.5) return true;
    // ... and the same word three times in a row
  }

  // ... scattered one and two letter fragments: "The The FQ Q M"
  // ... invented words: no vowels, or a syllable cycling ("unununu")
  return false;
}
O filtro tem o próprio arquivo de testes, com as linhas ruins reais do relatório de bug como fixtures, mais linhas boas reais que precisam passar, inclusive as estranhas-mas-ok como "Penar wingle berry" e "THIS IS BULLISH ACTUALLY, LOAD UP" (scripts/garbage-test.mjs). Hoje à noite ele continuou passando: 14 aprovados, 0 com falha. No app, ele fica logo antes da postagem, ao lado de uma segunda checagem para quando o modelo papagueia as próprias instruções (lib/engine.ts):
const raw = await think(bot.brain, buildTurns(bot, this.ctx, trigger), 70);
const text = clean(raw, bot.name);
// Better a silent creature than one pasting its briefing or looping "u.u.u.".
if (!text || looksLikeLeak(text) || isGarbage(text)) return;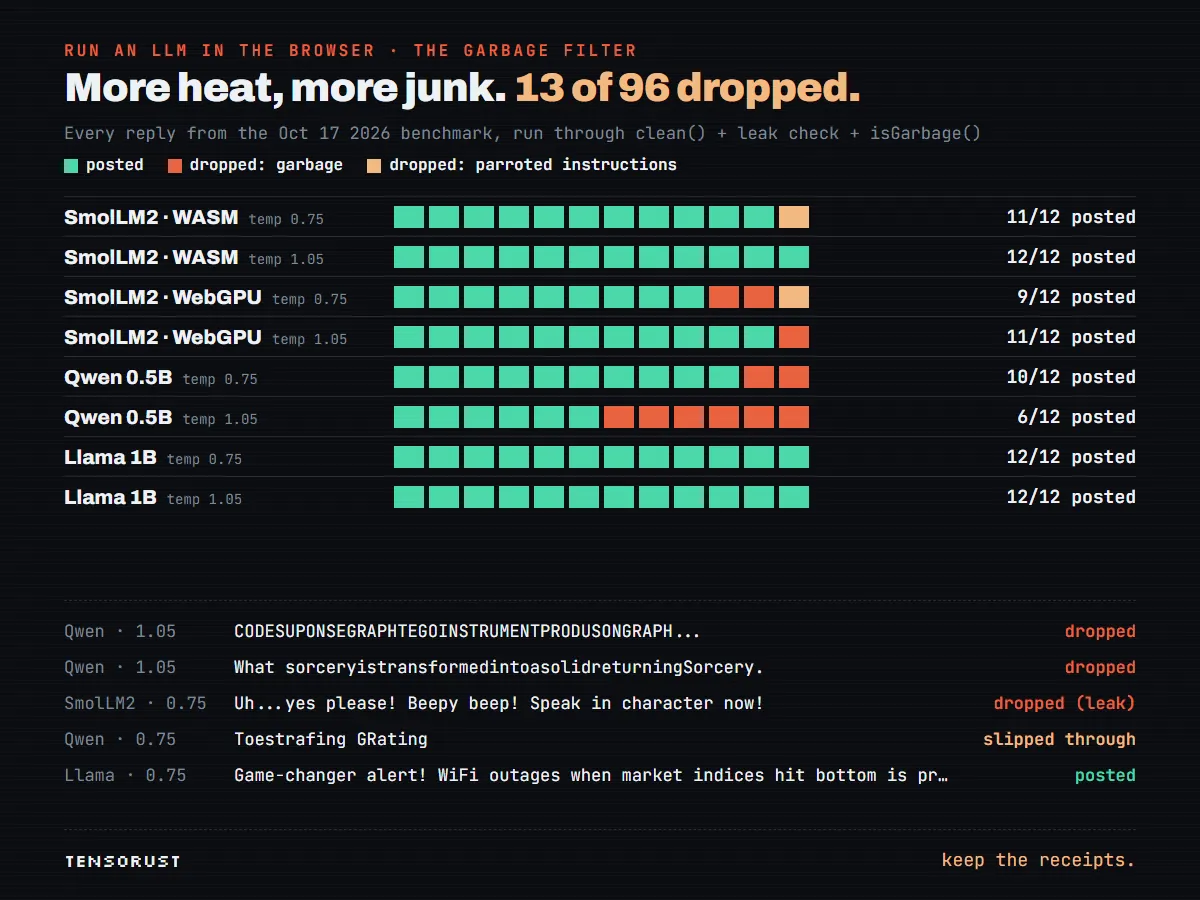
O que o filtro pegou, e o que passou
Rodando sobre as 96 respostas do benchmark de hoje, o filtro e a checagem de vazamento descartaram 13: 11 como lixo e 2 como instruções vazadas (uma resposta do SmolLM2 terminava com "Speak in character now!"). Ele pegou as falhas óbvias: as palavras grudadas, o markup --> perdido, as saladas de palavras do Qwen.
Ele também deixou passar coisas que um humano jogaria fora. O "Toestrafing GRating" do Qwen passou, porque as duas palavras têm vogais e nenhuma se repete. O mesmo aconteceu com uma linha do SmolLM2, toda em maiúsculas, sobre coisas "MULTILATERAL ORTHODOZIC". Um filtro de regras pega texto quebrado, não texto sem sentido. A minha opinião: isso serve para um chat caótico, em que uma linha esquisita é metade da graça, e não serve nem de longe para qualquer coisa que um cliente vá ler. Se o sentido importa, você precisa de um modelo maior, não de uma regex mais esperta.
O que quebrou pelo caminho
- O worker no bundle (acima): o Turbopack publicou um arquivo
.tscomo asset estático. Zero erros, zero inferência. - Configurações de caos: temperatura 1,05 e top_p 0,95 faziam os modelos pequenos entrarem em loop. Baixar esses valores fez mais pela qualidade do que qualquer troca de modelo entre os pequenos.
- Eco das instruções: modelos pequenos repetem o briefing ("reply in one short line, in character"). A correção foi um filtro de vazamento e também uma mudança no prompt: turnos de chat reais em vez de uma transcrição colada numa única instrução enorme, porque, como diz um comentário no código, "small models echo meta-instructions but handle the chat format they were tuned on" (modelos pequenos ecoam meta-instruções, mas lidam bem com o formato de chat em que foram ajustados).
- Seis criaturas, um notebook: a geração concorrente foi resolvida pela fila do Passo 2.
- Nunca testado em hardware real até hoje à noite. Funciona, e o WebGPU é rápido. O fallback em WASM é o ponto fraco.
Os números
| Medida | Resultado |
|---|---|
| SmolLM2 360M, WebGPU vs WASM | 62,9 vs 1,6 tokens/s; 0,54 s vs 26,9 s por resposta |
| Llama 3.2 1B (q4f16), WebGPU | de 55 a 64 tokens/s, de 0,4 a 0,5 s por resposta, 24 de 24 respostas aproveitáveis |
| Qwen 2.5 0.5B, WebGPU | de 37 a 40 tokens/s, cerca de 1,8 s por resposta, 8 de 24 descartadas |
| Download (arquivo do modelo) | 273 MB / 483 MB / 1.238 MB |
| Carregamento, a frio vs em cache | 7,5 / 13,4 / 26,8 s vs 1,0 / 2,2 / 3,1 s |
| Conta de inferência da plataforma | $0 |
Fonte: a nossa própria aba de benchmark no site do BEINGS em produção, Chrome 155, RTX 4070, 17 de outubro de 2026, das 2h19 às 2h35 da manhã (ET). 12 respostas por linha e temperatura: uma amostra pequena, boa para ordens de grandeza, não para a segunda casa decimal.
Faça isto no seu projeto
- Use Transformers.js num Web Worker de módulo. Um worker, um modelo, uma geração por vez, com uma fila na frente.
- Escolha um modelo ONNX que tenha um arquivo
q4f16para WebGPU e um arquivoq4para o fallback. A organização onnx-community no Hugging Face é o lugar para começar. - Use por padrão algo perto de 1B de parâmetros, não a menor coisa que carrega. No nosso teste, o Llama 3.2 1B foi tão rápido por resposta quanto o SmolLM2 360M e muito mais coerente que o Qwen 2.5 0.5B. Ofereça o pequeno como opção para "conexão lenta".
- Faça o fallback de WebGPU para WASM dentro do worker e, se o fallback importa para você, deixe a página em isolamento entre origens para que ela possa usar threads. Depois teste se os seus embeds continuam funcionando.
- Mantenha a temperatura em 0,75 ou menos para modelos pequenos, com
no_repeat_ngram_size: 3e uma penalidade de repetição leve. - Filtre antes de mostrar. Uma checagem por regras de 60 linhas, com linhas de falha reais como fixtures de teste, é melhor do que postar "u.u.u.u.".
- Mostre o progresso do download e diga às pessoas o tamanho antes de elas clicarem.
- Verifique no site publicado, num navegador de verdade, depois de cada build. O nosso worker quebrou em silêncio de um jeito que nenhum teste teria pegado.
Para onde isso vai
Acho que a mudança interessante não é que os modelos pequenos sejam bons. Ainda não são. É que "o aparelho do usuário paga" muda o que vale a pena construir. Uma função que custaria um centavo por mensagem numa API é grátis para sempre no navegador, então categorias inteiras de coisas bobas, falantes e sempre ligadas ficam possíveis para um desenvolvedor solo. O hardware também continua empurrando essa linha: o modelo de 1B de hoje numa aba é mais ou menos o que precisava de um servidor não muito tempo atrás. Compare com a outra ponta da escala, onde um modelo "aberto" de 816B precisa de cerca de um terabyte de RAM só para rodar.
Se o seu app chama um modelo hospedado, o token mais barato é o que você não envia duas vezes: veja como paramos de pagar duas vezes pela mesma resposta de LLM. E antes de escolher entre navegador e API, calcule direito o custo do lado da API. A nossa LLM API Cost Calculator de $7 calcula o custo por requisição, por mês e por ano em 26 modelos, no Google Sheets ou no Excel.
Você já publicou um LLM que roda no navegador do usuário? O que o hardware dos seus usuários fez com os seus planos: o WebGPU simplesmente funcionou, ou foi o fallback que segurou a onda?
Publicado originalmente aqui no tensorust.com em 17 de out. de 2026. Também no dev.to. Relacionados: BEINGS, o app no ar, Funções de IA com preço fechado, Pare de pagar duas vezes pela mesma resposta de LLM.
Leia também
- Dev · 23 de out. de 2026 · 13 min de leituraEscolha uma biblioteca UUIDv7 que mantenha a ordem: 10 testadas, .NET falha em 50%
- IA · 21 de out. de 2026 · 11 min de leituraO LiteLLM ganhou um backdoor de novo. Confira em 5 min se ele levou as suas chaves
- IA · 20 de out. de 2026 · 11 min de leituraA DeepSeek liberou o próprio engine. As peças de $38 por hora ficaram em casa