
A DeepSeek liberou sua engine. As peças de $38 por hora ficaram em casa
Leia o resumo completo
Resumo: Hoje, às 5h30 (ET), a DeepSeek anunciou o DeepInfer, a engine por trás da sua própria API, como "now fully open source" (agora totalmente open source). 1,5 milhão de pessoas viram esse post em cinco horas. O próprio README da DeepSeek lista três coisas de que um serviço de verdade precisa e que estão "not included in this release" (fora desta versão), e o próprio Q&A dela diz que cada GPU desse serviço fatura $38 por hora. Clonamos o repositório e medimos tudo hoje de manhã: 4 das 5 caixas do diagrama da própria DeepSeek que roteiam o tráfego ou guardam o cache estão faltando, só 6,82% do código bate com o vLLM, e os kernels da Huawei são 52% maiores que os da Nvidia.
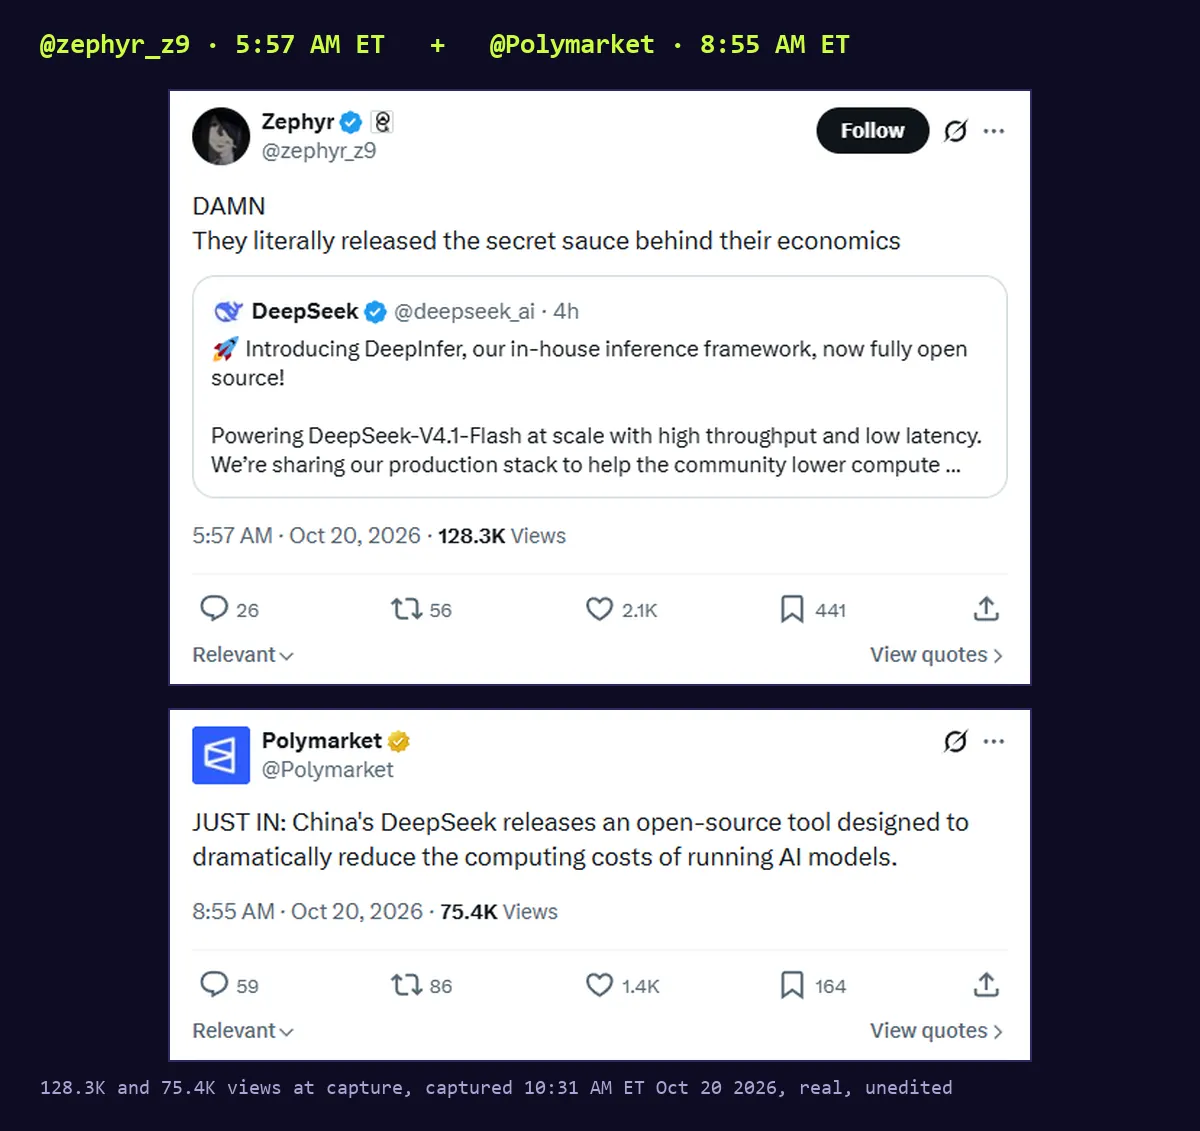
Então não, @zephyr_z9, eles não "literally release the secret sauce behind their economics" (liberaram literalmente o molho secreto da economia deles). Eles liberaram o forno. A receita que transforma GPUs em $38 por hora continua em Hangzhou. Ainda é o melhor presente que um laboratório de IA deu aos desenvolvedores este ano, e ainda não é o que o post diz que é.
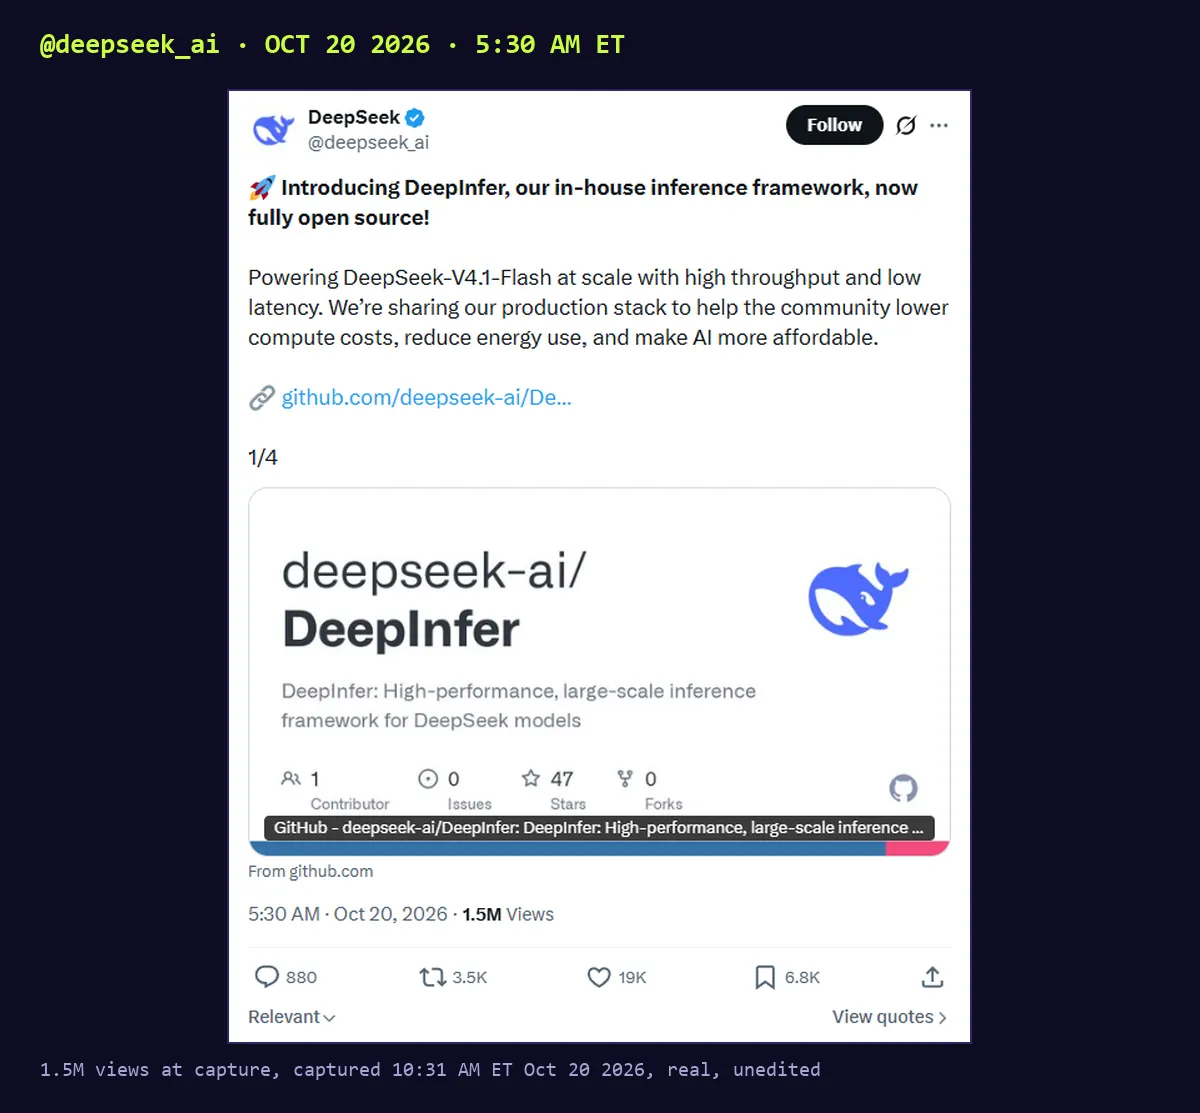
"Fully open source." O README deles discorda
Este é o post, da @deepseek_ai às 5h30 (ET). Às 10h31 ele tinha 1,5M de visualizações e 19 mil curtidas. O repositório chegou a 8.663 estrelas às 10h33, e a thread no Hacker News estava em 1º lugar, com 1.222 pontos e 437 comentários.
Agora abra o README. Abaixo de "Supported hardware" há uma lista com este título, palavra por palavra: "Required for a complete inference service (not included in this release)" (necessário para um serviço de inferência completo, fora desta versão):
- "A KV cache system" (um sistema de KV cache)
- "VE/Prefill/Decode disaggregation (most required engine functionality is already implemented)" (desagregação VE/Prefill/Decode, com a maior parte da funcionalidade necessária da engine já implementada)
- "Load balancing across data-parallel replicas for both prefill and decode" (balanceamento de carga entre réplicas de paralelismo de dados, tanto no prefill quanto no decode)
A primeira linha do README é igualmente honesta: "This open-source release provides offline inference." (esta versão open source oferece inferência offline). Não há servidor de API no repositório. Fizemos um grep: o único código HTTP é um endpoint de profiling que você liga com uma variável de ambiente. Você consegue rodar prompts pelo DeepInfer no seu próprio cluster. Não consegue apontar um cliente para ele.
Traduzindo o jargão. Prefill é o modelo lendo o seu prompt. Decode é o modelo escrevendo a resposta, um token de cada vez. KV cache são as anotações do modelo sobre um prompt que ele já leu, para não precisar ler de novo. Desagregação significa que prefill e decode rodam em máquinas separadas. Um load balancer (balanceador de carga) decide qual máquina recebe a sua requisição. Cada um desses itens é o que transforma uma engine num negócio.
Colocamos o próprio diagrama deles ao lado do repositório
A DeepSeek publicou um Q&A de deploy junto com a versão. Ele traz um diagrama de arquitetura de todo o sistema que serve o V4.1 Flash. Rotulamos cada caixa a partir da lista "not included" do README e de uma leitura do código.
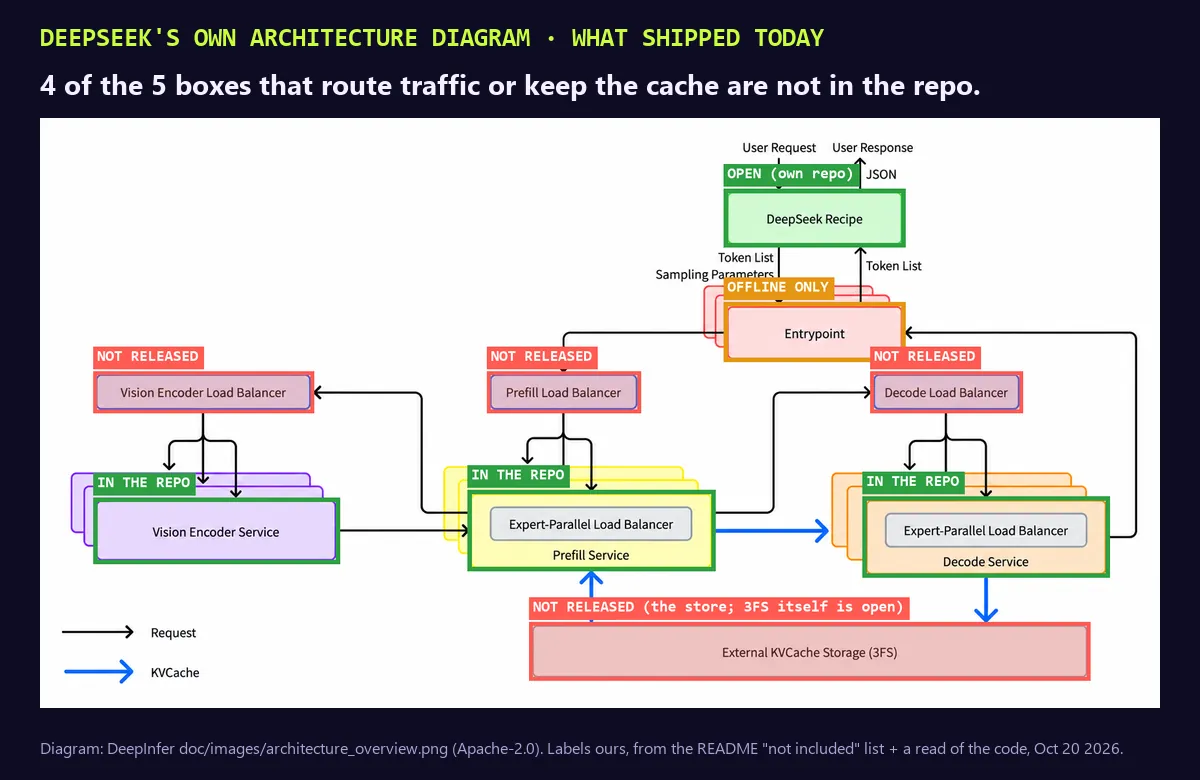
O Q&A cita cinco peças que roteiam o tráfego ou guardam o cache: um Prefill Load Balancer, um Decode Load Balancer, um Vision Encoder Load Balancer, um Expert-Parallel Load Balancer e o KVCache Storage. Só o de paralelismo de experts veio junto (está em deepinfer/model_executor/eplb/). Isso dá 1 de 5. O sistema de arquivos 3FS que fica embaixo do cache é aberto desde fevereiro de 2025. O componente que roda o cache em cima dele, que o Q&A chama de kvcache-store, não está no repositório.
E a DeepSeek explica o motivo, no Q&A, num parágrafo que a maioria das pessoas pulou:
"The KV cache management and load balancing components of the inference system are tightly coupled to our internal infrastructure, so that code is not yet fully open-sourced."
(Os componentes de gerenciamento do KV cache e de balanceamento de carga estão fortemente acoplados à nossa infraestrutura interna, então esse código ainda não foi totalmente aberto.) "Not yet fully open-sourced" e "now fully open source" são duas frases da DeepSeek, publicadas na mesma manhã. Só uma delas está no tweet.
O molho secreto é o cache, e eles mesmos disseram
É esta parte que torna erradas as opiniões de que "eles entregaram a economia deles". A DeepSeek listou três objetivos de projeto para o sistema. O terceiro: "Retain KV cache for more than 72 hours" (manter o KV cache por mais de 72 horas), para que um prompt repetido pule a etapa cara de leitura. É daí que vem a inferência barata: você não paga para ler a mesma base de código de 50 páginas duas vezes.
Veja quanto o Q&A diz que valem essas peças que faltam:
- 155 trilhões de tokens por dia passando por um único cluster.
- $38 de receita por hora de GPU, "at valley pricing" (o desconto de horário de baixa da DeepSeek, então provavelmente o piso).
- O balanceamento de carga os leva a cerca de 80% de um benchmark perfeitamente balanceado. Essa diferença entre uma caixa de GPUs e uma caixa de GPUs ocupada é o negócio.
- Armazenamento de cache dimensionado em 14,4 TB por GPU, em servidores com 20 SSDs de 30,73 TB cada, com erasure coding para que quaisquer 10 de 11 nós consigam responder.
Agora a comparação que ninguém fez nas respostas. O Google Cloud aluga uma B200, da mesma classe Blackwell do alvo "SM100" do DeepInfer, por $4,95 a hora no spot, $7,09 num contrato de 3 anos, $11,12 num contrato de 1 ano (preços atualizados hoje). O número da DeepSeek é de 3,4x a 7,7x o custo de alugar a GPU. Receita não é lucro, e a DeepSeek tem hardware próprio em vez de alugar, mas essa margem é a economia. E a margem mora nas 4 caixas que não estão no repositório.
Opinião polêmica, e a gente sustenta: o "dramatically reduce the computing costs of running AI models" da @Polymarket vale para talvez 50 empresas no planeta. Veja por quê.
Rodar como a DeepSeek começa em 128 GPUs
O Q&A é direto sobre o mínimo: "the smallest efficient deployment unit is 64 GPUs of prefill plus 64 GPUs of decode" (a menor unidade de deploy eficiente é de 64 GPUs de prefill mais 64 GPUs de decode). Os benchmarks do README foram "measured on 4 SM100 GPUs for prefill and 64 for decode" (medidos em 4 GPUs SM100 para prefill e 64 para decode). O decode pede EP64 ou mais (os experts do modelo espalhados por 64 a 128 GPUs). Então fizemos a conta.
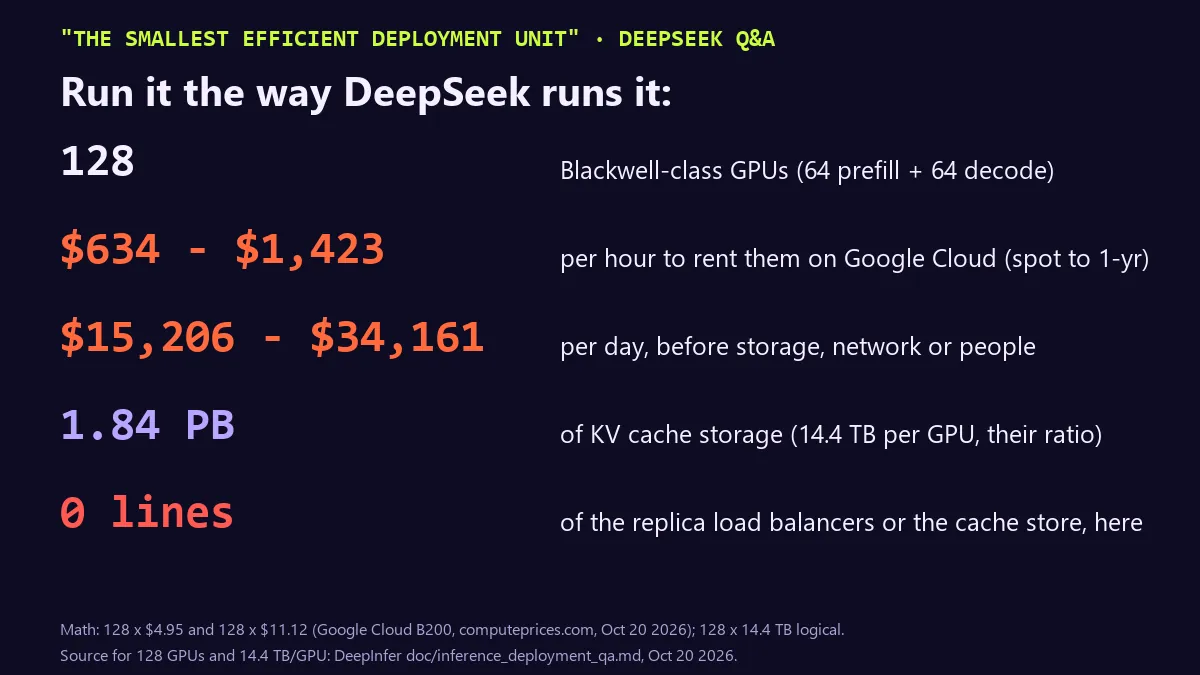
- 128 GPUs x $4,95 a $11,12 = $634 a $1.423 por hora.
- Isso dá $15.206 a $34.161 por dia, antes de armazenamento, rede ou de um único engenheiro.
- 1,84 PB de armazenamento de cache na proporção deles de 14,4 TB por GPU.
- Mais os load balancers e o armazenamento de cache que agora você mesmo tem que escrever.
Compare com a outra novidade da DeepSeek na timeline desta semana: o V4.1 Flash em 1 bit da Unsloth, de 508GB encolhido para 250GB, rodando numa máquina com 128GB+ de RAM. Esse é o modelo aberto que a maioria das pessoas vai de fato usar. O DeepInfer é para nuvens. Se você é dev indie, o verdadeiro presente da DeepSeek para você continua sendo a API barata, não este repositório.
O Q&A deles tem até a melhor frase de toda a versão. Dá para dividir prefill e decode entre data centers? Sim, "at some cost in reliability, e.g., the fiber running between data centers is easily severed by construction work" (com algum custo em confiabilidade, por exemplo, a fibra entre data centers é facilmente cortada por obras). Respeito. É um time que já teve a semana arruinada por uma retroescavadeira.
O vLLM diz "built primarily on vLLM". Nós medimos 6,82%
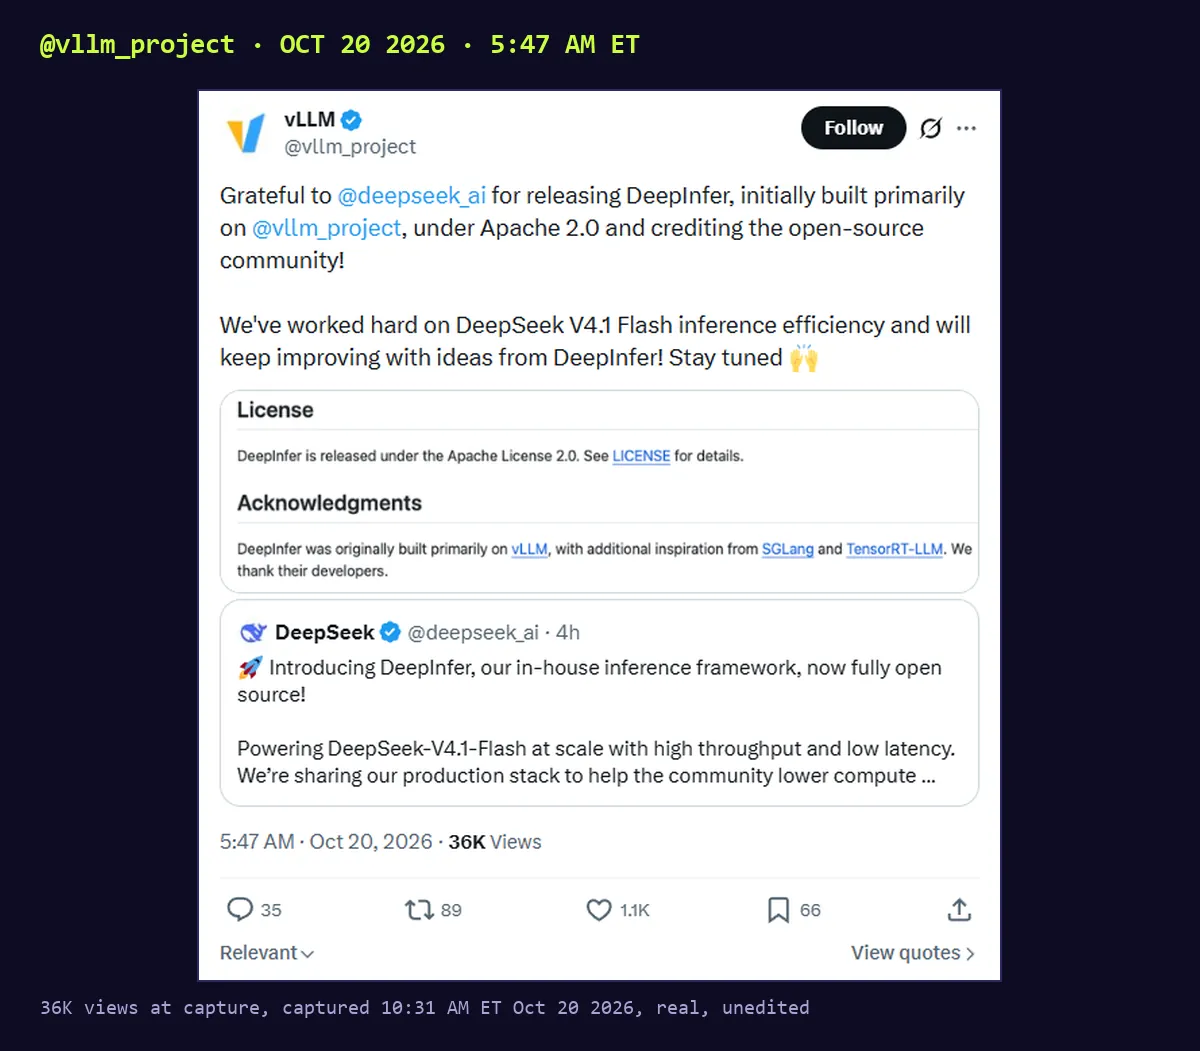
A outra grande reação veio do time do vLLM, a engine open source em que a maior parte da indústria roda. O post deles é elegante, e o README da DeepSeek de fato diz que o DeepInfer "was originally built primarily on vLLM" (foi originalmente construído principalmente sobre o vLLM).
Então medimos quanto do vLLM sobrou. Clonamos o DeepInfer (commit 774ce24) e o vLLM em nove versões, da v0.2.0 (2023) até o branch main de hoje. Pegamos cada linha Python com 25+ caracteres do pacote deepinfer/ do DeepInfer, descartamos comentários e linhas em branco, normalizamos os espaços e procuramos cada linha, com correspondência exata, em cada versão do vLLM. O script tem 60 linhas de Python, rodou em cerca de um minuto e não precisou de GPU.
def norm(l):
    l = l.strip()
    if not l or l.startswith('#'): return None
    if len(l) < 25: return None   # skip trivial lines
    return re.sub(r'\s+', ' ', l)

# every .py file in each vLLM tag, read straight out of git
p = subprocess.run(['git', '-C', VL, 'cat-file', '--batch'],
                   input='\n'.join(f'{ref}:{f}' for f in files).encode(),
                   capture_output=True)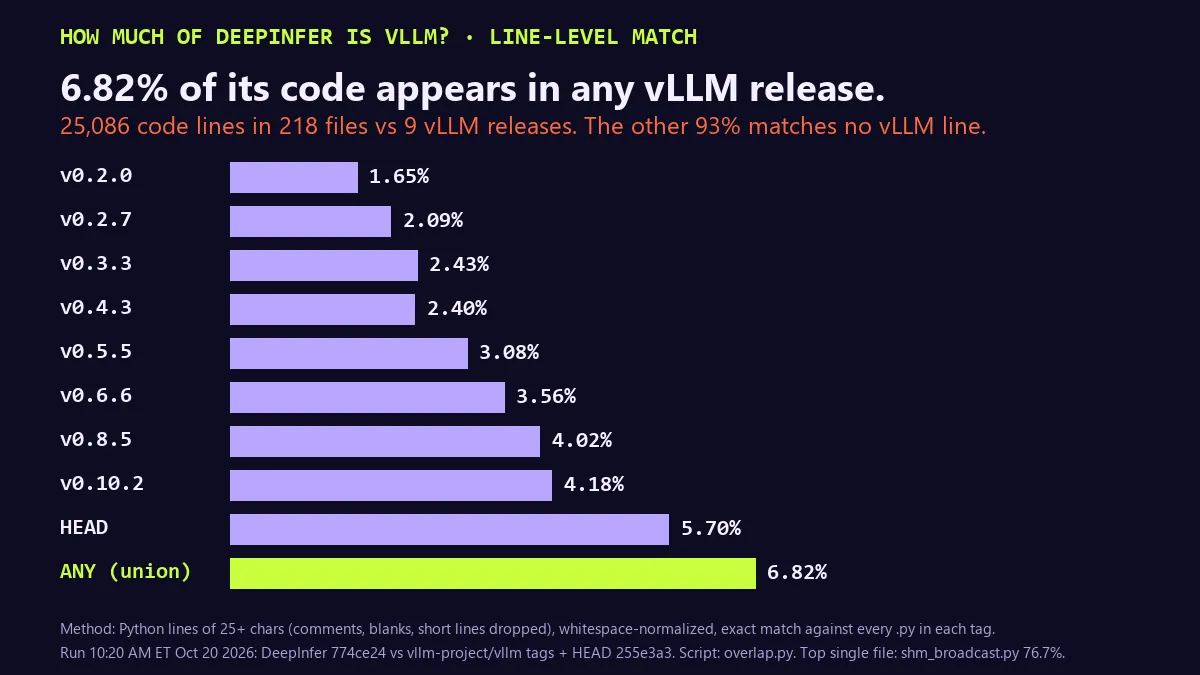
Resultado: 1.711 de 25.086 linhas (6,82%) aparecem em pelo menos uma versão do vLLM. A melhor versão isolada é o main de hoje do vLLM, com 5,70%, o que significa principalmente que os dois projetos adotaram as mesmas ideias novas. O arquivo com mais cara de vLLM é o shm_broadcast.py, uma fila de mensagens em memória compartilhada, com 76,7%. O núcleo da engine, llm_engine.py, tem 19,2%. O código do modelo V4 fica em torno de 5 a 12%.
A estrutura de pastas ainda diz vLLM: worker/cache_engine.py, sequence.py, model_runner.py. São os nomes que o vLLM usava lá em 2023. Mas o código dentro deles foi reescrito. Este método não pega variáveis renomeadas nem refatorações, então trate os 6,82% como o piso da semelhança de família, não como uma nota de plágio. A nossa leitura: dizer "construído sobre o vLLM" é como dizer que um arranha-céu foi construído sobre o estacionamento que existia ali antes. Verdade, e generoso, e a DeepSeek merece crédito real por escrever os outros 93%.
52% mais código para a Huawei do que para a Nvidia
Aqui está o que achamos que esta versão realmente significa. Os kernels próprios do DeepInfer (os pequenos programas de GPU que fazem as contas) ficam em tilelang_ops/, com um backend por chip. Os mesmos 30 kernels, duas versões de cada. Contamos as linhas que não estão em branco.
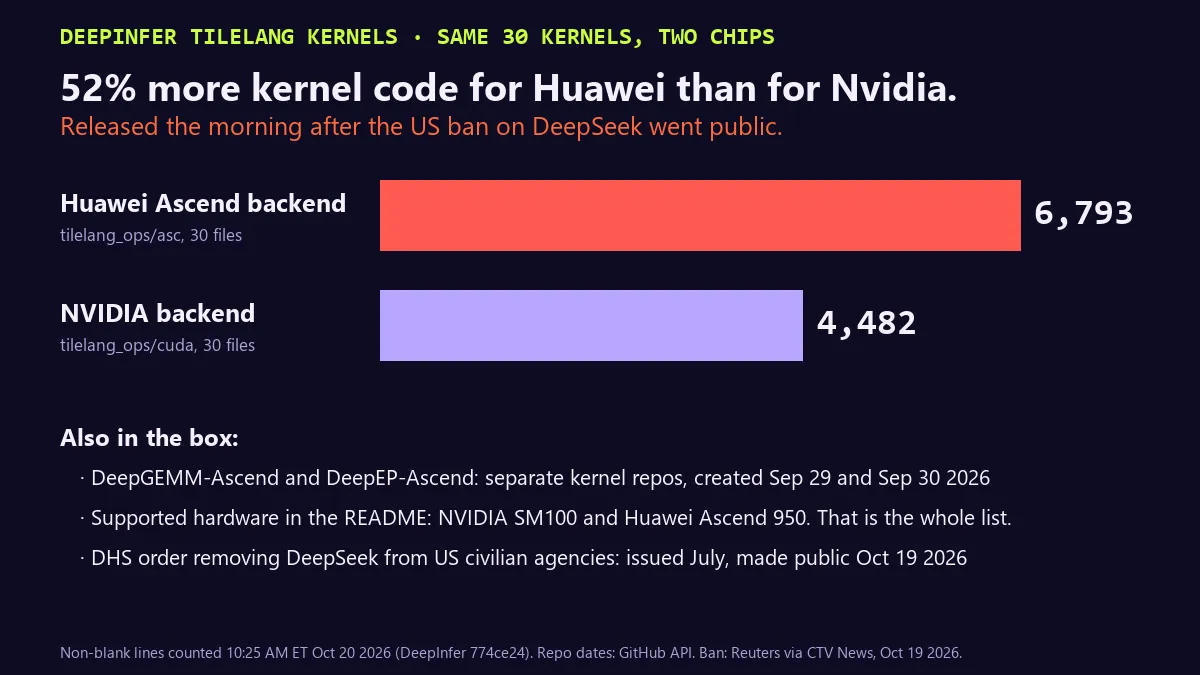
- Backend Huawei Ascend: 6.793 linhas. Backend NVIDIA: 4.482. Isso dá +51,6%.
- Hardware suportado no README: "NVIDIA SM100 GPUs" e "Huawei Ascend 950 NPUs". A lista é só essa. Nada de H100. Nada de AMD.
- As bibliotecas de kernels para Ascend saem em repositórios próprios, DeepGEMM-Ascend e DeepEP-Ascend, ambos criados em 29 e 30 de setembro de 2026, três semanas antes de hoje.
- Um dia antes da versão, a Reuters noticiou que o Departamento de Segurança Interna dos EUA (DHS) está mandando as agências federais civis removerem os produtos da DeepSeek e os serviços de terceiros construídos sobre os seus modelos (emitida em julho, tornada pública em 19 de out.).
- No mesmo dia, o The Information noticiou (via @unusual_whales, 149 mil visualizações) que a DeepSeek e a Huawei estão se unindo em novos projetos de chips de IA para desafiar a Nvidia.
Parte desses +52% é só o custo de um chip mais novo: kernels para Ascend pedem mais cuidado manual do que os de CUDA. Mas ninguém escreve 6.793 linhas para um chip sobre o qual não pretende vender o seu serviço. O que achamos que está acontecendo de verdade, e eles nunca vão dizer em voz alta: isto é uma apresentação de vendas da Huawei com licença Apache. Toda nuvem chinesa que quiser servir a DeepSeek aos preços da DeepSeek agora tem uma engine de nível de produção que roda em chips que os EUA não conseguem cortar. Os EUA banem a DeepSeek das suas agências na segunda-feira. Na terça, a DeepSeek deixa o próprio modelo mais barato para todo o resto do mundo servir, em silício da Huawei. Sendo bem sincero, o lançamento open source mais bem cronometrado do ano.
Mais uma prova para a pilha do "é um sistema de produção chinês, não uma demo": 1.147 de 40.638 linhas não vazias do pacote trazem comentários ou docstrings em chinês, como """compress 内核固定开启 fast math。""" ("o kernel compress sempre liga o fast math"). Ninguém escreveu isto para um post de lançamento. O histórico inteiro tem 3 commits: um "initial commit" com 345 arquivos e 63.326 linhas às 0h09 (ET), depois duas atualizações de documentação. Isto foi exportado de algum lugar privado hoje de manhã.
Ainda mais aberta que a OpenAI. Essa é a verdadeira alfinetada
Para ser justo com a DeepSeek, e injusto com todo o resto: a versão aberta da OpenAI foi o gpt-oss em agosto de 2025, pesos sob Apache 2.0 com código de referência. OpenAI, Anthropic e Google publicaram zero linhas dos sistemas que de fato servem o ChatGPT, o Claude ou o Gemini para quem paga. A DeepSeek acabou de publicar a engine, os kernels, o balanceador de experts, um serviço de tokenização escrito majoritariamente em Rust (deepseek-recipe), o layout de armazenamento, a receita por hora de GPU e o tráfego.
Então escolha o seu vilão. É o laboratório que entrega 93% de uma engine de produção e chama de 100%, ou os laboratórios que entregam 0% e se dizem os mocinhos?
O ranking das opiniões de hoje
- A mais errada: @zephyr_z9, "They literally released the secret sauce behind their economics" (128 mil visualizações). O molho é um cache de 72 horas e quatro load balancers. Nenhum dos dois veio junto.
- A mais errada para a maioria dos leitores: @Polymarket, "dramatically reduce the computing costs of running AI models" (75 mil). Para quem tem 128 Blackwells e um petabyte de SSD, claro.
- A mais generosa: @vllm_project, "initially built primarily on vLLM". 6,82% hoje. Fique com o crédito pela fundação; o prédio é da DeepSeek.
- A mais precisa: o próprio README da DeepSeek. Alguém daquele time escreveu "not included in this release" com todas as letras. O post de marketing não leu.
Os números até agora
- Caixas da camada de roteamento/cache da DeepSeek que vieram junto: 1 de 5 (EPLB), lido às 10h25 (ET) de 20 de out.
- Linhas do DeepInfer encontradas em alguma das 9 versões do vLLM: 1.711 de 25.086 (6,82%)
- Linhas de kernel, Huawei Ascend vs NVIDIA: 6.793 vs 4.482 (+51,6%)
- Receita da DeepSeek por hora de GPU: $38 (Q&A deles) vs $4,95 a $11,12 para alugar uma B200 no Google Cloud
- Menor deploy eficiente: 128 GPUs, $634 a $1.423 por hora
- Estrelas: 8.663 às 10h33 (ET), cerca de 10 horas depois do primeiro commit
A nossa aposta, e a sua vez
Previsão: até 30 de novembro, o vLLM e o SGLang incorporam a maior parte dos truques do DeepInfer (o decoding com draft tokens, o replay de SWA limitado) e as nuvens americanas servem o V4.1 Flash mais rápido do que hoje. E até 31 de dezembro, ninguém fora da China roda o modelo do jeito que a DeepSeek roda, com o cache de 72 horas e os quatro balanceadores, porque a DeepSeek ficou com eles. Se estivermos errados, mostre o cluster e escrevemos a correção com o seu nome na manchete.
Sua vez: "fully open source" é justo para uma versão com a qual você não consegue servir uma única requisição de API? Sim ou não, e diga por quê nas respostas. @deepseek_ai, fique à vontade para responder também.
Quer ver quanto o V4.1 Flash custa para você via API em comparação com alugar as GPUs por conta própria? A LLM API Cost Calculator ($7, Google Sheets + Excel, 26 modelos) faz a conta por requisição numa planilha só. A versão grátis está no site em tensorust.com/tools/llm-api-cost/.
Relacionados em tensorust.com: A Meta abriu um modelo de 816B. Rodá-lo exige cerca de 1TB de RAM, Benchmark de proxy de LLM: 200 chamadas duplicadas viraram 1 e A estatística de 60% do Theo é um gráfico de quedas.
Método e dados: DeepInfer clonado em 774ce24 (20 de out. de 2026), tags do vllm-project/vllm v0.2.0, v0.2.7, v0.3.3, v0.4.3, v0.5.5, v0.6.6, v0.8.5, v0.10.2 e main em 255e3a3. Todas as contagens feitas entre 10h20 e 10h35 (ET) de 20 de out. de 2026. Prints do X capturados às 10h31 (ET), reais e sem edição. Preços de GPU da página da B200 no Google Cloud do computeprices.com, atualizada em 20 de out. de 2026.
Publicado primeiro aqui em tensorust.com em 20 de out. de 2026. Também no X (@TensorustAI), no X (@MattBusel) e no dev.to. Relacionados: Calculadora grátis de custo de API de LLM, O modelo de 816B da Meta precisa de 1TB de RAM, Benchmark de proxy de LLM.
Mais: o autor, leituras relacionadas, compartilhar, um jogo grátis
Leia a seguir
Ferramenta grátis: calculadora de custo de API de LLM → Tokens de entrada, tokens de saída, requisições por dia: custo mensal em 24 modelos GPT, Claude e Gemini.
- IA · 21 de out. de 2026 · 11 min de leituraO LiteLLM ganhou um backdoor de novo. Veja em 5 min se ele levou suas chaves
- IA · 19 de out. de 2026 · 13 min de leituraA estatística de 60% do Theo é um gráfico de quedas: 43 horas de incidentes do Codex
- IA · 18 de out. de 2026 · 13 min de leituraBackoff exponencial com jitter: 64 de 100 chamadas de LLM ainda falharam