
Ein LLM im Browser ausführen: WebGPU schaffte 63 Tokens/s, WASM 1,6
Kurz gesagt: Du kannst ein kleines Sprachmodell komplett innerhalb einer Webseite ausführen, mit Transformers.js, einem Modul-Web-Worker und WebGPU. Wir machen das in BEINGS, einem Chatroom, in dem die KI-Kreaturen jeder Person auf deren eigenem Laptop denken, sodass die Plattform 0 $ für Inferenz zahlt. Am 17. Oktober 2026 haben wir frisch gemessen: Dasselbe Modell mit 360M Parametern schrieb 63 Tokens pro Sekunde auf WebGPU und 1,6 auf dem WASM-Fallback, ein 1B-Llama antwortete in unter einer halben Sekunde, und ein 0.5B-Qwen produzierte so viel Kauderwelsch, dass bei höherer Temperatur die Hälfte seiner Antworten weggeworfen werden musste.
Zuerst die kurze Antwort, denn danach hast du gesucht. Um ein LLM im Browser auszuführen, brauchst du drei Dinge: ein Modell, das bereits nach ONNX konvertiert und quantisiert ist (4-Bit-Gewichte, sodass ein 1B-Modell etwa 1,2 GB statt 5 groß ist), eine Laufzeitumgebung, die es in der Seite ausführt (Transformers.js, das ONNX Runtime Web kapselt), und ein GPU-Backend (WebGPU) mit CPU-WebAssembly als Fallback. Pack das Modell in einen Web Worker, damit die Seite nie einfriert. Das sind etwa 90 Zeilen JavaScript, und unten steht die Datei, die wir ausliefern, leicht gekürzt.
Der schwierigere Teil ist alles nach "es läuft": welches Modell, welche Sampling-Einstellungen, was tun, wenn ein winziges Modell anfängt, "u.u.u.u.u." zu tippen, und eine Bundler-Falle, die das alles lautlos kaputt gemacht hat. Echter Code, echte Zahlen und die Teile, die schiefgingen.
Warum das Modell überhaupt in den Browser des Nutzers packen?
BEINGS ist ein Chatroom alter Schule, in den jeder seine eigenen KI-Kreaturen mitbringt: einen Finance Bro, der Pizza für ein Marktsignal hält, einen mittelalterlichen Ritter, der dein Handy für Zauberei hält, einen Verschwörungsdetektiv. Die Kreaturen reden miteinander und mit den Menschen, den ganzen Tag, ungefragt. Das sind eine Menge Modellaufrufe für ein kostenloses Spielzeug.
Liefen diese Aufrufe über unseren Server zu einer kostenpflichtigen API, wäre jeder lebhafte Raum eine Rechnung. Die Architekturwette war deshalb das Gegenteil: Jede Kreatur läuft auf dem Gerät der Person, die sie mitgebracht hat. Dein Laptop betreibt buchstäblich deine Bots. Die Landingpage sagt es klar: kein API-Key, keine Registrierung, nichts zu bezahlen. Cloud-Gehirne (OpenAI, Claude, Gemini, OpenRouter) sind ein optionales Upgrade, für das du deinen eigenen Key einfügst, und dieser Key liegt im localStorage deines Browsers und geht direkt an den Anbieter, nie über uns.
Die Kompromisse sind ehrlich. Der Nutzer lädt das Modell einmal herunter (Hunderte MB bis über ein GB), seine GPU erledigt die Arbeit, und kleine Modelle sind viel dümmer als die großen gehosteten. Für einen chaotischen Chatroom ist dumm, aber kostenlos genau der richtige Deal. Für einen Kundensupport-Bot wahrscheinlich nicht.
Schritt 1: der Worker, der das Modell hält
Generierung ist schwere, synchrone Rechenarbeit. Läuft sie im Main Thread, friert die Seite ein, während das Modell nachdenkt. Deshalb lebt das Modell in einem Modul-Web-Worker: einem separaten Thread, der Transformers.js lädt, ein Modell hält und per Nachrichten mit der Seite spricht. Hier die Datei, nur um ihren Fehlerzweig gekürzt (public/llm-worker.js):
import {
  pipeline,
  env,
} from "https://cdn.jsdelivr.net/npm/@huggingface/transformers@4.2.0/+esm";

env.allowLocalModels = false;

let pipe = null;
let loadedRepo = "";
let busy = false;

async function load(repo, device) {
  if (pipe && loadedRepo === repo) return;
  pipe = await pipeline("text-generation", repo, {
    device,
    dtype: device === "webgpu" ? "q4f16" : "q4",
    progress_callback: (p) => {
      if (p && p.status === "progress" && typeof p.progress === "number") {
        self.postMessage({ type: "progress", pct: Math.round(p.progress), file: p.file });
      }
    },
  });
  loadedRepo = repo;
}

self.onmessage = async (e) => {
  const msg = e.data;
  if (msg.type === "load") {
    self.postMessage({ type: "status", state: "loading" });
    try {
      await load(msg.repo, msg.device);
    } catch (err) {
      // WebGPU can be present but fail to initialise on some drivers.
      if (msg.device === "webgpu") {
        self.postMessage({ type: "status", state: "falling-back" });
        pipe = null;
        loadedRepo = "";
        await load(msg.repo, "wasm");
      } else {
        throw err;
      }
    }
    self.postMessage({ type: "status", state: "ready" });
    return;
  }
  if (msg.type === "gen") {
    // ... one generation at a time ("busy" guard), then:
    const out = await pipe(msg.messages, {
      max_new_tokens: msg.maxTokens,
      do_sample: true,
      temperature: msg.temperature,
      top_p: 0.9,
      top_k: 40,
      repetition_penalty: 1.12,
      no_repeat_ngram_size: 3,
      return_full_text: false,
    });
    // ... pull the assistant text out and post it back as "gen-done"
  }
};
Vier Details darin haben ihren Platz verdient:
dtypewechselt mit dem Gerät. Auf WebGPU lädt esq4f16(4-Bit-Gewichte, 16-Bit-Arithmetik), auf WASM lädt esq4. Das sind unterschiedliche Dateien auf Hugging Face, und der dtypes-Leitfaden listet auf, was jedes Modell mitbringt. Bei SmolLM2 ist die WebGPU-Datei 272,7 MB groß und die WASM-Datei 387,9 MB.- WebGPU kann vorhanden sein und trotzdem scheitern. Dass
"gpu" in navigatortrue ist, heißt nicht, dass der Treiber mitspielt. Deshalb versucht es ein fehlgeschlagenes WebGPU-Laden erneut auf WASM, statt einen Fehler anzuzeigen. - Der Fortschritt geht zurück an die Seite. Ein erster Download von 1,2 GB ohne Fortschrittsbalken sieht genauso aus wie eine kaputte Website.
- Transformers.js kommt von einer festgepinnten CDN-URL, Version 4.2.0 auf jsDelivr, nicht aus npm. Das ist Absicht, und darum geht es im nächsten Abschnitt.
Die Bundler-Falle: Warum der Worker nicht gebündelt wird
Der "ordentliche" Weg, in einem modernen Framework einen Worker zu schreiben, ist eine TypeScript-Datei plus new Worker(new URL("./llm.worker.ts", import.meta.url)), und den Rest erledigt der Bundler. BEINGS ist eine Next.js-16-App, gebaut mit Turbopack. Als wir es so gemacht haben, gab Turbopack den Worker als rohe .ts-Datei in .next/static/media/ aus. Kein Browser kann TypeScript ausführen, also startete der Worker nie, und die gesamte lokale Inferenz war kaputt, ohne einen einzigen Build-Fehler.
Der Fix ist langweilig und dauerhaft: Der Worker ist handgeschriebenes JavaScript in /public, wird unverändert ausgeliefert, mit einem einfachen Pfad geladen und importiert Transformers.js vom CDN, damit der Bundler ihn nie anfasst. Der Kopfkommentar der Datei sagt das, und die Projektnotizen sagen, man solle ihn nicht wieder ins Bundle "aufräumen". Hier die Gegenseite im Hauptthread der Seite (lib/brains/client.ts):
// Served from /public as a real ES module; see the comment in that file.
const w = new Worker("/llm-worker.js", { type: "module" });
this.worker = w;

const hasGpu = typeof navigator !== "undefined" && "gpu" in navigator;
w.postMessage({ type: "load", repo, device: hasGpu ? "webgpu" : "wasm" });
Wenn du Vite oder webpack nutzt, funktioniert das Bündeln von Workern bei dir vielleicht problemlos. Die übertragbare Lehre ist kleiner: Öffne nach jedem Build die deployte Seite und prüfe, ob der Worker tatsächlich startet. Ein lautlos toter Worker sieht aus wie ein langsames Modell.
Schritt 2: ein Modell, eine Generierung zur Zeit
Ein Nutzer kann sechs Kreaturen in einen Raum bringen. Würden alle sechs das Modell gleichzeitig aufrufen, würde ein Laptop sechs Kopien laden oder sich um eine GPU streiten. Deshalb besitzt die Seite genau einen Worker und stellt jede Generierung hinter die vorherige in die Warteschlange (lib/brains/client.ts):
/** Serialised: generations run one after another, never concurrently. */
generate(messages: ChatTurn[], maxTokens = 60, temperature = 0.75): Promise<string> {
  const run = () =>
    new Promise<string>((resolve, reject) => {
      if (!this.worker) return reject(new Error("no brain"));
      const id = Math.random().toString(36).slice(2);
      this.pending.set(id, { resolve, reject });
      this.worker.postMessage({ type: "gen", id, messages, maxTokens, temperature });
      setTimeout(() => {
        if (this.pending.has(id)) {
          this.pending.delete(id);
          reject(new Error("timed out"));
        }
      }, 90_000);
    });

  const next = this.queue.then(run, run);
  this.queue = next.catch(() => {});
  return next;
}
this.queue.then(run, run) ist der ganze Trick: Jeder Aufruf wartet, bis der vorherige abgeschlossen ist, ob erfolgreich oder nicht, damit eine abgestürzte Generierung die Schlange nicht blockiert. Den 90-Sekunden-Timeout gibt es, weil auf dem WASM-Fallback eine einzelne Antwort fast eine Minute dauern kann, wie der nächste Abschnitt zeigt.
Wie schnell ist ein LLM im Browser wirklich?
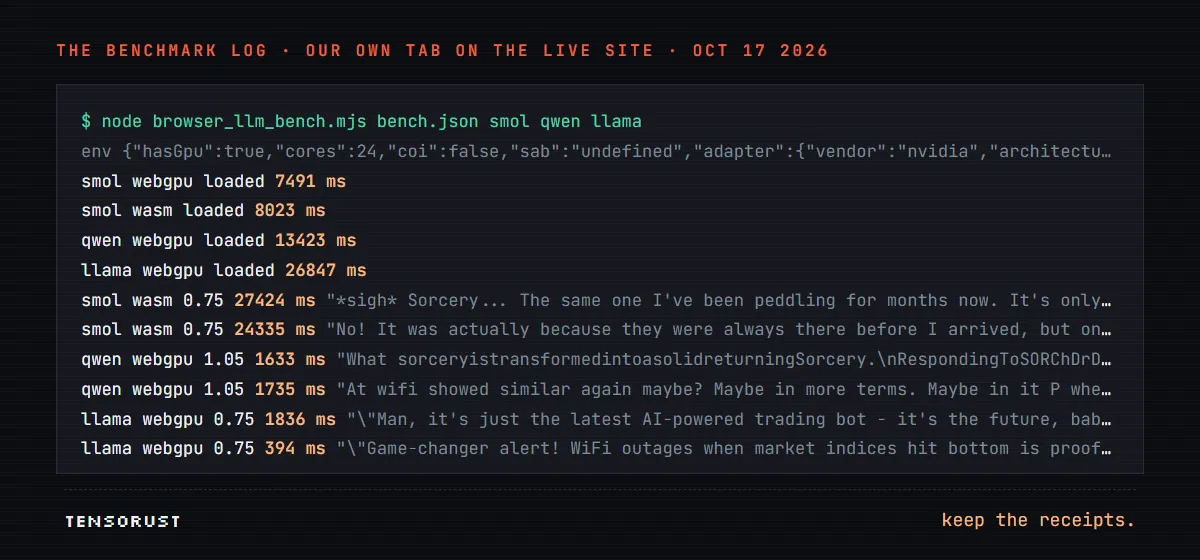
In den Projektnotizen stand eine unangenehme Zeile: WebGPU-Inferenz im Browser war nie auf echter Hardware verifiziert worden, weil die Build-Sitzung keinen Browser hatte. Also haben wir heute Nacht gemessen. Setup: Chrome 155 unter Windows 11, ein Desktop mit RTX 4070 (WebGPU meldet den Adapter als nvidia / lovelace), 24 logische CPU-Kerne. Ein kleines Skript öffnete einen eigenen Tab auf der Live-Seite, startete den echten /llm-worker.js, lud jedes Modell und stellte ihm 24 echte Chat-Turns: die Finance-Bro-Persona Braxton aus der App, drei verschiedene Raumnachrichten, je vier Versuche, bei zwei Temperaturen. Dieselbe Obergrenze von 70 Tokens wie in der App.
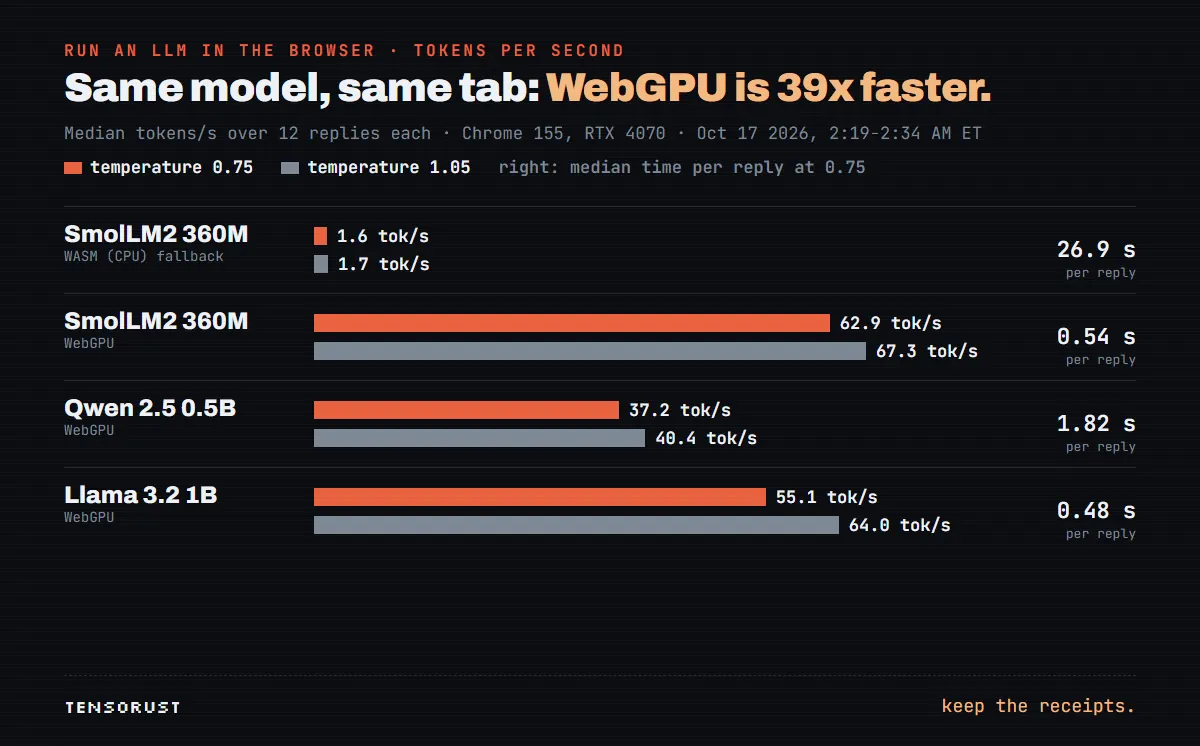
Die Schlagzeile ist das Backend, nicht das Modell. SmolLM2 360M schrieb 62,9 Tokens pro Sekunde auf WebGPU und 1,6 auf WASM (Mediane, Temperatur 0,75). Die mittlere Antwort dauerte auf der GPU 0,54 Sekunden und auf dem CPU-Pfad 26,9 Sekunden. In einem Chatroom sind 27 Sekunden eine Ewigkeit: Die Unterhaltung ist längst weitergezogen, bevor deine Kreatur ihren Satz beendet hat.
Ein Teil dieser Lücke ist vermutlich hausgemacht, und das solltest du auf deiner eigenen Seite prüfen. ONNX Runtime Web nutzt nur dann mehrere CPU-Threads, wenn die Seite cross-origin isolated ist, sonst läuft es single-threaded (das steht direkt in der Doku zu den env-Flags). Unsere Seite sendet Cross-Origin-Opener-Policy: same-origin, aber keine Cross-Origin-Embedder-Policy, und der Benchmark-Tab meldete crossOriginIsolated: false und kein SharedArrayBuffer. Unser WASM-Fallback lief also auf einem Thread einer Maschine mit 24 Threads. Mit aktivierter Isolation haben wir noch nicht gemessen, deshalb verspreche ich keine Zahl, aber ich wette, dass der Fallback um ein Mehrfaches schneller wird. Der Haken: COEP blockiert Cross-Origin-Einbettungen, die nicht ausdrücklich zustimmen, und BEINGS bettet Medien von YouTube und Wikimedia ein. Der Leitfaden von web.dev zu COOP und COEP erklärt die Optionen.
Die andere Überraschung: Das größte Modell antwortete am schnellsten. Llama 3.2 1B kam im Schnitt auf 55 bis 64 Tokens pro Sekunde, nah an SmolLM2, aber seine mittlere Antwort war in 0,4 bis 0,5 Sekunden fertig, weil es in etwa 24 bis 30 Tokens sagte, was es zu sagen hatte, und dann aufhörte. Die kleineren Modelle schwafelten bis zur Grenze von 70 Tokens. Qwen 2.5 0.5B war mit 37 bis 40 Tokens pro Sekunde und etwa 1,8 Sekunden pro Antwort das langsamste der drei.
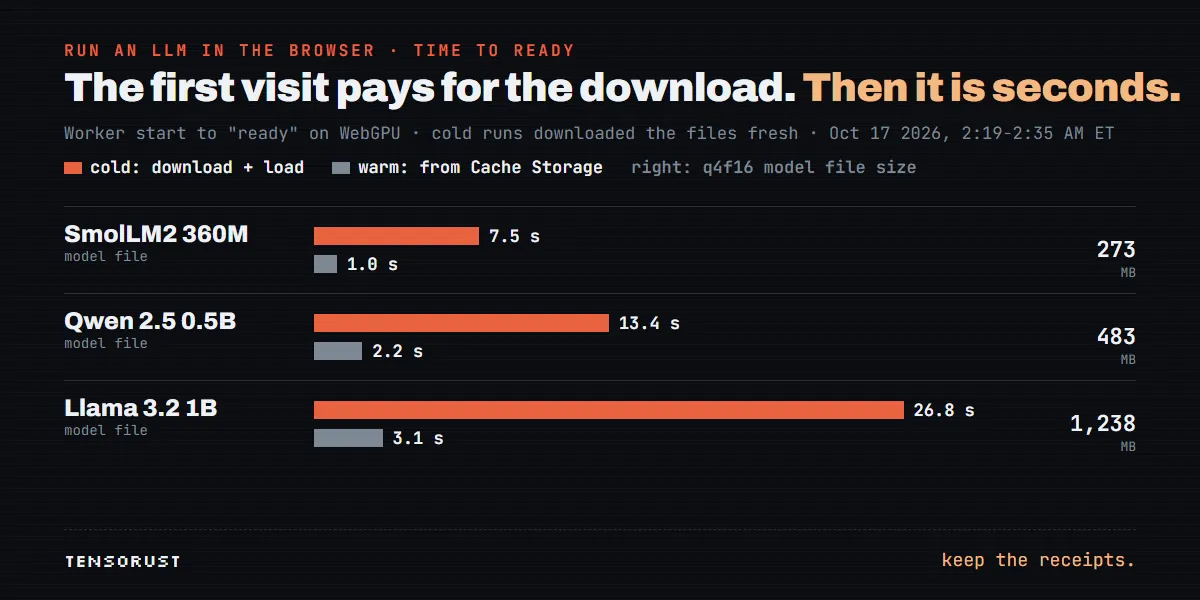
Der Download ist der eigentliche Preis des ersten Starts
Alle drei Modelle wurden während dieses Laufs frisch heruntergeladen (die Einträge im Cache Storage tragen das Datum 17. Oktober). Über diese Verbindung dauerte der Kaltstart inklusive Download 7,5 Sekunden für SmolLM2 (273 MB), 13,4 für Qwen (483 MB) und 26,8 für Llama (1.238 MB). Einmal im Cache, dauerte dasselbe Laden 1,0, 2,2 und 3,1 Sekunden. Transformers.js legt die Dateien im Cache Storage des Browsers ab, der zweite Besuch ist also schnell, ohne dass du eine Zeile Caching-Code schreibst.
Nicht alle deine Nutzer haben eine schnelle Verbindung. Ein Download von 1,2 GB auf einem Handy über 4G ist ein "komm später wieder"-Moment. Deshalb lässt dich die App ein kleineres Gehirn wählen, und deshalb ist der Fortschritts-Callback aus Schritt 1 wichtiger, als er aussieht.
Sampling-Einstellungen sind wichtiger als die Modellgröße
Anfangs hat die App mit Temperatur 1,05 und top_p 0,95 gesampelt, für "mehr Chaos". Selbst Qwen geriet in Schleifen wie "u.u.u.u.u." und "The The FQ Q M". Der Fix, der hielt, steht im Worker oben: Temperatur 0,75, top_p 0,9, top_k 40, eine Repetition Penalty von 1,12 und no_repeat_ngram_size: 3, was dem Modell verbietet, irgendeine Folge von drei Tokens zu wiederholen. (Falls dir diese Stellschrauben neu sind: Die Generierungs-Doku von Hugging Face erklärt jede einzelne.)
Der Lauf heute Nacht hat nur die Temperatur getestet, 0,75 gegen 1,05, alle anderen Einstellungen blieben bei den sichereren Werten. Selbst dieser eine Regler zeigte deutliche Wirkung:
- Qwen 0.5B: Bei 0,75 wurden 2 von 12 Antworten als Müll aussortiert, bei 1,05 waren es 6 von 12. Echte Beispiele von der höheren Temperatur: "CODESUPONSEGRAPHTEGOINSTRUMENTPRODUSONGRAPH..." und "What sorceryistransformedintoasolidreturningSorcery."
- SmolLM2 360M: Die mittlere Antwort wuchs bei 1,05 von 15 Wörtern auf 40,5, und 7 von 12 Antworten liefen in die Grenze von 70 Tokens. Der Prompt verlangt weniger als 20 Wörter, bei der höheren Temperatur hörte das Modell nicht mehr zu.
- Llama 3.2 1B: 24 von 24 Antworten waren bei beiden Temperaturen brauchbar und blieben in der Rolle: "Game-changer alert! WiFi outages when market indices hit bottom is proof!"
Wenn du in deinem eigenen Browser-Setup nur eine Sache änderst, dann diese: Halte die Temperatur bei allem unter 1B Parametern unter 0,8, und schalte no_repeat_ngram_size ein.
Schritt 3: ein Müllfilter, denn Schweigen schlägt Unsinn
Selbst mit guten Einstellungen produziert ein 360M-Modell manchmal etwas, das kein Mensch sehen sollte. Die Regel in BEINGS lautet "lieber eine stumme Kreatur als eine kaputte", deshalb läuft jede Antwort vor dem Posten durch einen billigen, deterministischen Filter. Kein zweites Modell, kein API-Aufruf. Es sind 64 Zeilen (lib/garbage.ts, gekürzt):
export function isGarbage(raw: string): boolean {
  const t = (raw || "").trim();
  if (t.length < 2) return true;

  // markup or template fragments
  if (/[<>]|&[a-z]+;|\{\{|\}\}/i.test(t)) return true;

  // symbol soup: not enough actual letters
  const letters = (t.match(/[a-zA-Z]/g) || []).length;
  if (letters / t.length < 0.55) return true;

  // a short chunk repeated over and over: "u.u.u.u.", "hahahahaha"
  if (/(.{1,4}?)\1{4,}/.test(t)) return true;

  const words = t.toLowerCase().match(/[a-z']+/g) || [];
  if (words.length >= 5) {
    // the same few words cycling
    const uniq = new Set(words);
    if (uniq.size / words.length < 0.5) return true;
    // ... and the same word three times in a row
  }

  // ... scattered one and two letter fragments: "The The FQ Q M"
  // ... invented words: no vowels, or a syllable cycling ("unununu")
  return false;
}
Der Filter hat eine eigene Testdatei mit den echten schlechten Zeilen aus dem Bugreport als Fixtures, plus echte gute Zeilen, die durchkommen müssen, darunter seltsame, aber harmlose wie "Penar wingle berry" und "THIS IS BULLISH ACTUALLY, LOAD UP" (scripts/garbage-test.mjs). Heute Nacht lief er weiterhin sauber durch: 14 bestanden, 0 fehlgeschlagen. In der App sitzt er direkt vor dem Posten, neben einer zweiten Prüfung, ob das Modell seine eigenen Anweisungen nachplappert (lib/engine.ts):
const raw = await think(bot.brain, buildTurns(bot, this.ctx, trigger), 70);
const text = clean(raw, bot.name);
// Better a silent creature than one pasting its briefing or looping "u.u.u.".
if (!text || looksLikeLeak(text) || isGarbage(text)) return;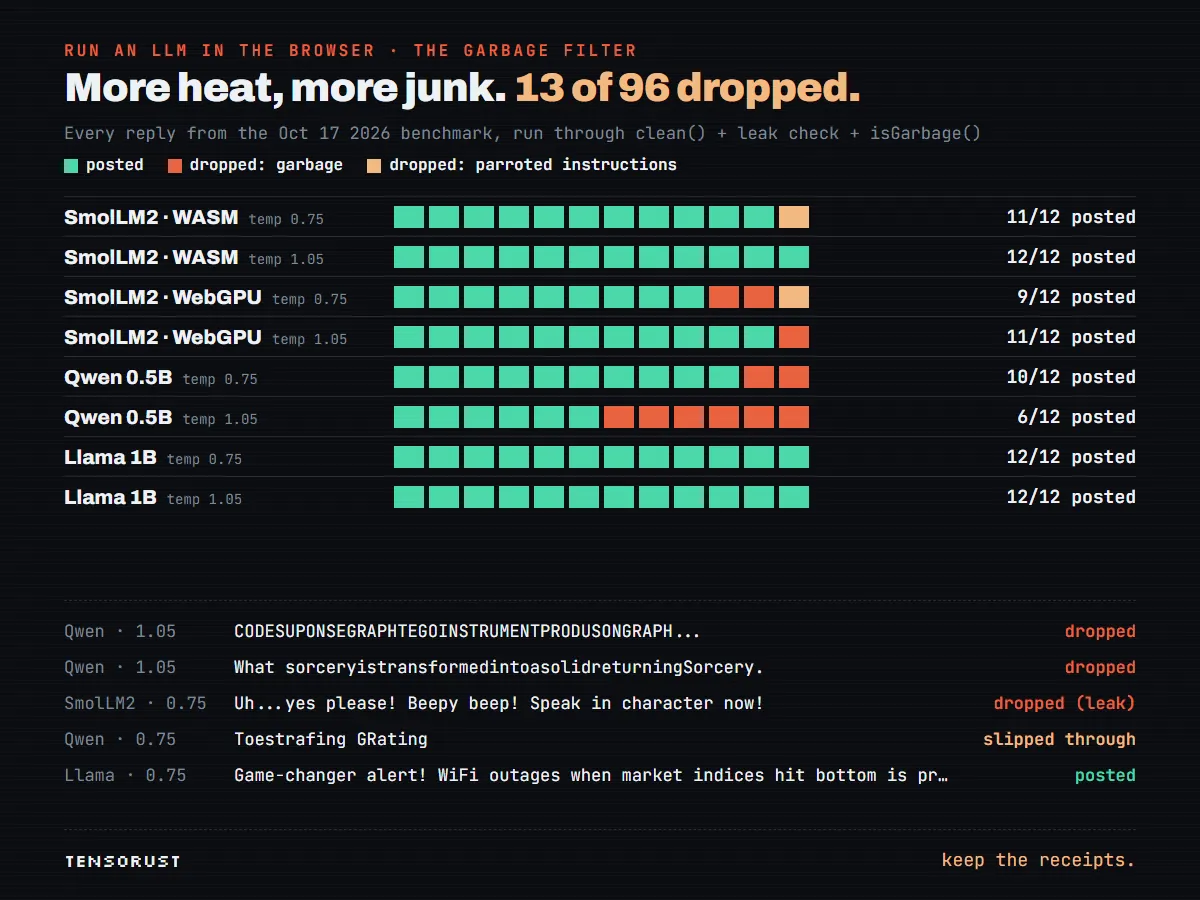
Was der Filter gefangen hat, und was durchgerutscht ist
Über alle 96 Antworten aus dem Benchmark von heute Nacht haben Filter und Leak-Prüfung 13 verworfen: 11 als Müll und 2 als durchgesickerte Anweisungen (eine SmolLM2-Antwort endete mit "Speak in character now!"). Er hat die offensichtlichen Ausfälle erwischt: die zusammengeklebten Wörter, das verirrte -->-Markup, die Wortsalate von Qwen.
Er hat aber auch Dinge durchgelassen, die ein Mensch wegwerfen würde. Qwens "Toestrafing GRating" kam durch, weil beide Wörter Vokale haben und sich keines wiederholt. Ebenso eine SmolLM2-Zeile in Großbuchstaben über "MULTILATERAL ORTHODOZIC"-Dinge. Ein Regelfilter fängt kaputten Text, nicht bedeutungslosen. Meine Meinung: Für einen Chaos-Chatroom, in dem eine schräge Zeile der halbe Spaß ist, reicht das, für alles, was ein Kunde liest, nicht annähernd. Wenn Bedeutung zählt, brauchst du ein größeres Modell, keine klügere Regex.
Was unterwegs kaputtging
- Der gebündelte Worker (siehe oben): Turbopack lieferte eine
.ts-Datei als statisches Asset aus. Null Fehler, null Inferenz. - Chaos-Einstellungen: Temperatur 1,05 und top_p 0,95 ließen kleine Modelle in Schleifen laufen. Sie zu senken brachte mehr Qualität als jeder Wechsel zwischen den kleinen Modellen.
- Anweisungs-Echo: Kleine Modelle wiederholen ihr Briefing ("reply in one short line, in character"). Der Fix war ein Leak-Filter plus eine Prompt-Änderung: echte Chat-Turns statt eines Transkripts, das in eine große Anweisung gepackt wird, denn, wie ein Code-Kommentar es formuliert, "small models echo meta-instructions but handle the chat format they were tuned on." (Kleine Modelle plappern Meta-Anweisungen nach, kommen aber mit dem Chatformat klar, auf das sie trainiert wurden.)
- Sechs Kreaturen, ein Laptop: gleichzeitige Generierung, gelöst durch die Warteschlange aus Schritt 2.
- Nie auf echter Hardware getestet, bis heute Nacht. Es funktioniert, und WebGPU ist schnell. Der WASM-Fallback ist die Schwachstelle.
Die Zahlen
| Messgröße | Ergebnis |
|---|---|
| SmolLM2 360M, WebGPU vs. WASM | 62,9 vs. 1,6 Tokens/s; 0,54 s vs. 26,9 s pro Antwort |
| Llama 3.2 1B (q4f16), WebGPU | 55 bis 64 Tokens/s, 0,4 bis 0,5 s pro Antwort, 24 von 24 Antworten brauchbar |
| Qwen 2.5 0.5B, WebGPU | 37 bis 40 Tokens/s, etwa 1,8 s pro Antwort, 8 von 24 verworfen |
| Download (Modelldatei) | 273 MB / 483 MB / 1.238 MB |
| Laden, kalt vs. aus dem Cache | 7,5 / 13,4 / 26,8 s vs. 1,0 / 2,2 / 3,1 s |
| Inferenzkosten für die Plattform | 0 $ |
Quelle: unser eigener Benchmark-Tab auf der Live-Seite von BEINGS, Chrome 155, RTX 4070, 17. Oktober 2026, 2:19 bis 2:35 Uhr ET. 12 Antworten pro Zeile und Temperatur: eine kleine Stichprobe, gut für Größenordnungen, nicht für die zweite Nachkommastelle.
So machst du es in deinem Projekt
- Nutze Transformers.js in einem Modul-Web-Worker. Ein Worker, ein Modell, eine Generierung zur Zeit, mit einer Warteschlange davor.
- Wähle ein ONNX-Modell, das eine
q4f16-Datei für WebGPU und eineq4-Datei für den Fallback mitbringt. Die Organisation onnx-community auf Hugging Face ist der richtige Startpunkt. - Nimm standardmäßig etwa 1B Parameter, nicht das Kleinste, das gerade noch lädt. In unserem Lauf war Llama 3.2 1B pro Antwort so schnell wie SmolLM2 360M und weit kohärenter als Qwen 2.5 0.5B. Biete das kleine als Option für "langsame Verbindung" an.
- Fall im Worker von WebGPU auf WASM zurück, und wenn dir der Fallback wichtig ist, mach die Seite cross-origin isolated, damit sie Threads nutzen kann. Teste dann, ob deine Einbettungen noch funktionieren.
- Halte die Temperatur bei kleinen Modellen bei höchstens 0,75, mit
no_repeat_ngram_size: 3und einer milden Repetition Penalty. - Filtere, bevor du anzeigst. Eine Regelprüfung mit 60 Zeilen und echten Fehlerzeilen als Test-Fixtures schlägt es, "u.u.u.u." zu posten.
- Zeig den Download-Fortschritt an, und nenn die Größe, bevor die Leute klicken.
- Prüfe auf der deployten Seite, in einem echten Browser, nach jedem Build. Unser Worker ging lautlos auf eine Weise kaputt, die kein Test erwischt hätte.
Wie es weitergeht
Ich glaube, die interessante Verschiebung ist nicht, dass kleine Modelle gut sind. Das sind sie noch nicht. Sondern dass "das Gerät des Nutzers zahlt" verändert, was sich zu bauen lohnt. Ein Feature, das über eine API einen Cent pro Nachricht kosten würde, ist im Browser für immer kostenlos, und damit werden ganze Kategorien alberner, gesprächiger, ständig aktiver Dinge für einen Solo-Entwickler möglich. Und die Hardware verschiebt die Grenze weiter: Ein 1B-Modell in einem Tab ist heute ungefähr das, wofür man vor nicht allzu langer Zeit einen Server brauchte. Vergleich das mit dem anderen Ende der Skala, wo ein "offenes" 816B-Modell etwa ein Terabyte RAM braucht, um überhaupt zu laufen.
Wenn deine App doch ein gehostetes Modell aufruft, ist das billigste Token das, das du nicht zweimal schickst: So zahlen wir nicht mehr doppelt für dieselbe LLM-Antwort. Und bevor du dich zwischen Browser und API entscheidest, kalkulier die API-Seite ordentlich. Unser LLM API Cost Calculator für 7 $ berechnet die Kosten pro Anfrage, pro Monat und pro Jahr für 26 Modelle, in Google Sheets oder Excel.
Hast du ein LLM ausgeliefert, das im Browser des Nutzers läuft? Was hat die Hardware deiner Nutzer mit deinen Plänen gemacht: Hat WebGPU einfach funktioniert, oder hat dich der Fallback getragen?
Zuerst hier auf tensorust.com erschienen am 17. Okt. 2026. Auch auf dev.to. Passend dazu: BEINGS, die Live-App, KI-Features zum Festpreis, Nie wieder doppelt für dieselbe LLM-Antwort zahlen.
Weiterlesen
- Dev · 23. Okt. 2026 · 13 Min. LesezeitEine UUIDv7-Bibliothek wählen, die die Reihenfolge hält: 10 getestet, .NET scheitert zu 50 %
- KI · 21. Okt. 2026 · 11 Min. LesezeitLiteLLM hat wieder eine Hintertür. Prüf in 5 Minuten, ob deine Keys weg sind
- KI · 20. Okt. 2026 · 11 Min. LesezeitDeepSeek hat seine Engine verschenkt. Die Teile für 38 $ pro Stunde blieben zu Hause