
DeepSeek hat seine Engine verschenkt. Die Teile für 38 $ pro Stunde blieben zu Hause
Die ganze Kurzfassung lesen
Kurz gesagt: Heute um 5:30 Uhr ET erklärte DeepSeek DeepInfer, die Engine hinter seiner eigenen API, für "now fully open source". 1,5 Millionen Menschen sahen diesen Post innerhalb von fünf Stunden. DeepSeeks eigene README nennt drei Dinge, die ein echter Dienst braucht und die "not included in this release" sind, und das eigene Q&A sagt, dass jede GPU in diesem Dienst 38 $ pro Stunde einbringt. Ich habe das Repo heute Morgen geklont und nachgemessen: 4 der 5 Kästen in DeepSeeks eigenem Diagramm, die Traffic verteilen oder den Cache halten, fehlen, nur 6,82 % des Codes stimmen mit vLLM überein, und die Huawei-Kernels sind 52 % größer als die für Nvidia.
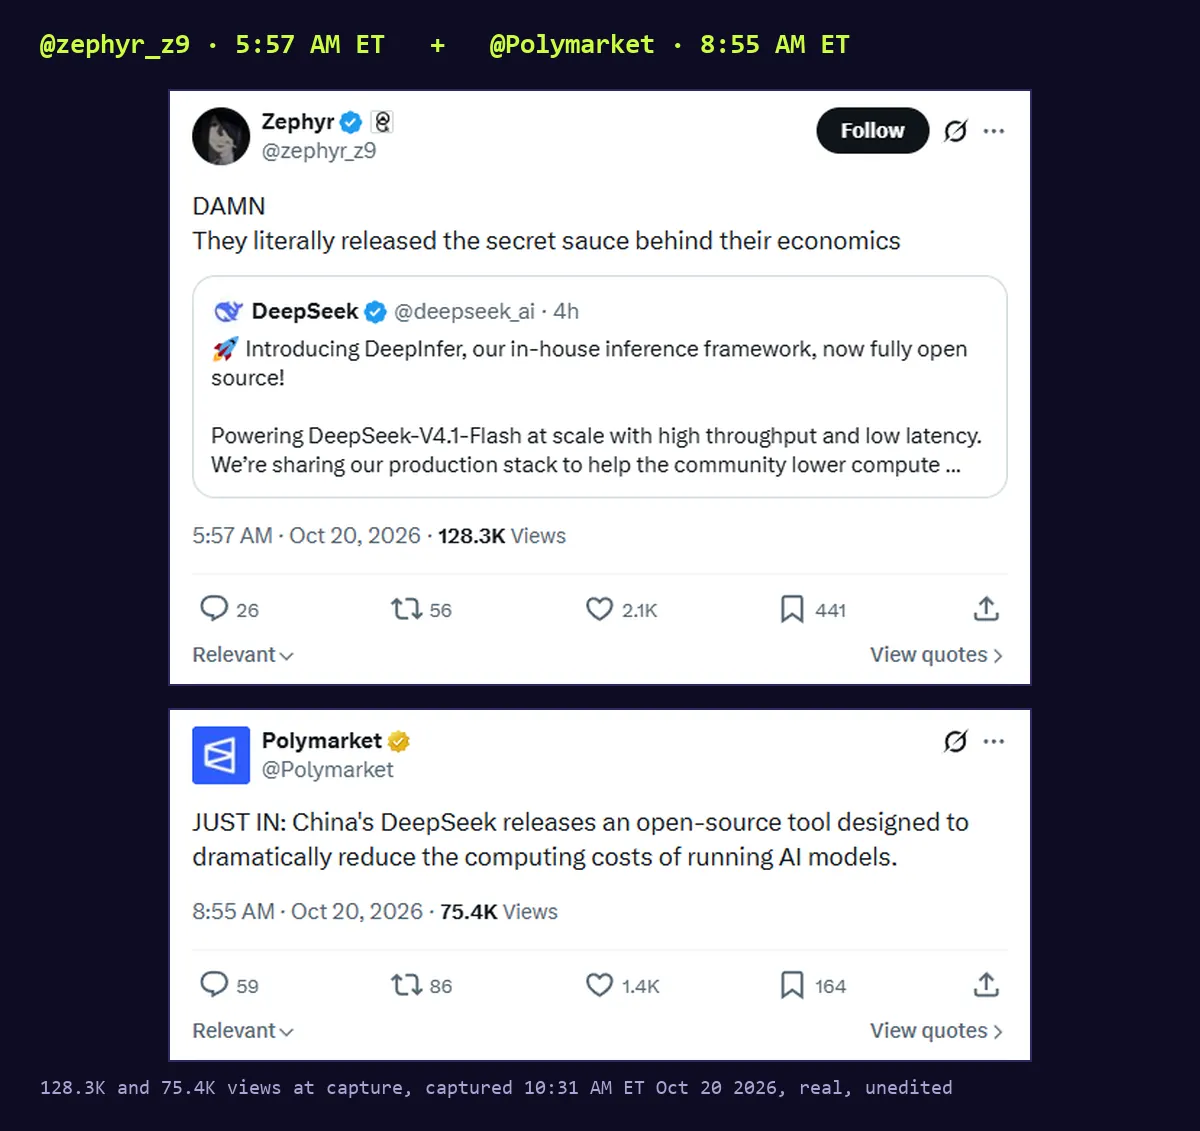
Also nein, @zephyr_z9, sie haben nicht "literally released the secret sauce behind their economics". Sie haben den Ofen veröffentlicht. Das Rezept, das aus GPUs 38 $ pro Stunde macht, liegt weiter in Hangzhou. Es ist trotzdem das beste Geschenk, das ein KI-Labor Entwicklern dieses Jahr gemacht hat, und es ist trotzdem nicht das, was der Post behauptet.
"Fully open source." Ihre README sieht das anders
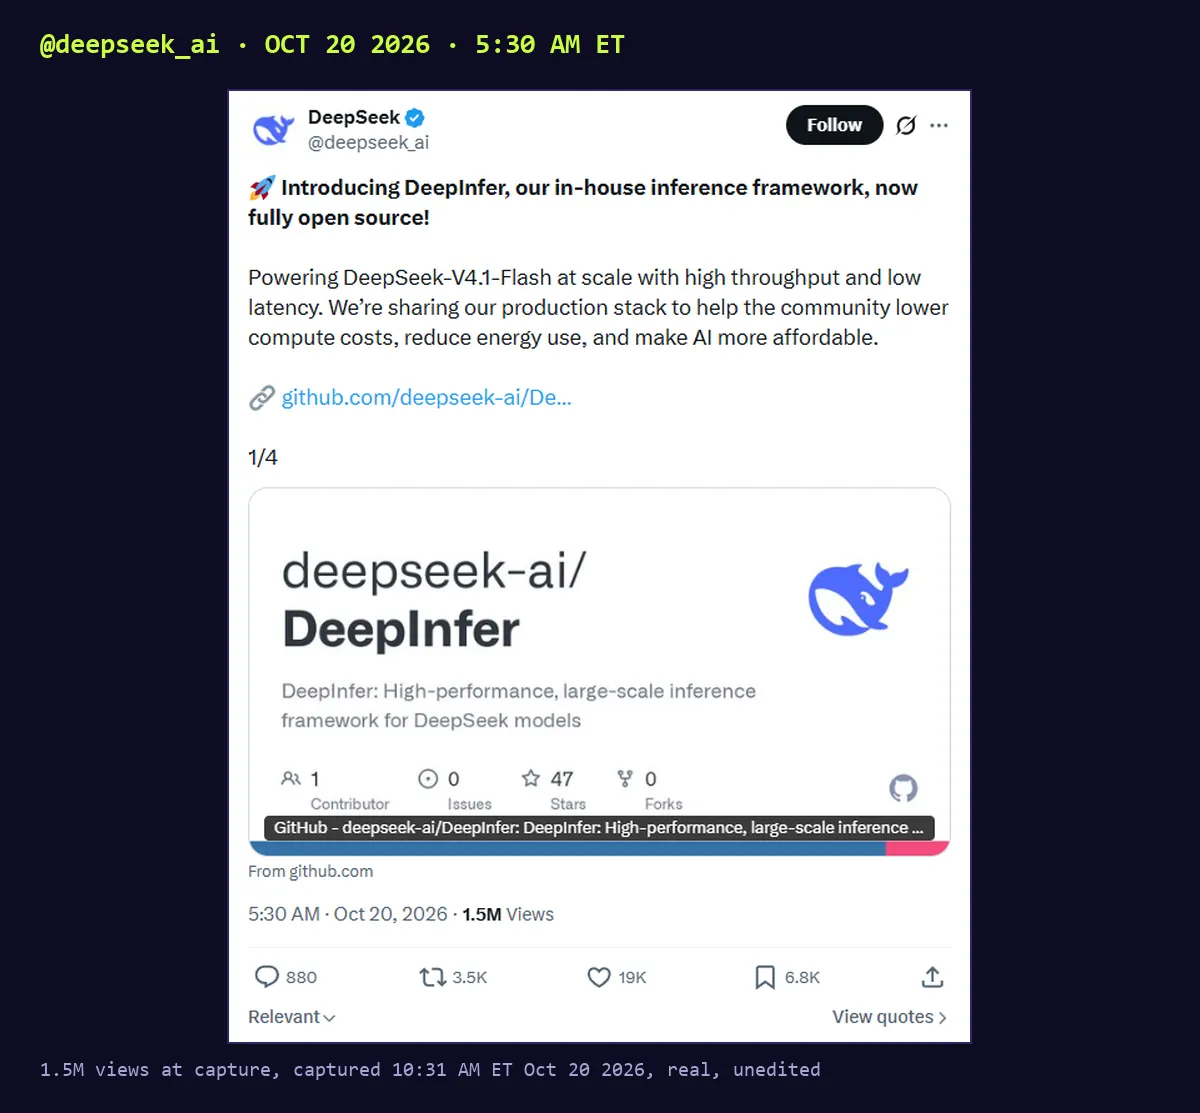
Hier ist der Post, von @deepseek_ai um 5:30 Uhr ET. Um 10:31 Uhr hatte er 1,5 Mio. Aufrufe und 19K Likes. Das Repo erreichte um 10:33 Uhr 8.663 Sterne, und der Hacker-News-Thread stand auf Platz 1 mit 1.222 Punkten und 437 Kommentaren.
Jetzt öffne die README. Unter "Supported hardware" steht eine Liste mit genau dieser Überschrift: "Required for a complete inference service (not included in this release)" (für einen vollständigen Inferenzdienst nötig, in diesem Release nicht enthalten):
- "A KV cache system"
- "VE/Prefill/Decode disaggregation (most required engine functionality is already implemented)"
- "Load balancing across data-parallel replicas for both prefill and decode"
Die erste Zeile der README ist genauso ehrlich: "This open-source release provides offline inference." Im Repo gibt es keinen API-Server. Ich habe es durchsucht: Der einzige HTTP-Code ist ein Profiling-Endpunkt, den man über eine Umgebungsvariable einschaltet. Du kannst Prompts auf deinem eigenen Cluster durch DeepInfer schicken. Einen Kunden kannst du nicht darauf loslassen.
Der Fachjargon auf Deutsch. Prefill ist das Modell, das deinen Prompt liest. Decode ist das Modell, das die Antwort schreibt, ein Token nach dem anderen. Der KV-Cache sind die Notizen des Modells zu einem Prompt, den es schon gelesen hat, damit es ihn nicht noch einmal lesen muss. Disaggregation heißt, dass Prefill und Decode auf getrennten Maschinen laufen. Ein Load Balancer entscheidet, welche Maschine deine Anfrage bekommt. Genau diese Teile machen aus einer Engine ein Geschäft.
Ich habe ihr eigenes Diagramm neben das Repo gelegt
DeepSeek hat mit dem Release ein Deployment-Q&A veröffentlicht. Darin steckt ein Architekturdiagramm des gesamten Serving-Systems für V4.1 Flash. Ich habe jeden Kasten anhand der "not included"-Liste der README und einer Durchsicht des Codes beschriftet.
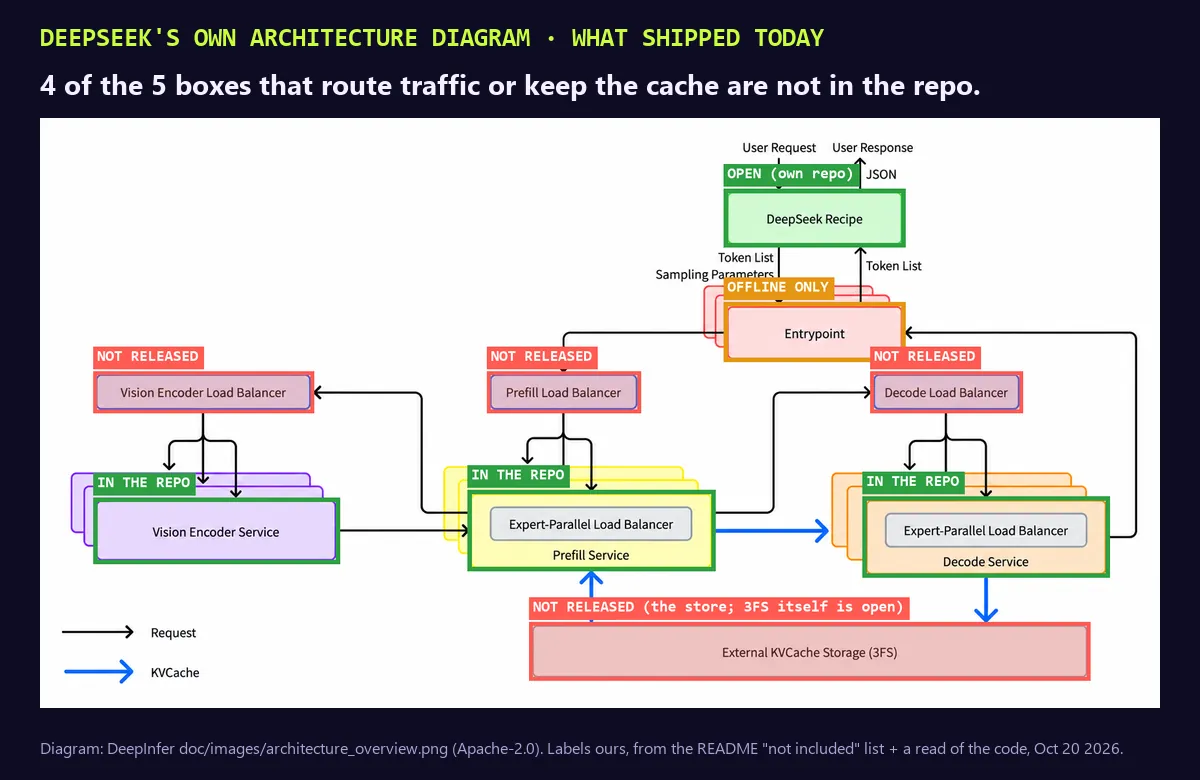
Das Q&A nennt fünf Teile, die Traffic verteilen oder den Cache halten: einen Prefill Load Balancer, einen Decode Load Balancer, einen Vision Encoder Load Balancer, einen Expert-Parallel Load Balancer und KVCache Storage. Nur der Expert-Parallel-Balancer ist dabei (er liegt in deepinfer/model_executor/eplb/). Das ist 1 von 5. Das Dateisystem 3FS unter dem Cache ist seit Februar 2025 offen. Die Komponente, die den Cache darauf betreibt und im Q&A kvcache-store heißt, ist nicht im Repo.
Und DeepSeek sagt dir sogar, warum, im Q&A, in einem Absatz, über den die meisten hinweggescrollt sind:
"The KV cache management and load balancing components of the inference system are tightly coupled to our internal infrastructure, so that code is not yet fully open-sourced."
(Die Komponenten für KV-Cache-Verwaltung und Lastverteilung sind eng mit der internen Infrastruktur verzahnt, deshalb ist dieser Code noch nicht vollständig Open Source.) "Not yet fully open-sourced" und "now fully open source" sind beides DeepSeek-Sätze, veröffentlicht am selben Morgen. Nur einer davon steht im Tweet.
Die Geheimzutat ist der Cache, und sie sagen es selbst
Genau das macht die Takes nach dem Motto "sie haben ihre Wirtschaftlichkeit verschenkt" falsch. DeepSeek nennt drei Designziele für das System. Ziel drei: "Retain KV cache for more than 72 hours", damit ein wiederholter Prompt den teuren Leseschritt überspringt. Daher kommt günstige Inferenz: Du zahlst nicht zweimal dafür, dieselbe 50-seitige Codebasis zu lesen.
Schau dir an, was diese fehlenden Teile laut Q&A wert sind:
- 155 Billionen Token pro Tag durch einen einzigen Cluster.
- 38 $ Umsatz pro GPU-Stunde, "at valley pricing" (DeepSeeks Rabatt für Nebenzeiten, also vermutlich das untere Ende).
- Die Lastverteilung bringt sie auf etwa 80 % eines perfekt ausbalancierten Benchmarks. Diese Lücke zwischen einem Kasten voller GPUs und einem ausgelasteten Kasten voller GPUs ist das Geschäft.
- Cache-Speicher von 14,4 TB pro GPU, auf Servern mit 20 SSDs zu je 30,73 TB, mit Erasure Coding, sodass beliebige 10 von 11 Nodes antworten können.
Jetzt der Vergleich, den in den Antworten niemand gezogen hat. Google Cloud vermietet eine B200, dieselbe Blackwell-Klasse wie DeepInfers Ziel "SM100", für 4,95 $ pro Stunde als Spot, 7,09 $ mit 3-Jahres-Vertrag und 11,12 $ mit 1-Jahres-Vertrag (Preise heute aktualisiert). DeepSeeks Zahl ist das 3,4- bis 7,7-Fache dessen, was die GPU zur Miete kostet. Umsatz ist nicht Gewinn, und DeepSeek besitzt seine Hardware, statt sie zu mieten, aber diese Spanne ist die Wirtschaftlichkeit. Und die Spanne steckt in den 4 Kästen, die nicht im Repo sind.
Steile These, und ich stehe dazu: @Polymarkets "dramatically reduce the computing costs of running AI models" stimmt für vielleicht 50 Firmen auf der Welt. Hier ist der Grund.
Wer es betreiben will wie DeepSeek, fängt bei 128 GPUs an
Das Q&A ist beim Minimum unverblümt: "the smallest efficient deployment unit is 64 GPUs of prefill plus 64 GPUs of decode." Die Benchmarks der README wurden "measured on 4 SM100 GPUs for prefill and 64 for decode". Decode will EP64 oder mehr (die Experten des Modells verteilt auf 64 bis 128 GPUs). Also habe ich die Rechnung aufgemacht.
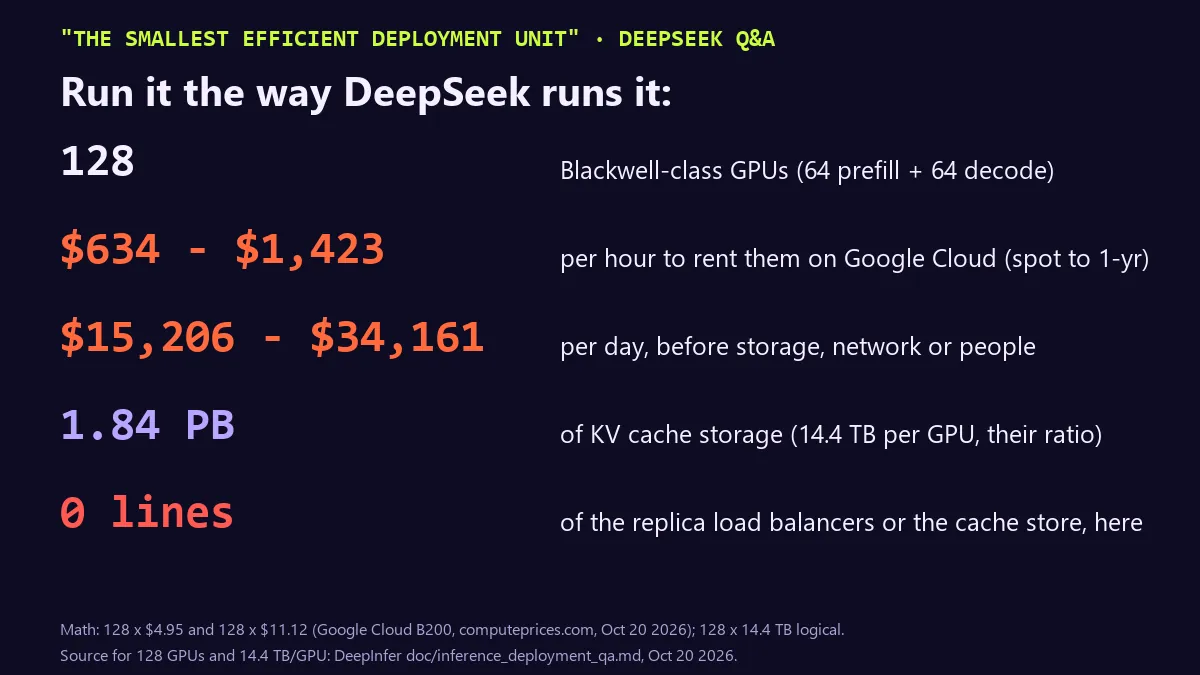
- 128 GPUs x 4,95 $ bis 11,12 $ = 634 $ bis 1.423 $ pro Stunde.
- Das sind 15.206 $ bis 34.161 $ pro Tag, vor Speicher, Netzwerk oder auch nur einem einzigen Engineer.
- 1,84 PB Cache-Speicher bei ihrem Verhältnis von 14,4 TB pro GPU.
- Dazu die Load Balancer und der Cache-Store, die du jetzt selbst schreibst.
Vergleich das mit dem anderen DeepSeek-Thema dieser Woche in der Timeline: Unsloths 1-Bit-V4.1 Flash, von 508 GB auf 250 GB geschrumpft, läuft auf einem Rechner mit 128 GB+ RAM. Das ist das offene Modell, das die meisten tatsächlich anfassen werden. DeepInfer ist für Clouds. Wenn du Indie-Entwickler bist, ist DeepSeeks echtes Geschenk an dich weiterhin die günstige API, nicht dieses Repo.
Das Q&A hat sogar den besten Satz des ganzen Releases. Kann man Prefill und Decode auf verschiedene Rechenzentren aufteilen? Ja, "at some cost in reliability, e.g., the fiber running between data centers is easily severed by construction work." (auf Kosten der Zuverlässigkeit, etwa weil die Glasfaser zwischen Rechenzentren bei Bauarbeiten leicht durchtrennt wird). Respekt. Das ist ein Team, dem schon mal ein Bagger die Woche ruiniert hat.
vLLM sagt "built primarily on vLLM". Ich habe 6,82 % gemessen
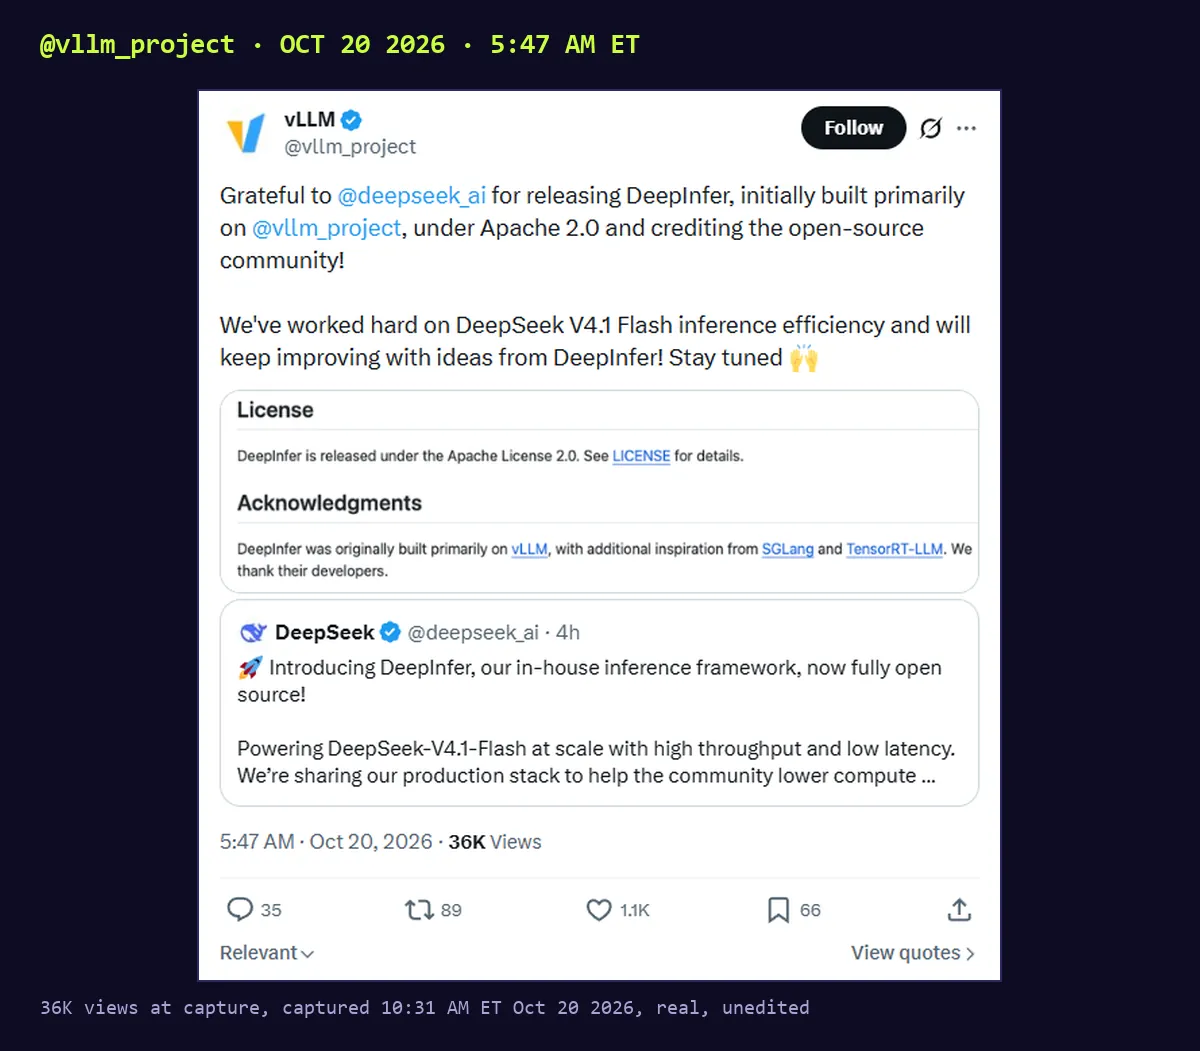
Die andere große Reaktion kam vom vLLM-Team, der Open-Source-Engine, auf der der Großteil der Branche läuft. Ihr Post ist freundlich, und DeepSeeks README sagt tatsächlich, DeepInfer "was originally built primarily on vLLM".
Also habe ich gemessen, wie viel vLLM noch übrig ist. Ich habe DeepInfer (Commit 774ce24) und vLLM in neun Releases geklont, von v0.2.0 (2023) bis zum heutigen main-Branch. Ich habe jede Python-Zeile mit 25+ Zeichen aus DeepInfers Paket deepinfer/ genommen, Kommentare und Leerzeilen entfernt, Leerraum zusammengefasst und jede Zeile auf eine exakte Übereinstimmung irgendwo in jedem vLLM-Release geprüft. Das Skript hat 60 Zeilen Python, lief in etwa einer Minute und brauchte keine GPU.
def norm(l):
    l = l.strip()
    if not l or l.startswith('#'): return None
    if len(l) < 25: return None   # skip trivial lines
    return re.sub(r'\s+', ' ', l)

# every .py file in each vLLM tag, read straight out of git
p = subprocess.run(['git', '-C', VL, 'cat-file', '--batch'],
                   input='\n'.join(f'{ref}:{f}' for f in files).encode(),
                   capture_output=True)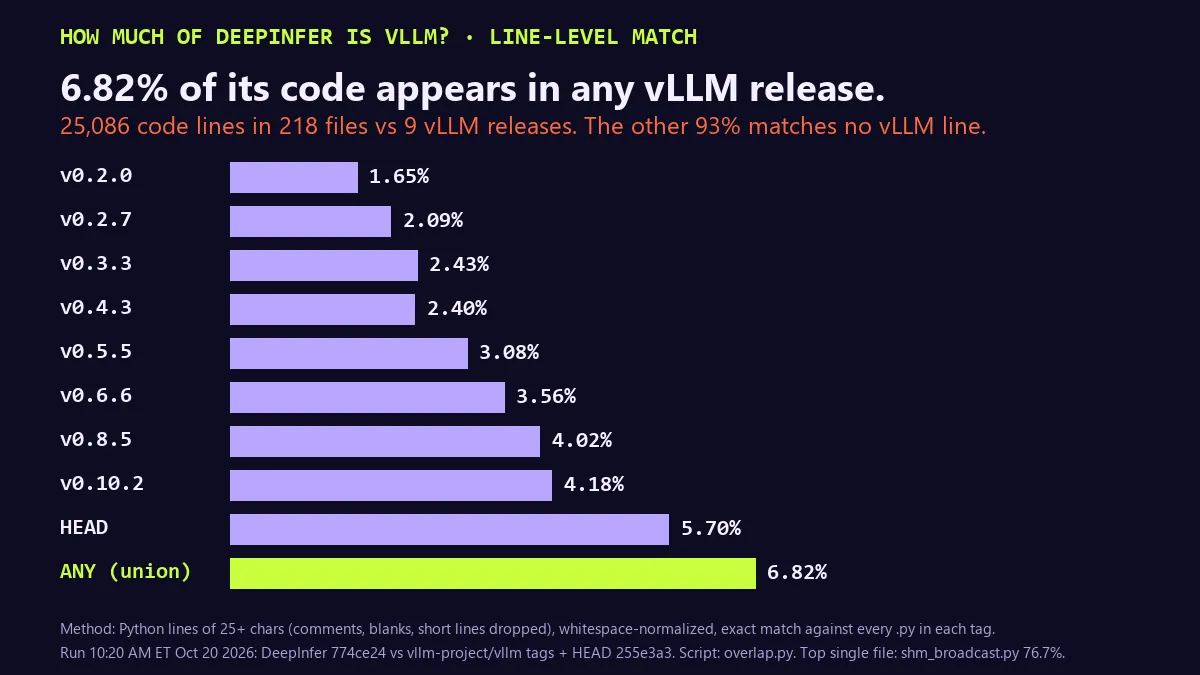
Ergebnis: 1.711 von 25.086 Zeilen (6,82 %) kommen in mindestens einem vLLM-Release vor. Das beste einzelne Release ist der heutige vLLM-main mit 5,70 %, was vor allem heißt, dass beide Projekte dieselben neuen Ideen übernommen haben. Die Datei mit dem meisten vLLM-Anteil ist shm_broadcast.py, eine Message Queue über Shared Memory, mit 76,7 %. Der Engine-Kern llm_engine.py liegt bei 19,2 %. Der Modellcode für V4 liegt bei etwa 5 bis 12 %.
Die Ordnerstruktur sagt noch vLLM: worker/cache_engine.py, sequence.py, model_runner.py. Das sind die Namen, die vLLM 2023 verwendet hat. Aber der Code darin wurde neu geschrieben. Diese Methode übersieht umbenannte Variablen und Refactorings, also betrachte 6,82 % als Untergrenze der Familienähnlichkeit, nicht als Plagiatswert. Meine Lesart: "Built on vLLM" ist, als würde man sagen, ein Wolkenkratzer sei auf dem Parkplatz gebaut, der vorher dort war. Stimmt, ist großzügig, und DeepSeek verdient echte Anerkennung dafür, die anderen 93 % geschrieben zu haben.
52 % mehr Code für Huawei als für Nvidia
Hier ist das, worum es bei dem Release meiner Meinung nach wirklich geht. DeepInfers eigene Kernels (die kleinen GPU-Programme, die die Rechenarbeit machen) liegen in tilelang_ops/, mit einem Backend pro Chip. Dieselben 30 Kernels, jeweils in zwei Versionen. Ich habe die nicht leeren Zeilen gezählt.
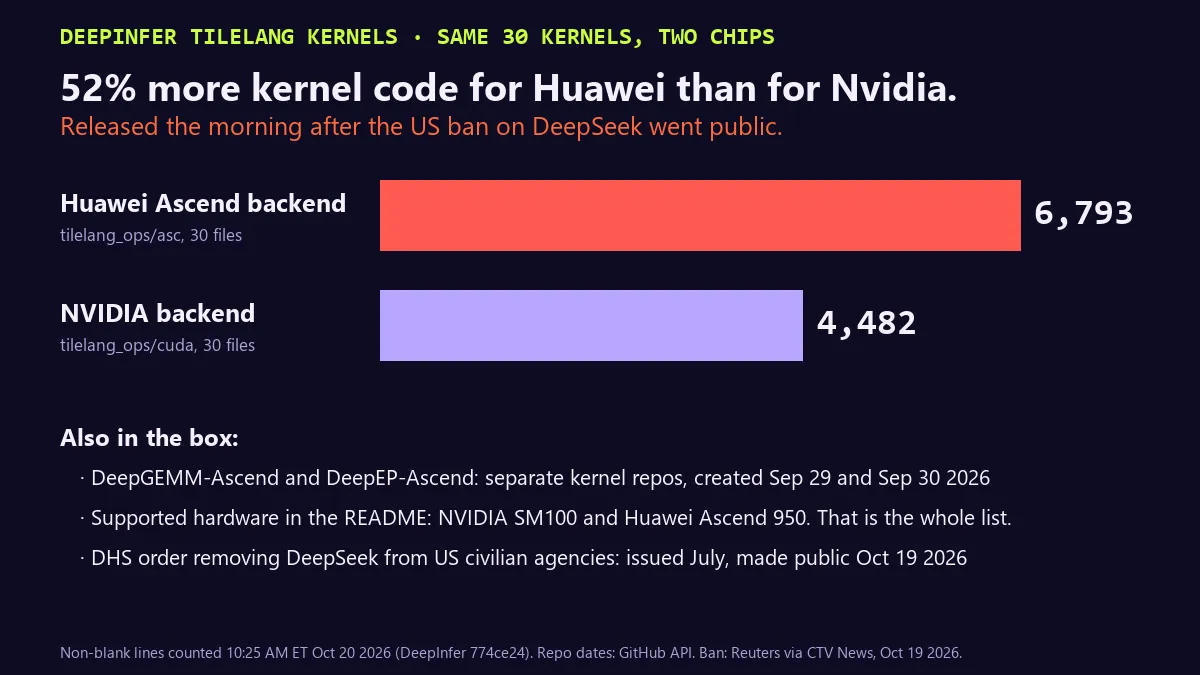
- Huawei-Ascend-Backend: 6.793 Zeilen. NVIDIA-Backend: 4.482. Das sind +51,6 %.
- Unterstützte Hardware laut README: "NVIDIA SM100 GPUs" und "Huawei Ascend 950 NPUs". Das ist die ganze Liste. Keine H100. Kein AMD.
- Die Ascend-Kernel-Bibliotheken kommen als eigene Repos, DeepGEMM-Ascend und DeepEP-Ascend, beide angelegt am 29. und 30. Sep. 2026, drei Wochen vor heute.
- Einen Tag vor dem Release berichtete Reuters, dass das US-Heimatschutzministerium (DHS) zivile Bundesbehörden anweist, DeepSeek-Produkte und Dienste von Drittanbietern, die auf seinen Modellen aufbauen, zu entfernen (erlassen im Juli, am 19. Okt. öffentlich gemacht).
- Am selben Tag berichtete The Information (über @unusual_whales, 149K Aufrufe), dass DeepSeek und Huawei gemeinsam an neuen KI-Chipdesigns arbeiten, um Nvidia herauszufordern.
Ein Teil der +52 % ist schlicht der Preis eines jüngeren Chips: Ascend-Kernels brauchen mehr Handarbeit als CUDA-Kernels. Aber niemand schreibt 6.793 Zeilen für einen Chip, auf den er nicht weiter setzen will. Was meiner Meinung nach wirklich passiert, und das werden sie nie laut sagen: Das ist ein Huawei-Verkaufsdeck mit Apache-Lizenz. Jede chinesische Cloud, die DeepSeek zu DeepSeeks Preisen anbieten will, hat jetzt eine produktionsreife Engine, die auf Chips läuft, die die USA nicht abschneiden können. Am Montag verbannen die USA DeepSeek aus ihren Behörden. Am Dienstag macht DeepSeek sein Modell für alle anderen günstiger zu betreiben, auf Huawei-Silizium. Ehrlich gesagt der am besten getimte Open-Source-Drop des Jahres.
Noch ein Beleg für den Stapel "das ist ein chinesisches Produktionssystem, keine Demo": 1.147 von 40.638 nicht leeren Zeilen im Paket tragen chinesische Kommentare oder Docstrings, etwa """compress 内核固定开启 fast math。""" ("der compress-Kernel schaltet fast math immer ein"). Das hat niemand für einen Launch-Blog geschrieben. Die gesamte Historie besteht aus 3 Commits: ein "initial commit" mit 345 Dateien und 63.326 Zeilen um 0:09 Uhr ET, dann zwei Doku-Updates. Das wurde heute Morgen aus einem privaten Repo exportiert.
Immer noch offener als OpenAI. Das ist der eigentliche Seitenhieb
Fair gegenüber DeepSeek und unfair gegenüber allen anderen: OpenAIs offenes Release war gpt-oss im August 2025, Gewichte unter Apache 2.0 mit Referenzcode. OpenAI, Anthropic und Google haben null Zeilen der Systeme veröffentlicht, die ChatGPT, Claude oder Gemini tatsächlich an zahlende Nutzer ausliefern. DeepSeek hat gerade die Engine veröffentlicht, die Kernels, den Expert-Balancer, einen Tokenizer-Dienst, größtenteils in Rust geschrieben (deepseek-recipe), sein Speicherlayout, seinen Umsatz pro GPU-Stunde und seinen Traffic.
Also such dir deinen Bösewicht aus. Ist es das Labor, das 93 % einer Produktions-Engine ausliefert und es 100 % nennt, oder die Labore, die 0 % ausliefern und sich selbst die Guten nennen?
Das Ranking der heutigen Takes
- Am falschesten: @zephyr_z9, "They literally released the secret sauce behind their economics" (128K Aufrufe). Die Zutat ist ein 72-Stunden-Cache plus vier Load Balancer. Beides wurde nicht veröffentlicht.
- Am falschesten für die meisten Leser: @Polymarket, "dramatically reduce the computing costs of running AI models" (75K). Für alle mit 128 Blackwells und einem Petabyte SSD, klar.
- Am großzügigsten: @vllm_project, "initially built primarily on vLLM". Heute 6,82 %. Nehmt die Anerkennung für das Fundament; das Gebäude gehört DeepSeek.
- Am genauesten: DeepSeeks eigene README. Jemand in diesem Team hat "not included in this release" in klaren Worten hingeschrieben. Der Marketing-Post hat sie nicht gelesen.
Die Zahlen bisher
- Veröffentlichte Kästen in DeepSeeks Routing-/Cache-Schicht: 1 von 5 (EPLB), abgelesen 10:25 Uhr ET am 20. Okt.
- DeepInfer-Zeilen, die in einem der 9 vLLM-Releases vorkommen: 1.711 von 25.086 (6,82 %)
- Kernel-Zeilen, Huawei Ascend gegen NVIDIA: 6.793 gegen 4.482 (+51,6 %)
- DeepSeeks Umsatz pro GPU-Stunde: 38 $ (laut eigenem Q&A) gegen 4,95 $ bis 11,12 $ Miete für eine B200 bei Google Cloud
- Kleinstes effizientes Deployment: 128 GPUs, 634 $ bis 1.423 $ pro Stunde
- Sterne: 8.663 um 10:33 Uhr ET, etwa 10 Stunden nach dem ersten Commit
Meine Wette, und du bist dran
Vorhersage: Bis zum 30. Nov. übernehmen vLLM und SGLang die meisten Tricks von DeepInfer (das Decoding mit Draft-Tokens, das begrenzte SWA-Replay), und US-Clouds liefern V4.1 Flash schneller aus als heute. Und bis zum 31. Dez. betreibt niemand außerhalb Chinas das Modell so wie DeepSeek, mit dem 72-Stunden-Cache und den vier Balancern, weil DeepSeek genau die behalten hat. Wenn ich falsch liege, zeig mir den Cluster, und ich schreibe die Korrektur mit deinem Namen in der Überschrift.
Du bist dran: Ist "fully open source" fair für ein Release, mit dem du keine einzige API-Anfrage bedienen kannst? Ja oder nein, und sag in den Antworten, warum. @deepseek_ai, ihr dürft gern auch antworten.
Willst du sehen, was dich V4.1 Flash über eine API kostet, im Vergleich zur Miete eigener GPUs? Der LLM API Cost Calculator (7 $, Google Sheets + Excel, 26 Modelle) rechnet die Kosten pro Anfrage in einem Sheet durch. Die kostenlose Version gibt es auf der Website unter tensorust.com/tools/llm-api-cost/.
Mehr dazu auf tensorust.com: Meta hat ein 816B-Modell als Open Source veröffentlicht. Es zu betreiben braucht etwa 1 TB RAM, LLM-Proxy-Benchmark: Aus 200 doppelten Aufrufen wurde 1 und Theos 60-%-Statistik ist ein Ausfall-Diagramm.
Methode und Daten: DeepInfer geklont bei 774ce24 (20. Okt. 2026), vllm-project/vllm in den Tags v0.2.0, v0.2.7, v0.3.3, v0.4.3, v0.5.5, v0.6.6, v0.8.5, v0.10.2 und main bei 255e3a3. Alle Zählungen liefen zwischen 10:20 und 10:35 Uhr ET am 20. Okt. 2026. X-Screenshots aufgenommen um 10:31 Uhr ET, echt und unbearbeitet. GPU-Preise von der Google-Cloud-B200-Seite auf computeprices.com, aktualisiert am 20. Okt. 2026.
Zuerst hier auf tensorust.com erschienen am 20. Okt. 2026. Auch auf X (@TensorustAI), X (@MattBusel) und dev.to. Passend dazu: Kostenloser Rechner für LLM-API-Kosten, Metas 816B braucht 1 TB RAM, LLM-Proxy-Benchmark.
Mehr: der Autor, weitere Artikel, teilen, ein kostenloses Spiel
Weiterlesen
Kostenloses Tool: Rechner für LLM-API-Kosten → Eingabe-Token, Ausgabe-Token, Anfragen pro Tag: monatliche Kosten für 24 Modelle von GPT, Claude und Gemini.
- KI · 21. Okt. 2026 · 11 Min. LesezeitLiteLLM hat schon wieder eine Hintertür. Prüf in 5 Minuten, ob deine Keys weg sind
- KI · 19. Okt. 2026 · 13 Min. LesezeitTheos 60-%-Statistik ist ein Ausfall-Diagramm: 43 Stunden Codex-Störungen
- KI · 18. Okt. 2026 · 13 Min. LesezeitExponential Backoff mit Jitter: 64 von 100 LLM-Aufrufen scheiterten trotzdem